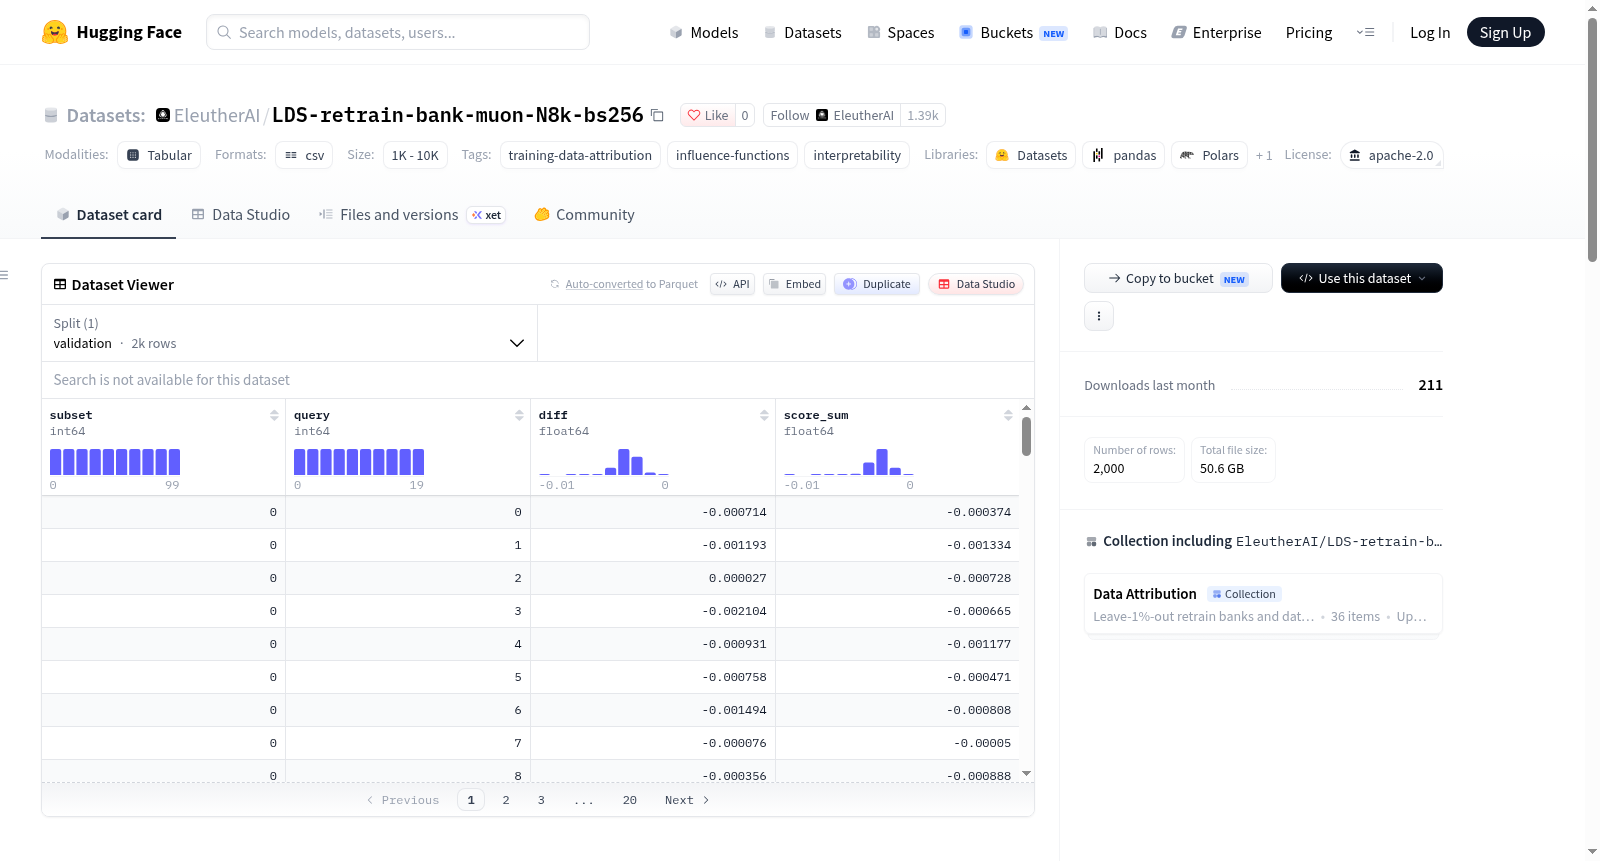
metasmoothness-bank-plan_muon_eps1e17_8k_bs256
收藏资源简介:
该数据集名为 'Retrain bank',由 EleutherAI 发布,旨在为训练数据归因(training-data attribution)研究提供可复用的基准。数据集包含 100 个完全重新训练的语言模型,每个模型都是基于 GPT-2(gpt2)架构,在同一个 8000 文档的语料库(smollm2)上进行微调,但每次随机移除 1%(即 80 个文档)不同的子集,其余文档顺序和种子与基础模型一致。这些模型仅在移除的文档上有所不同,因此可以用于评估各种归因方法的性能。数据集内容包括: - `retrained/base/`:未移除任何文档的微调基础模型; - `retrained/subset_*/`:100 个模型,每个缺失 1% 的不同文档; - `validation.csv`:真实值,记录每个子集移除对每个查询(query)的损失变化(diff); - `subsets.json`:每个子集移除的文档 ID 列表; - `config.yaml`:精确的训练配置; - `filter_proponents_*/`:尾部过滤结果,即当移除某个评分器排名最高的 1% 文档时,查询损失的变化。 数据集适用于评估归因方法,例如通过计算预测的子集影响与真实 diff 之间的 Spearman 相关性(LDS),或使用尾部过滤(tail-filter)测试。数据集已内置了若干基线方法的测量结果,如 MAGIC LDS 为 0.7712,EK-FAC LDS 为 0.3881,metasmoothness 为 0.9962 等。训练配置为:优化器 muon,学习率 0.0002,批大小 256,2 个 epoch,63 步,种子 42。该数据集基于 Apache-2.0 许可证发布。
The dataset is named Retrain bank, released by EleutherAI, aiming to provide a reproducible benchmark for training-data attribution research. The dataset contains 100 fully retrained language models, each based on the GPT-2 (gpt2) architecture, fine-tuned on the same corpus of 8000 documents (smollm2), but with a random removal of 1% (i.e., 80 documents) different subsets each time, while the order and seed of the remaining documents are consistent with the base model. These models differ only in the removed documents, thus can be used to evaluate the performance of various attribution methods. The dataset contents include: - `retrained/base/`: the fine-tuned base model without removing any documents; - `retrained/subset_*/`: 100 models, each missing 1% of different documents; - `validation.csv`: ground truth values, recording the loss change (diff) for each query when each subset is removed; - `subsets.json`: list of document IDs removed for each subset; - `config.yaml`: precise training configuration; - `filter_proponents_*/`: tail filter results, i.e., the change in query loss when removing the top 1% documents ranked by a scorer. The dataset is suitable for evaluating attribution methods, such as by computing the Spearman correlation (LDS) between predicted subset impacts and true diffs, or using tail-filter tests. The dataset has built-in measurements of several baseline methods, e.g., MAGIC LDS = 0.7712, EK-FAC LDS = 0.3881, metasmoothness = 0.9962, etc. Training configuration: optimizer muon, learning rate 0.0002, batch size 256, 2 epochs, 63 steps, seed 42. The dataset is released under the Apache-2.0 license.
数据集概述:metasmoothness-bank-plan_muon_eps1e17_8k_bs256
该数据集由 EleutherAI 发布,许可协议为 Apache-2.0,是一个重训练模型库(Retrain bank),专为训练数据归因(training-data-attribution)和影响函数(influence-functions)研究设计,包含 100 个完全重训练的 GPT-2 语言模型,而非仅提供评分结果。
核心内容
- 基础模型:GPT-2(
gpt2),在 8,000 篇文档的语料库上进行微调。 - 重训练模型:100 个模型,每个模型从相同种子和相同数据顺序出发,随机剔除不同的 1%(80 篇)文档后进行确定性重训练,因此模型之间的差异仅源于被移除的文档。
- 基准模型:位于
retrained/base/,为未剔除任何文档的微调模型。
文件结构
| 路径 | 内容说明 |
|---|---|
retrained/base/ |
无剔除的微调基准模型 |
retrained/subset_*/ |
100 个模型,每个缺失语料库中不同的 1% 文档 |
validation.csv |
真值标签:每个(子集,查询)组合因移除导致的损失变化 |
subsets.json |
每个子集移除的文档 ID 列表 |
config.yaml |
精确的训练配置 |
filter_proponents_*/ |
尾部过滤结果:移除评分器排名前 1% 文档后的损失变化 |
使用方式
可通过 huggingface_hub 的 snapshot_download 下载数据集,读取 validation.csv 获取真值,然后评估自定义归因方法的预测影响力与实测 diff 之间的相关性,计算 LDS(平均每个查询的 Spearman 相关性)。
实测指标
| 指标 | 数值 |
|---|---|
| MAGIC LDS | 0.7712 |
| EK-FAC LDS | 0.3881 |
| metasmoothness | 0.9962 |
| 尾部过滤差值(MAGIC) | 0.03289 nats |
| 尾部过滤差值(EK-FAC) | 0.02258 nats |
| 尾部过滤差值(随机对照) | 0.00012 nats |
训练配置与出处
- 优化器:
muon,学习率0.0002,批大小256,训练2个周期,共63步,随机种子42。 - 语料库:smollm2,共 8,000 篇文档。
- 硬件说明:一个银行的所有重训练在单一 GPU 类型上运行;混合 GPU 类型会改变重训练模型,导致 LDS 偏移约 0.05,大于多数待测效应。
- 生成工具:由 bergson 项目生成。
该数据集的核心价值在于其可复用性:新的归因方法无需任何重训练即可直接在此库上进行评估,为 leave-k-out 归因研究节省了昂贵的计算成本。