XYZ-Aquila-SFT
收藏资源简介:
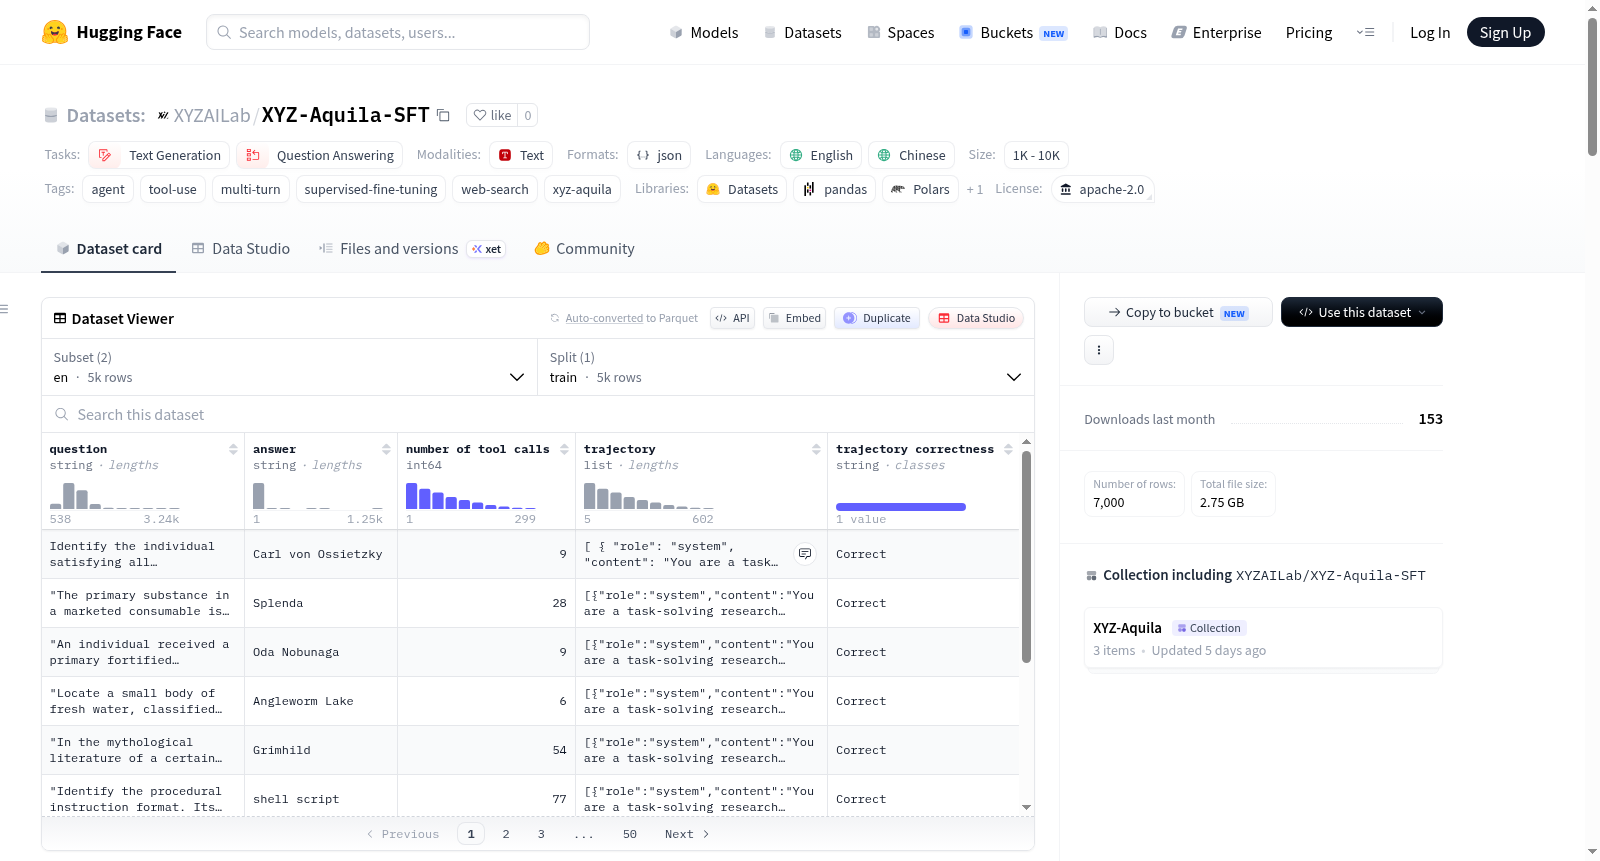
XYZ-Aquila SFT 是一个双语(英语和中文)监督微调数据集,专注于多轮、面向搜索的工具使用轨迹。该数据集共包含 7,000 个高质量样本,其中 5,000 个为英语示例,2,000 个为中文示例。这些数据是用于训练 XYZ-Aquila-mini 和 XYZ-Aquila-pro 模型的更大规模监督微调数据的一个代表性样本。数据以 JSON Lines (JSONL) 格式组织,每种语言对应一个独立的配置文件(en 和 zh)。每个数据样本是一个 JSON 对象,包含五个核心字段:用户请求的“question”、最终答案监督的“answer”、表示轨迹中工具调用次数的“number of tool calls”、记录完整多轮交互序列的“trajectory”(包含系统指令、用户请求、助手推理与工具调用、工具响应以及最终回复等角色消息),以及轨迹级别的正确性标注“trajectory correctness”。轨迹字段以对话兼容的结构序列化了工具调用和观察结果,完整保留了智能体与搜索工具交互的中间过程。该数据集旨在支持以下研究和开发:面向搜索的智能体的监督微调、双语环境下的工具使用和多轮推理能力研究、轨迹格式的实验以及智能体行为分析,以及对中英文搜索任务的受控研究。数据集的部分问答内容源自 `PolarSeeker/OpenSeeker-v1-Data`。用户需注意,数据中的搜索信息可能随时间过时,工具模式可能需要适配其他框架,且该数据集本身并非独立的评估基准。
XYZ-Aquila SFT is a bilingual (English and Chinese) supervised fine-tuning dataset focused on multi-turn, search-oriented tool usage trajectories. The dataset contains a total of 7,000 high-quality samples, including 5,000 English examples and 2,000 Chinese examples. These data are a representative sample of a larger-scale supervised fine-tuning dataset used for training the XYZ-Aquila-mini and XYZ-Aquila-pro models. The data is organized in JSON Lines (JSONL) format, with a separate configuration file for each language (en and zh). Each data sample is a JSON object containing five core fields: the user requests question, the supervised final answer answer, the number of tool calls indicating the count of tool calls in the trajectory, the trajectory that records the complete multi-turn interaction sequence (including role messages such as system instructions, user requests, assistant reasoning and tool calls, tool responses, and final replies), and the trajectory-level correctness annotation trajectory correctness. The trajectory field serializes tool calls and observations in a dialogue-compatible structure, fully preserving the intermediate process of the agents interaction with the search tool. This dataset aims to support the following research and development: supervised fine-tuning of search-oriented agents, studies on tool usage and multi-turn reasoning capabilities in bilingual environments, experiments with trajectory formats and agent behavior analysis, and controlled studies on English and Chinese search tasks. Some question-answer content in the dataset is derived from `PolarSeeker/OpenSeeker-v1-Data`. Users should note that the search information in the data may become outdated over time, the tool patterns may need adaptation to other frameworks, and this dataset itself is not an independent evaluation benchmark.
XYZ-Aquila SFT 数据集概述
数据集简介
XYZ-Aquila SFT 是一个双语监督微调数据集,包含 7,000 条多轮、面向搜索的工具使用轨迹,其中包含 5,000 条英文示例和 2,000 条中文示例。该数据集是用于训练 XYZ-Aquila-mini 和 XYZ-Aquila-pro 模型的更广泛 SFT 语料库的一个样本,记录了代理与搜索工具的交互、中间观察结果以及中英文答案生成过程。
数据集配置
| 配置 | 语言 | 分割 | 文件名 | 示例数量 |
|---|---|---|---|---|
en |
英文 | train |
xyz_aquila_sft_en_5000.jsonl |
5,000 |
zh |
中文 | train |
xyz_aquila_sft_zh_2000.jsonl |
2,000 |
| 总计 | 7,000 |
每种语言分别提供为独立的 JSONL 分片,仓库中不包含合并的重复分片。
数据格式
每条数据为一行 JSON 对象,包含四个顶层字段:
| 字段 | 类型 | 描述 |
|---|---|---|
question |
string | 与轨迹关联的用户请求 |
answer |
string | 最终答案的监督信息 |
number of tool calls |
integer | 轨迹中表示的工具调用次数 |
trajectory |
list | 有序的 system、user 和 assistant 消息,包括工具交互 |
工具定义通过官方 Qwen3 聊天模板中的 tools 块渲染到第一条 system 消息中。工具调用和观察结果被序列化在 assistant 和 user 消息内容中,以自包含的聊天结构保留完整的多轮交互。
工具定义
每条轨迹的第一个 system 消息中包含三个函数模式:
web_searchscrape_and_extract_inforun_python_code
该嵌入块与官方 Qwen3 聊天模板在接收原始系统消息和结构化工具列表时产生的 system 消息内容字节等价。
数据加载
可通过 Hugging Face Datasets 库加载指定语言配置:
python from datasets import load_dataset
english = load_dataset("XYZAILab/XYZ-Aquila-SFT", "en", split="train") chinese = load_dataset("XYZAILab/XYZ-Aquila-SFT", "zh", split="train")
也支持流式加载。
预期用途
该数据集适用于以下研究和开发方向:
- 面向搜索的代理的监督微调
- 双语工具使用和多轮推理
- 轨迹格式实验和代理行为分析
- 英文和中文搜索任务的受控研究
模型基准表现
使用更广泛 SFT 语料库训练出的最终 XYZ-Aquila 模型在中英文代理搜索基准上表现优异:
| 基准 | XYZ-Aquila-mini | XYZ-Aquila-pro (397B-A17B) |
|---|---|---|
| BrowseComp | 78.8 | 84.8 |
| BrowseComp-ZH | 82.9 | 85.1 |
| DeepSearchQA | 89.5 | 92.5 |
| GAIA | 97.1 | 97.1 |
| LiveBrowseComp | 48.7 | 53.7 |
| HLE | 51.1 | 53.3 |
| WideSearch | 80.8 | 81.2 |
所有数值均为百分比。DeepSearchQA 使用 F1,WideSearch 使用 Item F1 Max@4,其余基准使用准确率。这些分数是针对使用更广泛 SFT 语料库训练的发布模型,并非对本 7,000 条示例样本的独立评估。
局限性
- 搜索来源的信息可能过时、不完整或与当前来源不一致
- 工具模式和轨迹约定可能需要适配其他代理框架
- 该数据集不是独立基准,仅在其上训练并不能建立事实可靠性或部署就绪性
- 用户应独立验证生成的答案,并针对预期领域、语言和风险要求评估模型
许可与归属
该数据集以 Apache License 2.0 发布。其中一小部分问答内容来源于 PolarSeeker/OpenSeeker-v1-Data,该数据集以 MIT License 发布。用户有责任遵守与上游内容和搜索轨迹中代表的外部来源相关的适用许可证和条款。