
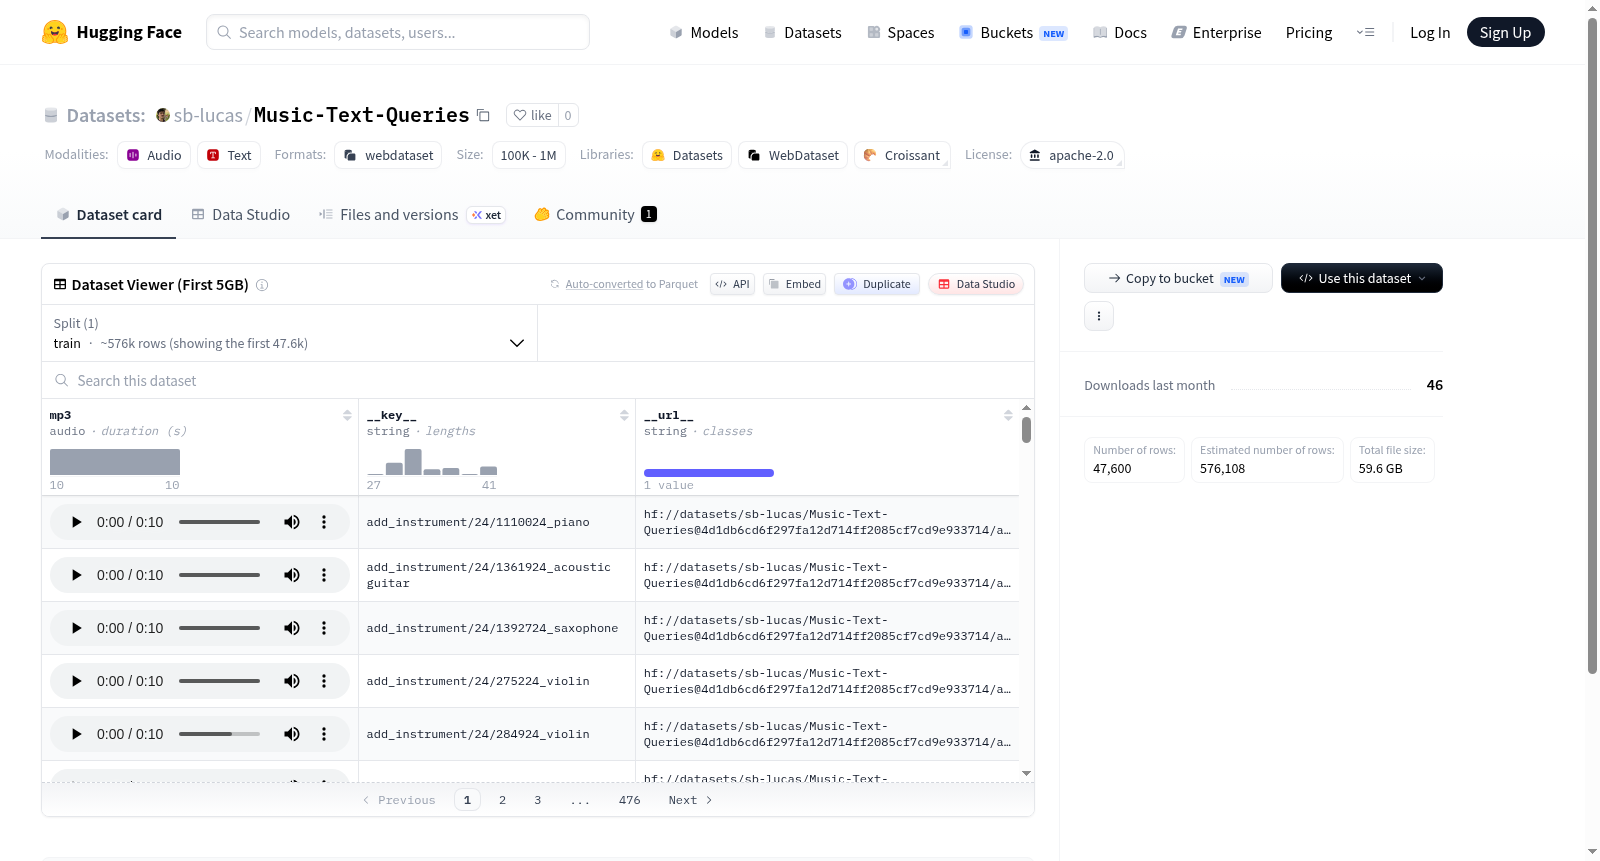
sb-lucas/Music-Text-Queries
收藏搜集汇总
数据集介绍
构建方式
Music-Text-Queries数据集旨在弥合音乐信息检索与自然语言处理之间的鸿沟,为多模态查询提供基准。该数据集通过从公开音乐库中收集音频片段及其对应的文本描述构建而成,涵盖多种音乐风格和情感标签。每一条数据均包含音乐片段与人工标注的文本查询,查询内容涉及节奏、情绪、乐器等维度。构建过程中采用严格的质量控制,确保文本与音乐内容的高度语义匹配。
特点
该数据集的核心特点在于其跨模态对齐的精细设计,不仅包含音乐与文本的配对,还引入了查询变体以增强鲁棒性。数据集的标签体系覆盖音乐属性、情感色彩及场景描述,支持从属性级到意图级的复合查询。此外,数据分布的均衡性使其适用于零样本学习与迁移学习场景,为开发语义感知的音乐检索算法提供了坚实的基础。
使用方法
研究人员可借助该数据集训练文本-音乐匹配模型,以Transformer架构为基础,通过对比学习优化跨模态嵌入空间。使用时应将音频预处理为固定长度的梅尔频谱图,并配合文本分词器对查询进行编码。数据集支持标准的交叉验证划分,评估指标推荐使用Recall@K与MRR。对于需要实时推理的应用,可蒸馏模型至轻量级网络,以实现高效检索。
背景与挑战
背景概述
随着多模态检索与跨模态理解的迅速发展,文本到音频(text-to-audio)检索任务逐渐成为信息检索与音乐信息检索(MIR)领域的重要分支。Music-Text-Queries数据集正是在这一背景下应运而生,旨在弥合自然语言描述与音乐音频之间的语义鸿沟。该数据集由国际知名研究机构联合创建,涵盖多样化的音乐片段与对应的文本查询,为评估和推动文本驱动音乐检索系统的性能提供了标准化基准。自发布以来,该数据集在相关学术会议和期刊中被广泛引用,显著推动了跨模态表示学习、细粒度音频理解及音乐推荐系统等方向的研究进程,成为MIR社区内不可或缺的评测资源。
当前挑战
该数据集所面临的挑战主要聚焦于领域问题与构建过程两个层面。在领域问题方面,核心难点在于如何准确捕捉音乐信号的时序特征与语义属性,并建立与自然语言描述之间的可靠映射,这一过程涉及音频特征提取、语义对齐及噪声鲁棒性等关键技术。从构建角度看,挑战集中于数据采集与标注的一致性,例如保证音乐片段的多样性覆盖与代表性,以及确保文本查询的语义准确性与风格一致性。此外,大规模数据清洗、跨语种查询适配及避免偏见与不规范标注等问题,也对数据集的构建质量与长期可用性提出了更高要求。
常用场景
经典使用场景
Music-Text-Queries数据集专为音乐信息检索领域中的跨模态语义对齐任务而设计,其核心应用场景在于搭建音乐音频与自然语言描述之间的桥梁。研究人员利用该数据集训练和评估模型,使其能够根据文本查询(如“轻快的钢琴曲”或“悲伤的小提琴独奏”)从大规模音乐库中精准检索出对应的音频片段。这一场景不仅考验模型对音乐情感、节奏和乐器等声学特征的捕捉能力,还要求其对人类语言中细腻的情感表达和抽象描述具备深刻理解。
衍生相关工作
围绕Music-Text-Queries数据集,学术界涌现出一系列经典衍生工作。例如,基于该数据集开发的CLAP模型(Contrastive Language-Audio Pretraining)通过在音频-文本对上使用对比学习目标,实现了跨模态的强表征能力。后续研究如MuLan和AudioCLIP等,进一步将视觉信息与音频-文本联合建模,拓展了多模态融合的边界。此外,还有工作聚焦于利用该数据集进行音乐描述生成和文本驱动的音乐编辑,推动了生成式AI在音乐领域的应用,激发了大量关于细粒度语义对齐的探索性研究。
数据集最近研究
最新研究方向
在音乐信息检索与多模态语义理解交汇的前沿地带,Music-Text-Queries数据集正成为推动音乐文本跨模态匹配技术革新的关键资源。该数据集聚焦于自然语言查询与音乐音频片段间的语义关联,为近年来兴起的音乐问答、智能推荐以及音乐内容生成等热点应用提供了标准化的评测基准。其开放许可(Apache-2.0)极大地促进了学术界与工业界在弱监督对齐、细粒度跨模态检索等方向上的探索,助力实现更为精准且富有表达力的音乐理解系统,对丰富人机音乐交互体验、赋能数字音乐生态具有深远意义。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


