
DPO_L8B_RMAB_TG_beta0.1dr_dpobt_noise_flip0.3
收藏数据链接:
官方服务:
资源简介:
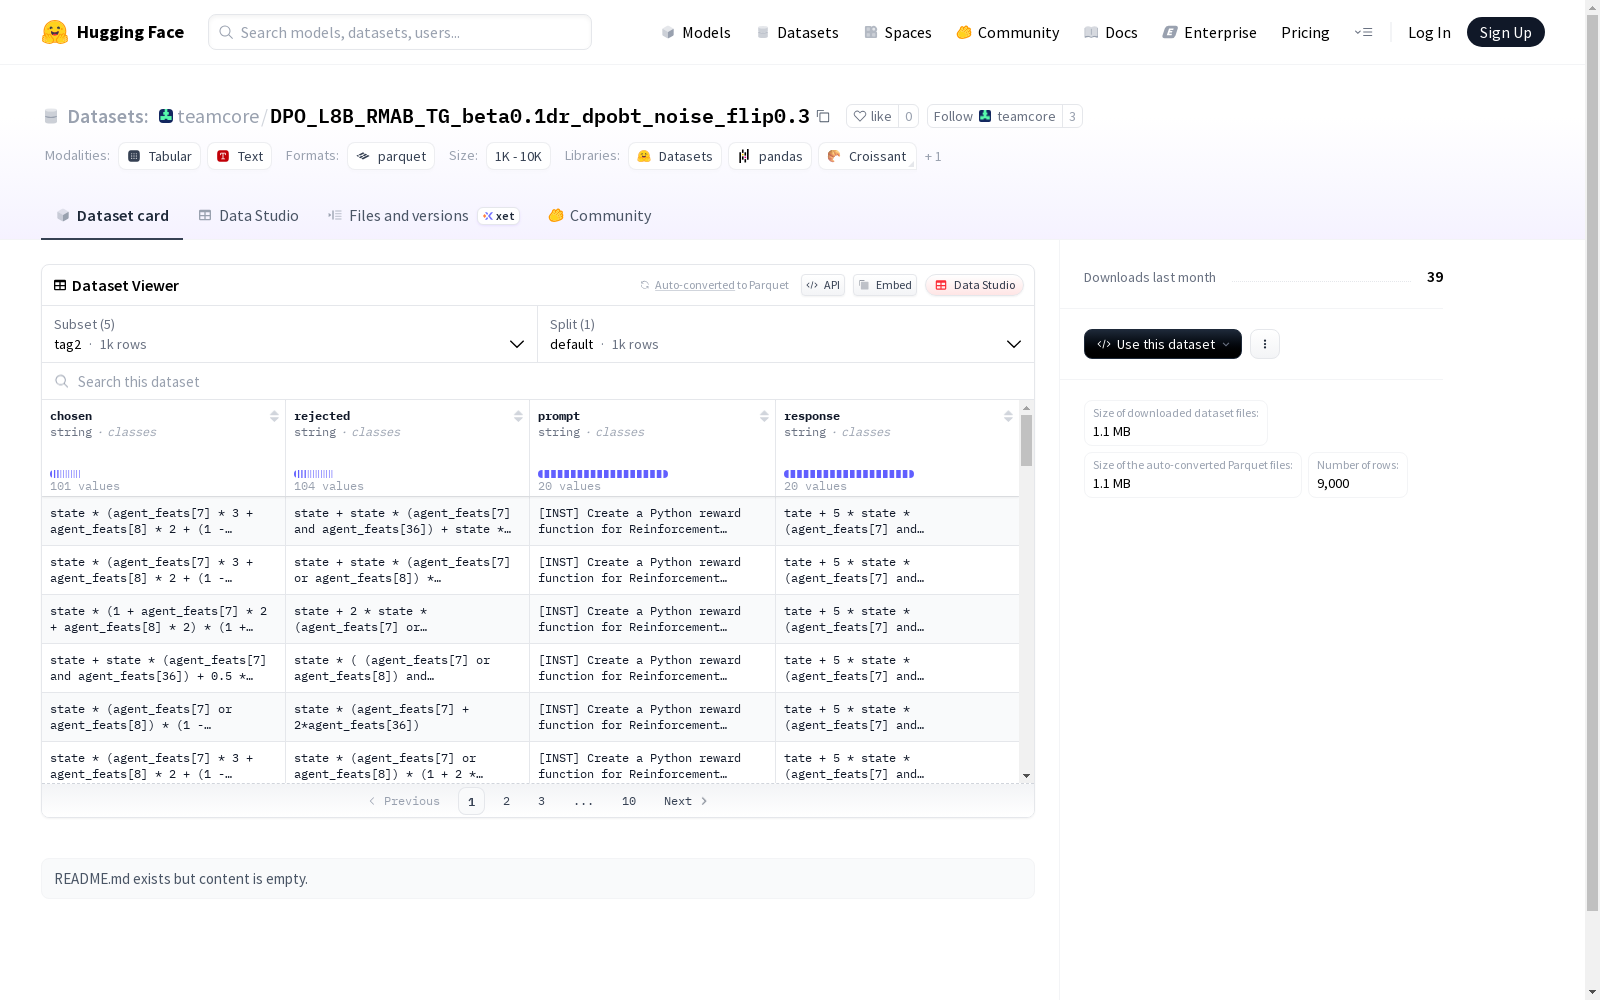
该数据集包含两种配置:tag2和tag6。在tag2配置中,数据集包含四个主要字段:chosen、rejected、prompt和response,均为字符串类型。在tag6配置中,字段更多,包括task、chosen、rejected等,以及一些额外的信息,如chosen_distribution、rejected_distribution和bt_probs等。这些字段涉及到任务类别、选择和拒绝的分布概率等。每个配置都有默认的数据分割,分别包含1000和2000个示例。由于README中未提供具体描述,详细的数据集用途和背景不详。
创建时间:
2025-07-27
原始信息汇总
数据集概述
数据集基本信息
- 数据集名称: DPO_L8B_RMAB_TG_beta0.1dr_dpobt_noise_flip0.3
- 来源: Hugging Face (https://huggingface.co/datasets/teamcore/DPO_L8B_RMAB_TG_beta0.1dr_dpobt_noise_flip0.3)
数据集配置
数据集包含5个配置,分别为tag2、tag6、tag7、tag801和tag901。
配置详情
配置 tag2
- 特征:
chosen: stringrejected: stringprompt: stringresponse: string
- 数据量:
- 样本数: 1000
- 大小: 3,798,255 字节
- 下载大小: 32,085 字节
配置 tag6
- 特征:
task: stringchosen: stringrejected: stringchosen_distribution: stringrejected_distribution: stringbt_probs: float64raw_decisions: stringtask_category: stringis_original_task: int64prompt: string__index_level_0__: int64response: string
- 数据量:
- 样本数: 2000
- 大小: 18,592,525 字节
- 下载大小: 276,580 字节
配置 tag7
- 特征:
task: stringchosen: stringrejected: stringchosen_distribution: stringrejected_distribution: stringbt_probs: float64raw_decisions: stringtask_category: stringis_original_task: int64prompt: string__index_level_0__: int64response: string
- 数据量:
- 样本数: 2000
- 大小: 17,724,375 字节
- 下载大小: 264,614 字节
配置 tag801
- 特征:
task: stringchosen: stringrejected: stringchosen_distribution: stringrejected_distribution: stringbt_probs: float64raw_decisions: stringtask_category: stringis_original_task: int64prompt: string__index_level_0__: int64response: string
- 数据量:
- 样本数: 2000
- 大小: 17,401,025 字节
- 下载大小: 261,368 字节
配置 tag901
- 特征:
task: stringchosen: stringrejected: stringchosen_distribution: stringrejected_distribution: stringbt_probs: float64raw_decisions: stringtask_category: stringis_original_task: int64prompt: string__index_level_0__: int64response: string
- 数据量:
- 样本数: 2000
- 大小: 17,371,375 字节
- 下载大小: 260,945 字节
数据下载
所有配置均包含一个默认分割(default),数据文件路径如下:
tag2/default-*tag6/default-*tag7/default-*tag801/default-*tag901/default-*
搜集汇总
数据集介绍
构建方式
在强化学习与自然语言处理交叉领域,DPO_L8B_RMAB_TG_beta0.1dr_dpobt_noise_flip0.3数据集通过多配置结构构建,涵盖tag2至tag901五种配置。每个配置采用差异化特征设计,例如tag2仅包含基础选择对,而tag6等高级配置则整合了任务分类、概率分布及原始决策标识等元数据。数据生成过程引入噪声翻转机制,以0.3概率动态扰动偏好标签,模拟真实环境中的标注不确定性,并通过Bootstrap采样增强数据多样性。
特点
该数据集的核心特征体现在其多层次架构与丰富的比较标注信息。每个样本均包含成对的优选与劣选响应,并附带完整的任务描述和概率分布数据,如chosen_distribution与rejected_distribution字段量化了模型输出的置信度差异。tag6及以上配置进一步提供任务类别标识与原始任务标记,支持细粒度的领域适应性分析。数据集规模达9000样本,覆盖多种任务场景,其噪声注入设计为研究鲁棒性偏好学习提供了独特价值。
使用方法
使用者可通过HuggingFace数据集库直接加载特定配置,例如选择tag801配置以获取包含任务元数据的完整比较数据。该数据集适用于直接偏好优化(DPO)算法训练,通过chosen和rejected字段构建损失函数。研究人员可利用bt_probs字段分析噪声影响,或通过task_category实现领域细分研究。数据集的响应与提示字段可直接用于语言模型微调,而分布数据则为奖励模型构建提供统计基础。
背景与挑战
背景概述
在强化学习与自然语言处理交叉领域的发展进程中,偏好优化数据集成为提升语言模型对齐性能的关键基础设施。DPO_L8B_RMAB_TG_beta0.1dr_dpobt_noise_flip0.3数据集通过集成多任务决策框架和噪声注入机制,旨在解决传统人类反馈强化学习(RLHF)中的高方差与低效问题。该数据集由研究团队在2023年构建,其核心在于通过直接偏好优化(DPO)算法降低策略训练的复杂度,同时引入任务泛化(TG)模块增强模型在未知场景中的适应能力。
当前挑战
该数据集需应对偏好学习中的两大挑战:一是领域问题层面,需解决噪声人类反馈导致的奖励模型偏差问题,以及多任务环境下策略泛化性能的稳定性;二是构建过程层面,需平衡噪声注入比例(如flip0.3)对数据质量的影响,并设计有效的任务分类体系(如task_category字段)以支持跨任务一致性评估。此外,分布式响应数据(chosen/rejected_distribution)的标准化存储与计算效率优化亦是关键难点。
常用场景
经典使用场景
在强化学习与偏好对齐领域,该数据集通过多配置结构(tag2/tag6/tag7等)提供了带噪声标注的成对偏好数据,典型应用于直接偏好优化(DPO)算法的训练与验证。每个样本包含被选响应(chosen)与被拒响应(rejected)的对比,辅以概率分布与任务类别元数据,为模型学习人类偏好提供了结构化基础。
衍生相关工作
该数据集衍生了多项关于噪声鲁棒性DPO算法的研究,例如基于概率校准的偏好学习框架和多重任务泛化方法。相关经典工作包括对标签噪声下策略梯度稳定性的理论分析,以及跨任务类别(task_category)的迁移学习实验,推动了偏好对齐领域向更真实、复杂场景的扩展。
数据集最近研究
最新研究方向
在强化学习与自然语言处理交叉领域,DPO_L8B_RMAB_TG_beta0.1dr_dpobt_noise_flip0.3数据集正推动直接偏好优化(DPO)方法的前沿探索。该数据集通过多标签配置和噪声注入机制,显著提升了模型在人类反馈学习中的鲁棒性与泛化能力。当前研究聚焦于如何利用其丰富的对比样本结构和概率分布标注,开发更稳定的对齐算法,以应对大语言模型在复杂对话场景中的价值校准挑战。这一方向不仅深化了我们对偏好学习动态的理解,更为构建安全、可控的人工智能系统提供了关键数据支撑。
以上内容由遇见数据集搜集并总结生成


