
MikeGreen2710/dedup_pool_26_03_09
收藏官方服务:
资源简介:
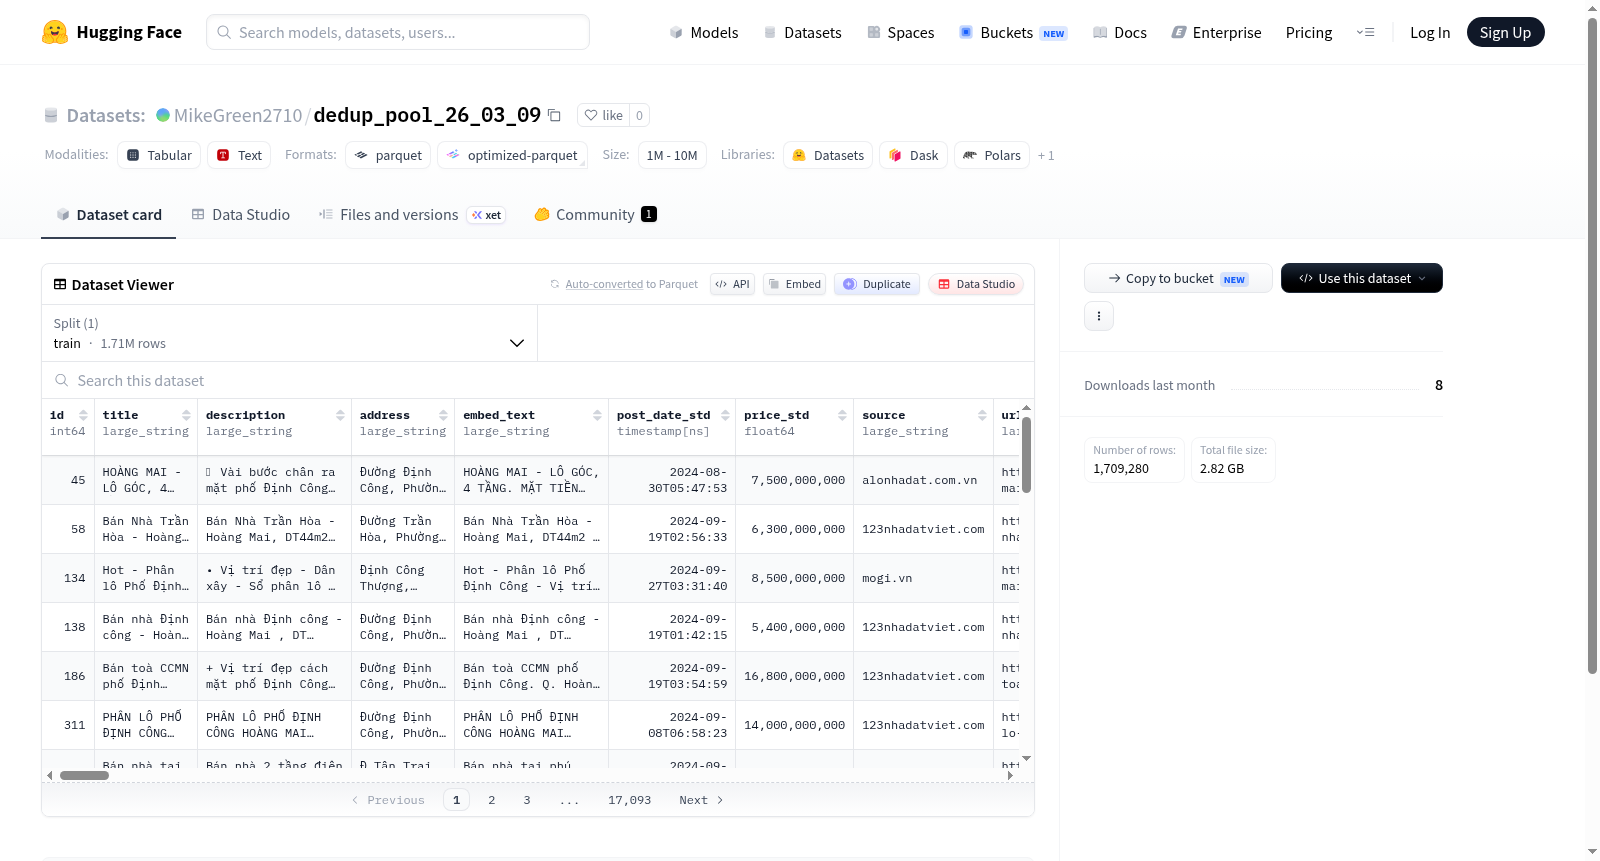
该数据集包含房地产或土地列表信息,涵盖标题、描述、地址、价格、发布日期、地理位置(省、区、街道)、面积指标(如总面积、农业面积、住宅面积)、代理详情(姓名、电话)以及数据解析和去重后的字段。数据集经过标准化和清洗处理,包括地址解析、面积置信度评分和重复项解析,适用于房地产分析、位置建模或机器学习任务。
This dataset contains real estate or land listing information, including titles, descriptions, addresses, prices, posting dates, geographical locations (province, district, street), area metrics (e.g., total area, agricultural area, residential area), agent details (name, phone), and fields resolved from data processing and deduplication. It has been standardized and cleaned, with address resolution, area confidence scores, and duplicate resolution, suitable for real estate analysis, location modeling, or machine learning tasks.
提供机构:
MikeGreen2710搜集汇总
数据集介绍
构建方式
该数据集基于住房租赁与交易领域的多源异构数据构建而成,旨在通过深度清洗与融合技术,形成高一致性、低冗余的结构化房产信息库。构建过程首先从不同爬虫来源采集房源文本、标题、描述及原始地址等元数据,随后利用实体识别与地理编码模型对地址信息进行标准化解析,生成省、市、区、街道的多层级地理标签及置信度评分。在此基础上,系统依据文本嵌入相似度与字段匹配算法识别重复条目,并通过分组投票机制对价格、面积、朝向、楼层等关键属性进行统一归并与校验,最终输出“_resolved”后缀的权威字段以及“_dup_resolved”后缀的融合后字段,从而显著提升数据质量与可用性。
特点
本数据集涵盖170余万条训练样本,包含超过90个字段,是涉房领域细粒度结构信息的典型代表。其突出特点在于多维多源的属性融合:不仅保留了原始ID、URL、经纪人信息等元数据,还通过自然语言处理与地理位置推理,生成了从省级到街道的精确地名标签及其概率分布。此外,数据集中专门设计了“_resolved”与“_dup_resolved”两套字段系统,分别代表经过单源清洗与跨源去重后的最优值,配合重复分组标识(duplicate_group),使得用户能够灵活追溯数据融合路径。同时,该数据集提供了丰富的面积分项(农业、居住、总建筑面积)、建筑特征(门向、楼层、面宽、道路宽度)以及产权范围等指标,为房产估值、供需分析等应用奠定了坚实基础。
使用方法
该数据集以HuggingFace Datasets库的标准格式存储,用户可通过加载“train”分片直接获得完整的DataFrame对象,便于后续的筛选、聚合与建模操作。数据集中所有字段均为预计算后的标准化结果,因此对于研究人员而言,无需重复执行地址解析或重复检测流程,即可直接利用“_resolved”系列字段进行下游任务,如基于多粒度地理特征的房价预测、针对经纪人活跃度的市场分析,或是结合文本嵌入(embed_text)开发房源推荐系统。此外,通过“duplicate_group”字段可轻松构建负样本工程,用于训练去重模型;而“_probabilities”字段则为不确定性量化与主动学习策略提供了天然的监督信号。
背景与挑战
背景概述
在全球城市化进程加速与农业用地资源日益紧张的背景下,精准的土地管理与房地产信息整合成为决策科学化的关键基石。dedup_pool_26_03_09数据集由研究团队为应对多源异构地产与农地数据融合挑战而构建,创建于2026年3月9日,其核心研究问题聚焦于通过高效去重与属性对齐技术,从海量非结构化房源信息中提炼出标准化、可信赖的结构化数据。该数据集整合了超过170万条样本,涵盖价格、面积、方位、楼层、道路宽度等数十项细粒度属性,并引入概率评分与多源校验机制,显著提升了土地与房产数据的精度与可用性,为遥感评估、城市规划、农业经济分析等领域提供了高质量基准数据源,推动了地理空间数据科学在资源管理中的实际应用。
当前挑战
该数据集所解决的核心领域挑战在于多源地产与农地信息的异构性与冗余性。从领域问题看,不同来源的房源描述常包含矛盾、缺失或过时属性,例如面积单位不一致、地址层级混乱、用途标注模糊,传统方法难以自动解析并统一成规范表示,阻碍了跨区域土地价值评估与政策制定的效率。从构建过程看,团队面临两个技术挑战:其一,如何基于文本嵌入、命名实体识别与概率模型实现高精度的重复检测与冲突消解,尤其是在地址别名与属性歧义场景下;其二,如何设计鲁棒的评分与融合策略,以处理不完全一致的属性集合(如部分记录缺省楼高或宅基地面积)并保持一致的分辨率输出,这对数据质量与下游应用的可靠性提出了严苛要求。
常用场景
经典使用场景
在房地产领域的机器学习研究中,dedup_pool_26_03_09数据集为多源房产信息的去重与融合提供了坚实的数据基石。其经典使用场景聚焦于构建高精度的房源实体解析系统,通过整合来自不同平台的挂牌数据,利用地址、价格、面积、户型等多维特征进行记录链接与重复检测,从而形成统一、可信的房产信息视图。该数据集涵盖了从基础属性到结构化地理编码的丰富字段,特别适合训练基于文本相似度、空间位置与属性距离的混合去重模型,是数据清洗与数据治理工作流中的理想评估基准。
解决学术问题
该数据集系统性地回应了房产数据领域长期面临的异构数据整合难题。在学术层面,它解决了多源房源信息中普遍存在的属性冲突、记录冗余与空间漂移问题,通过提供经多轮校验的解析字段,支持研究者量化不同去重算法在真实场景下的精确率与召回率。其意义在于推动了数据融合理论在房地产垂直领域的落地,为实体解析、记录链接与数据质量评估等经典研究问题提供了可复现的标准试验场,揭示了多模态特征融合在非结构化房产文本处理中的关键作用。
衍生相关工作
围绕该数据集衍生出了一系列经典工作,包括基于深度学习的跨平台房源匹配模型、融合地理坐标与文本描述的语义去重方法,以及以该数据集为训练语料的房产属性抽取与标准化流水线。研究者借鉴其多层次特征编码思路,提出了面向低资源场景的小样本去重框架和基于图神经网络的多源信息聚合策略。这些工作不仅在数据管理领域产生了广泛影响,也推动了地理信息科学与自然语言处理的交叉创新,形成了以实体解析为核心的房产智能数据分析范式。
以上内容由遇见数据集搜集并总结生成


