mrcuren/slm-bilanco-financial-qa-tr
收藏资源简介:
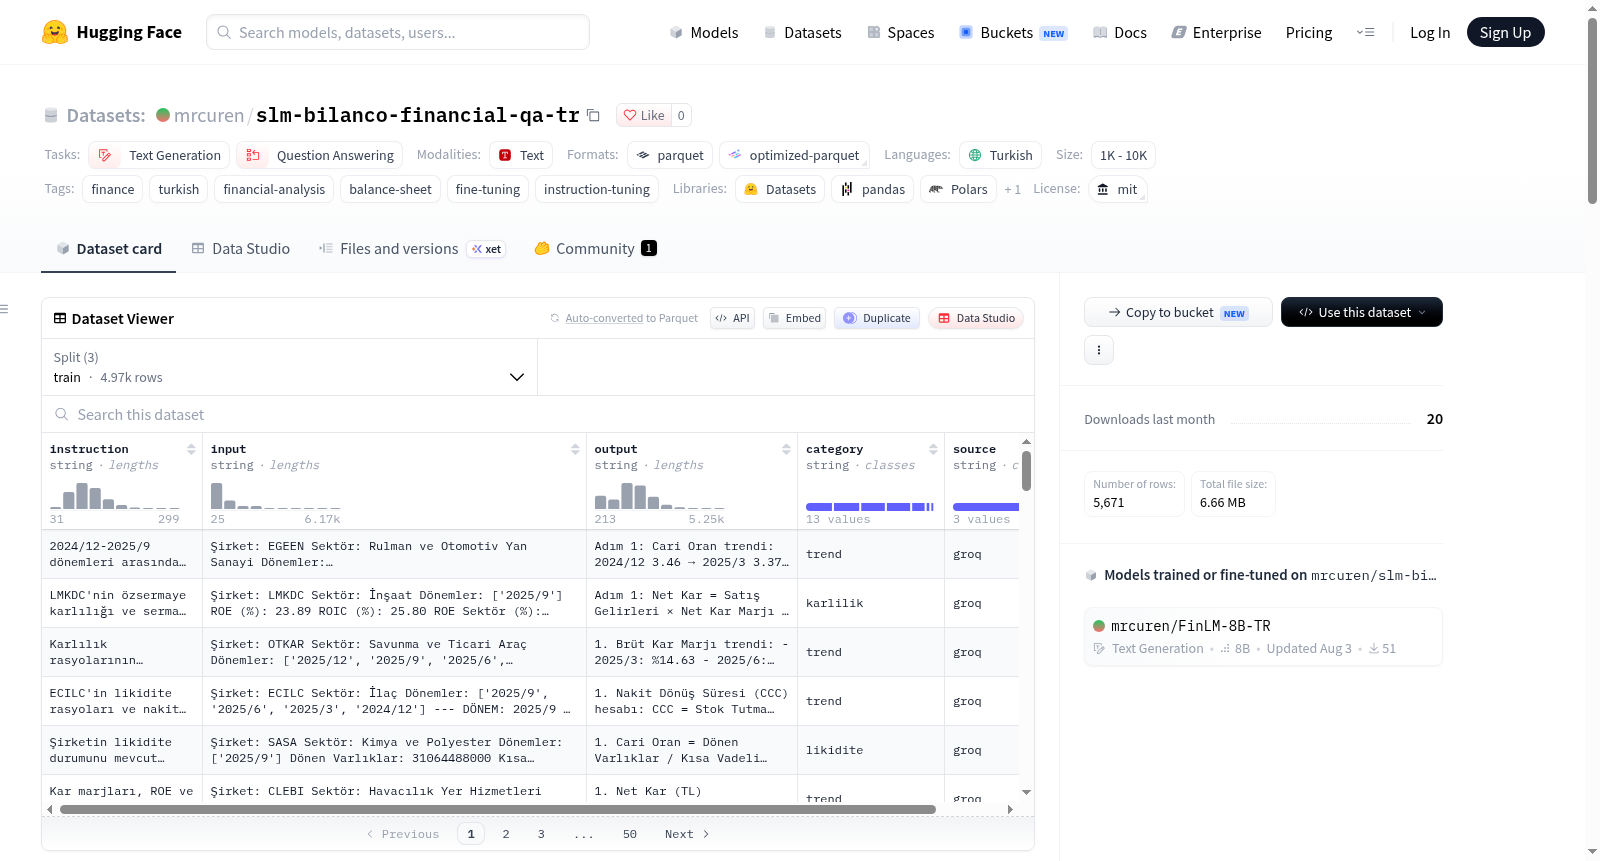
--- language: - tr license: mit tags: - finance - turkish - financial-analysis - balance-sheet - fine-tuning - instruction-tuning size_categories: - 1K<n<10K task_categories: - text-generation - question-answering --- # slm-bilanco-financial-qa-tr Turkce finansal analiz sorulari ve detayli cevaplarindan olusan instruction-tuning veri seti. BIST sirketlerinin bilanco verileri uzerinden olusturulmustur. > **Onemli Uyarilar** > > - Bu veri seti **yatirim tavsiyesi icermez**. Analizler yalnizca egitim ve arastirma amaclidir. > - Icerideki bilgiler ve bilanco degerleri **gercek bilgiler olmayabilir**. Yapay zeka tarafindan uretilmis veya sentetik olarak olusturulmus veriler icerebilir. > - Herhangi bir yatirim karari almak icin kullanilmamalidir. Yatirim kararlari icin yetkili finansal danismanlara basvurunuz. > - Sirket adlari ve finansal metrikler egitim amacli temsili verilerdir; resmi KAP bildirimleri yerine gecmez. ## Kullanim ```python from datasets import load_dataset ds = load_dataset("mrcuren/slm-bilanco-financial-qa-tr") train = ds["train"] val = ds["validation"] test = ds["test"] ``` ## Kategoriler | Kategori | Aciklama | |----------|----------| | likidite | Cari oran, asit-test, nakit orani | | karlilik | ROE, ROIC, net/faaliyet kar marji | | borcluluk | Borc/ozsermaye, finansal kaldirac | | nakit_akisi | FCF, nakit akim analizi | | verimlilik | Stok devir, verimlilik oranlari | | trend | Donemler arasi degisim analizi | | genel_ozet | Yonetici ozeti raporlari | | diger | Diger finansal analizler | ## Veri Kaynaklari | Kaynak | Kayit Sayisi | |--------|-------------| | Gemini augmented | 470 | | Groq augmented | 4.500 | | Seed generated | 550 | | **Toplam (train+val)** | **5.520** | | Test set (2026/3) | 151 | ## Format ```json { "instruction": "THYAO sirketinin Cari Oranini analiz et.", "input": "Donen Varliklar: 428B TL, Kisa Vadeli Yukumlulukler: 425B TL", "output": "## Likidite Analizi...", "category": "likidite", "source": "gemini" } ``` ## Istatistikler - Toplam kayit (train+val): 5.520 - Test set: 151 (2026/3 donemi, Groq ile uretilmistir) - Egitim (train): 4.968 (%90) - Dogrulama (validation): 552 (%10) - Benzersiz sirket sayisi: 80+ - Ortalama cikti (output) uzunlugu: ~300-800 token ## Test Seti Hakkinda Test seti (`test` split) ozel olarak model degerlendirmesi icin olusturulmustur: - **Donem**: Yalnizca 2026/3 (en guncel ceyrek) - **Uretim yontemi**: Groq (openai/gpt-oss-120b) - **Train overlap yok**: Train set ile instruction bazinda capraz kontrol yapilmistir - **7 kategori**: likidite, karlilik, borcluluk, nakit_akisi, verimlilik, trend, genel_ozet - **Senaryo cesitliligi**: %35 stres/negatif, %35 pozitif, %30 notr ## Sorumluluk Reddi Bu veri seti, dogal dil isleme ve buyuk dil modellerinin fine-tuning sureclerinde kullanilmak uzere hazirlanmistir. Veri setinde yer alan: - Finansal analizler, yorumlar ve degerlendirmeler **yatirim tavsiyesi niteliginde degildir**. - Bilanco degerleri ve sirket verileri **gercek finansal tablolari yansitmayabilir**; sentetik veya yapay zeka tarafindan uretilmis olabilir. - Sirket adlari gercek olsa bile, iliskili sayisal veriler **temsili ve egitsel** amaclidir. - Bu veri seti kullanilarak egitilmis modellerin urettigi ciktilar **hicbir kosulda yatirim karari olarak kabul edilemez**. Kullanicilar, bu veri setini kullanarak tum sorumlulugu kabul etmis sayilir.
A Turkish financial analysis question and detailed answer dataset for instruction tuning. Built on balance sheet data of BIST companies.