
遇见数据集

animal-clef-2026

收藏
Hugging Face2026-07-02 更新2026-07-03 收录
官方服务:

资源简介:

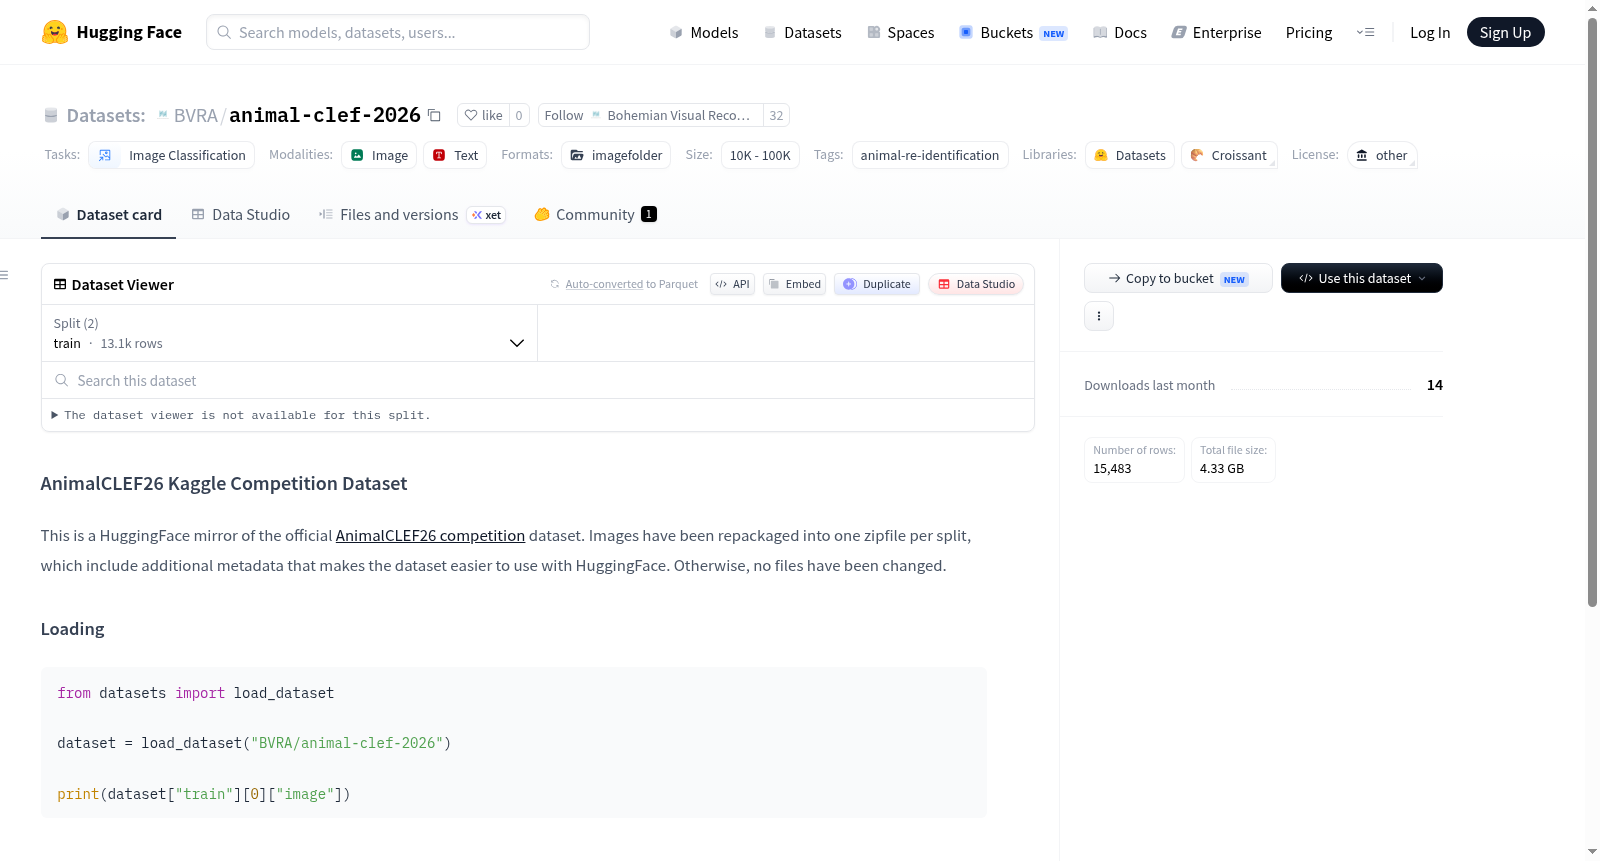
AnimalCLEF26 Kaggle竞赛数据集是官方AnimalCLEF26 Kaggle竞赛数据集的HuggingFace镜像版本,该版本在保留原始数据文件的基础上,增加了Parquet元数据以优化在HuggingFace平台上的使用体验。数据集主要用于图像分类任务,具体聚焦于动物再识别(animal-re-identification)。数据组织包含训练集(train)和测试集(test)两个部分,文件存储路径遵循images/*/train/**和images/*/test/**的模式。用户可通过HuggingFace的datasets库直接加载使用。关于数据集的详细背景、具体内容、规模、字段定义及使用许可等信息,需参考原始的Kaggle竞赛页面和数据文档。

The AnimalCLEF26 Kaggle Competition dataset is a HuggingFace mirror version of the official AnimalCLEF26 Kaggle Competition dataset. This version retains the original data files while adding Parquet metadata to optimize the usage experience on the HuggingFace platform. The dataset is primarily used for image classification tasks, specifically focusing on animal re-identification. The data organization includes training (train) and test (test) sets, with file storage paths following the pattern images/*/train/** and images/*/test/** respectively. Users can directly load and use the dataset via the HuggingFace datasets library. For detailed background, specific content, scale, field definitions, and licensing information, refer to the original Kaggle competition page and data documentation.

创建时间:
2026-07-02
原始信息汇总

数据集概述

  • 名称:AnimalCLEF26 Kaggle Competition Dataset
  • 任务类别:图像分类
  • 标签:动物重识别

数据集结构

该数据集在HuggingFace上以镜像形式提供,图像按分割打包为单个zip文件,包含额外的元数据以便与HuggingFace配合使用,原始文件未经修改。数据集包含以下配置:

  • 配置名称:default(默认配置)
  • 数据文件
    • 训练集data/train.zip
    • 测试集data/test.zip

加载方式

使用以下Python代码加载数据集:

from datasets import load_dataset

dataset = load_dataset("BVRA/animal-clef-2026")

print(dataset["train"][0]["image"])

文档与许可

  • 文档:请参考原始Kaggle数据页面:https://www.kaggle.com/competitions/animal-clef-2026/data
  • 许可:在使用或重新分发此数据集前,请审阅Kaggle竞赛规则:https://www.kaggle.com/competitions/animal-clef-2026/rules#7-competition-data
搜集汇总
数据集介绍
animal-clef-2026 数据集图片
构建方式
动物个体重识别技术是生态学与计算机视觉交叉领域的前沿课题,AnimalCLEF26数据集正是为此竞赛任务而构建。该数据集源自Kaggle官方竞赛,经HuggingFace平台重新打包为镜像版本,以提升用户使用的便捷性。原始图像数据被无损地按训练集和测试集分别封装为独立的ZIP压缩文件,并额外嵌入了便于与HuggingFace数据集库集成的元数据信息,确保了数据完整性与格式兼容性。
特点
该数据集具有鲜明的领域针对性,专攻动物个体重识别任务,属于图像分类范畴。其核心特点在于提供了标准化的竞赛数据划分,包含明确的训练集与测试集,且存储为ZIP压缩格式以降低传输与存储负担。通过HuggingFace的镜像托管,用户可直接利用`load_dataset`接口快速加载,大幅简化了数据获取流程。此外,数据集遵循Kaggle竞赛规则,使用前需确认许可条款,体现了对知识产权的尊重。
使用方法
使用者可通过HuggingFace的datasets库便捷地加载该数据集,只需调用`load_dataset("BVRA/animal-clef-2026")`即可自动获取训练与测试分片。随后,用户能像操作普通数据集一样访问图像与标签信息,例如通过`dataset["train"][0]["image"]`提取首张训练图像。对于更详细的数据说明与使用指南,建议参考原始Kaggle竞赛页面,其中包含了全面的文档与竞赛规则说明。
背景与挑战
背景概述
动物个体重识别(Animal Re-Identification)是计算机视觉与生态保护交叉领域的重要研究方向,其目标是通过视觉特征区分不同个体的动物,为种群监测、行为分析及濒危物种保护提供技术支持。AnimalCLEF 2026数据集诞生于2026年,由BVRA实验室联合Kaggle竞赛平台发布,旨在推动大规模动物个体识别技术的发展。该数据集聚焦于野外复杂环境中多物种的细粒度图像分类,涵盖训练与测试双分卷,并附带丰富的元数据信息。其核心研究问题在于克服传统标志重捕法的局限,利用深度学习实现非侵入式的个体识别。自发布以来,AnimalCLEF 2026已成为动物视觉识别领域的重要基准,对促进生物多样性监测自动化具有深远影响。
当前挑战
该数据集面临的挑战主要体现在三个方面。其一,领域问题的挑战:动物个体在野外场景中常面临光照变化、遮挡、姿态多样及物种间相似性高等因素,导致类内差异小、类间差异大,传统图像分类方法难以有效区分。其二,构建过程的挑战:数据集收集需在自然栖息地进行,涉及隐私、伦理及动物行为干扰等问题,获取大规模标注样本极为困难。此外,不同物种个体的标记一致性要求高,跨时间、跨地点的图像匹配易受环境动态影响,增加了数据清洗与标注的难度。
常用场景
经典使用场景
动物个体再识别(Animal Re-identification)是计算机视觉与生态保护交叉领域中的一项重要任务,其核心目标是从大量图像中精确匹配同一动物的身份。AnimalCLEF-2026数据集专为此任务设计,提供了大规模、多物种的动物图像集合,涵盖训练与测试分片。在经典使用中,研究者通常利用该数据集训练深度卷积神经网络,学习动物的视觉特征嵌入,进而实现跨时间、跨场景的个体匹配。该数据集尤其适用于非受控环境下的图像,挑战包括光照变化、姿态多样性、背景杂乱及个体间相似性高等问题,推动了细粒度视觉识别技术的进步。
衍生相关工作
围绕AnimalCLEF-2026数据集,衍生出一系列经典研究工作。在竞赛推动下,多个团队探索了基于Transformer的视觉模型、自监督学习框架以及混合注意力机制在动物再识别中的表现。部分工作引入时空上下文信息,将图像数据与地点、时间等元数据相结合,提升了复杂环境下的匹配鲁棒性。还有研究聚焦于数据增强策略,如模拟遮挡、光照变换,以增强模型的泛化能力。这些衍进工作不仅丰富了动物视觉识别的方法论,也为通用图像检索与细粒度分类任务提供了可迁移的经验。
数据集最近研究
最新研究方向
当前,动物个体重识别(Animal Re-Identification)研究正以前所未有的速度演进,尤其在生态保护与生物多样性监测领域,基于计算机视觉的非侵入式识别技术已成为前沿热点。AnimalCLEF-2026数据集作为Kaggle竞赛的官方资源,汇聚了大量真实环境中的动物图像,为开发鲁棒性强、泛化能力高的深度学习模型提供了标准化基准。该数据集的最新研究方向聚焦于跨物种、跨场景的细粒度个体识别,结合自监督学习与对比表征技术,以应对野外光照、遮挡及姿态多变等复杂挑战。这一研究浪潮紧密关联全球生态保护重大事件,如濒危物种的种群动态追踪与反盗猎监控,其意义在于推动AI从实验室走向真实生态系统,赋能自动化野生动物普查与个体行为分析,进而为制定科学保护政策提供数据驱动的决策支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

