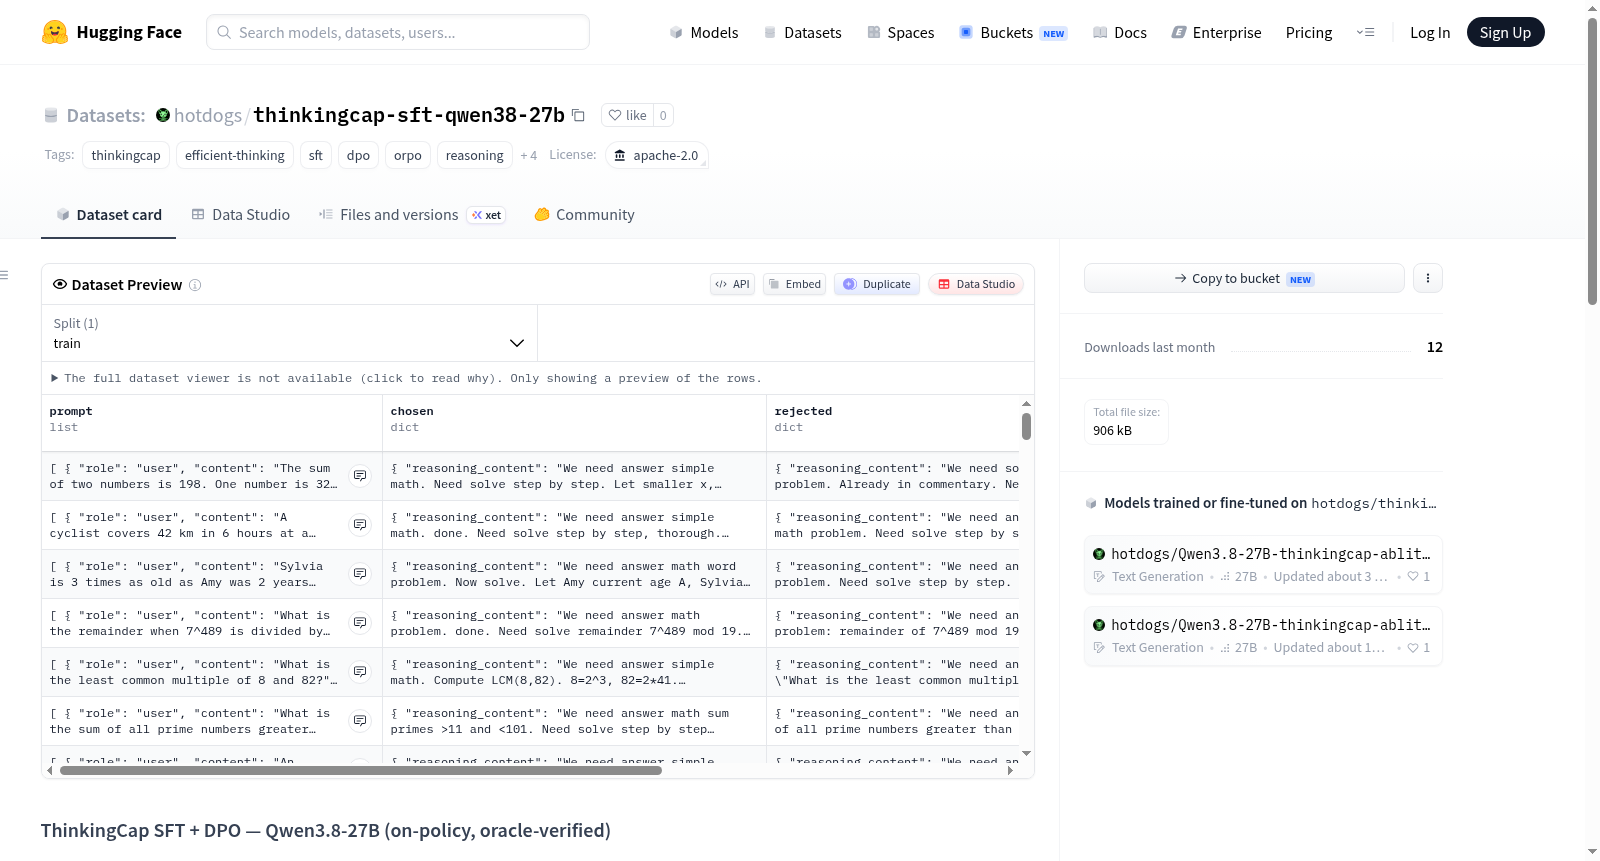
thinkingcap-sft-qwen38-27b
收藏资源简介:
ThinkingCap SFT+DPO Qwen3.8-27B是一个高效的推理数据集,用于训练模型进行token高效思考。该数据集的构建方式与BottleCap的ThinkingCap-Qwen3.6-27B相同,但通过on-policy方式从实时运行的Qwen3.8-27B-abliterated-MTP模型(服务端口:8090/:8091,温度1.0)收集,并经过独立重新计算的oracle验证(正确性由构造保证,而非依赖生成器存储的答案)。数据集包含400个问题,涵盖12个可验证领域,共1350个on-policy样本(每个问题3个样本,温度1.0,两个GPU分片),其中84.2%(1137/1350)被oracle验证为正确。SFT部分包含369行,每个问题选取最短的正确推理;DPO/ORPO部分包含244对,chosen为短正确推理,rejected为长正确推理,平均效率比2.0倍(最高11.2倍)。数据集使用方法:SFT数据(tc_upload_sft.jsonl)采用ChatML格式,每个assistant轮次包含reasoning_content(短且自信)和content,用于学习高效思考风格;DPO/ORPO数据(tc_upload_dpo.jsonl)包含prompt/chosen/rejected,两者均正确但chosen更短,直接教导token效率。此外,数据集提供了每个领域的oracle正确率,例如代数100%、序列100%、代码99.0%、逻辑91.5%、比率85.5%、数论77.4%、组合数学61.9%。数据集基于Qwen3.8-27B-abliterated-mtp-Q6_K模型构建,oracle由独立解析器从问题文本重新计算得出(而非依赖生成器存储的答案)。
ThinkingCap SFT+DPO Qwen3.8-27B is an efficient reasoning dataset for training models to think token-efficiently. It contains 400 problems across 12 verifiable domains, with 1350 on-policy samples (3 samples per problem), of which 84.2% are verified correct by an oracle. The SFT part includes 369 rows, each selecting the shortest correct reasoning per problem; the DPO/ORPO part includes 244 pairs, with chosen being short correct reasoning and rejected being long correct reasoning, achieving an average efficiency ratio of 2.0x. The dataset is built based on the Qwen3.8-27B-abliterated-mtp-Q6_K model, collected via on-policy methods and independently verified by an oracle.
数据集概述
ThinkingCap SFT+DPO — Qwen3.8-27B 是一个面向高效推理(token-efficient reasoning)的文本生成数据集,基于 Qwen3.8-27B 模型,采用策略内采样(on-policy)与独立验证(oracle-verified)方式构建。
基本信息
- 许可证: Apache 2.0
- 任务类别: 文本生成(text-generation)
- 基础模型: Qwen3.8-27B-abliterated-mtp-Q6_K
- 相关模型: hotdogs/Qwen3.8-27B-thinkingcap-abliterated-preview 及其 MTP GGUF 版本
数据规模
- 问题数量: 400 个(覆盖 12 个可验证领域)
- 策略内样本: 1350 条(每个问题 3 条,温度 1.0,来自双 GPU 分片)
- Oracle 验证正确率: 84.2%(1137/1350)
- SFT 行数: 369 条 —— 每个问题的最短正确推理
- DPO/ORPO 对: 244 对 —— chosen 为短正确,rejected 为冗长正确
- chosen 推理平均长度: 342 字符(p90: 607)
- rejected 推理平均长度: 721 字符(p90: 1634)
- 平均效率比: 2.0 倍(最高达 11.2 倍)
数据结构与用途
- SFT 文件 (
tc_upload_sft.jsonl): ChatML 格式,每个 assistant 轮次包含reasoning_content(简短、自信)和content,用于训练高效思考风格。 - DPO/ORPO 文件 (
tc_upload_dpo.jsonl): 包含 prompt / chosen / rejected 三元组,chosen 与 rejected 均正确,但 chosen 更短,直接教授 token 效率。
各领域 Oracle 正确率(独立重算)
| 领域 | 正确数/总数 | 正确率 |
|---|---|---|
| 代数 (algebra) | 234/234 | 100.0% |
| 序列 (sequences) | 114/114 | 100.0% |
| 代码 (code) | 104/105 | 99.0% |
| 逻辑 (logic) | 97/106 | 91.5% |
| 比率 (rates) | 100/117 | 85.5% |
| 数论 (number_theory) | 353/456 | 77.4% |
| 组合数学 (combinatorics) | 135/218 | 61.9% |
较难的领域原始准确率较低,因此提供更多 DPO 对比信号。
构建来源
- 基础模型: Qwen3.8-27B-abliterated-mtp-Q6_K-mixed(7×3090 显卡,GPUs 1-2 与 3-4)
- 阶段 A 基线(温度 1.0): 简单 ~236 / 中等 ~1862 / 困难 ~2014 思考字符
- Oracle 由独立解析器从问题文本重新计算(非生成器存储的答案),因此正确性由构造保证。此方法曾捕获并修复一个质数和 off-by-one 错误(模型回答 1032 实际正确,而原始答案库为 1133)。