
遇见数据集

juppy44/treeoflife_species_identification_reasoning

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

TreeOfLife合成物种识别推理数据集是一个多模态合成数据集,专门用于训练和评估物种识别代理的推理能力。它基于生物学和分类学领域,结合了图像数据和文本信息。数据来源包括:图像元数据来自imageomics/TreeOfLife-200M数据集,生物上下文信息通过英语维基百科API获取,并使用openai/gpt-5.4-mini模型作为教师模型通过OpenRouter生成合成监督示例。生成设置包括扫描2000行源数据,并发数为16,且不保证科学名称的唯一性。输出格式采用特殊标记(如<|REASONING|>和<|FINAL_ANSWER|>)来分隔推理过程和最终答案。数据集的主要列涵盖科学名称、属、通用名称、图像URL、维基百科页面URL、维基百科摘要和全文、教师模型和输出文本、推理内容、最终答案以及是否有必需标签。需要注意的是,生成的数据是合成的,可能存在错误;维基百科匹配不完美;单张图像可能无法实现物种级视觉识别;推理时学生模型不接收维基百科信息;且维基百科文本受Wikimedia许可要求限制,并非自动CC0许可。

TreeOfLife Synthetic Species Identification Reasoning is a synthetic supervised dataset for multimodal species-identification agents, designed to support reasoning tasks in biology and taxonomy. It combines image metadata from imageomics/TreeOfLife-200M, biological context from the English Wikipedia API, and synthetic examples generated by the openai/gpt-5.4-mini teacher model via OpenRouter. The dataset includes columns such as scientific_name, genus, common_name, image_url, wikipedia_page_url, wikipedia_summary, wikipedia_full_text, teacher_model, teacher_output_text, reasoning, final_answer, and has_required_tags. Outputs are formatted with specific tags for reasoning and final answer sections. However, the data is synthetic and may contain errors, Wikipedia matching is imperfect, species-level identification from a single image is often impossible, and Wikipedia text has licensing constraints.
提供机构:
juppy44
搜集汇总
数据集介绍
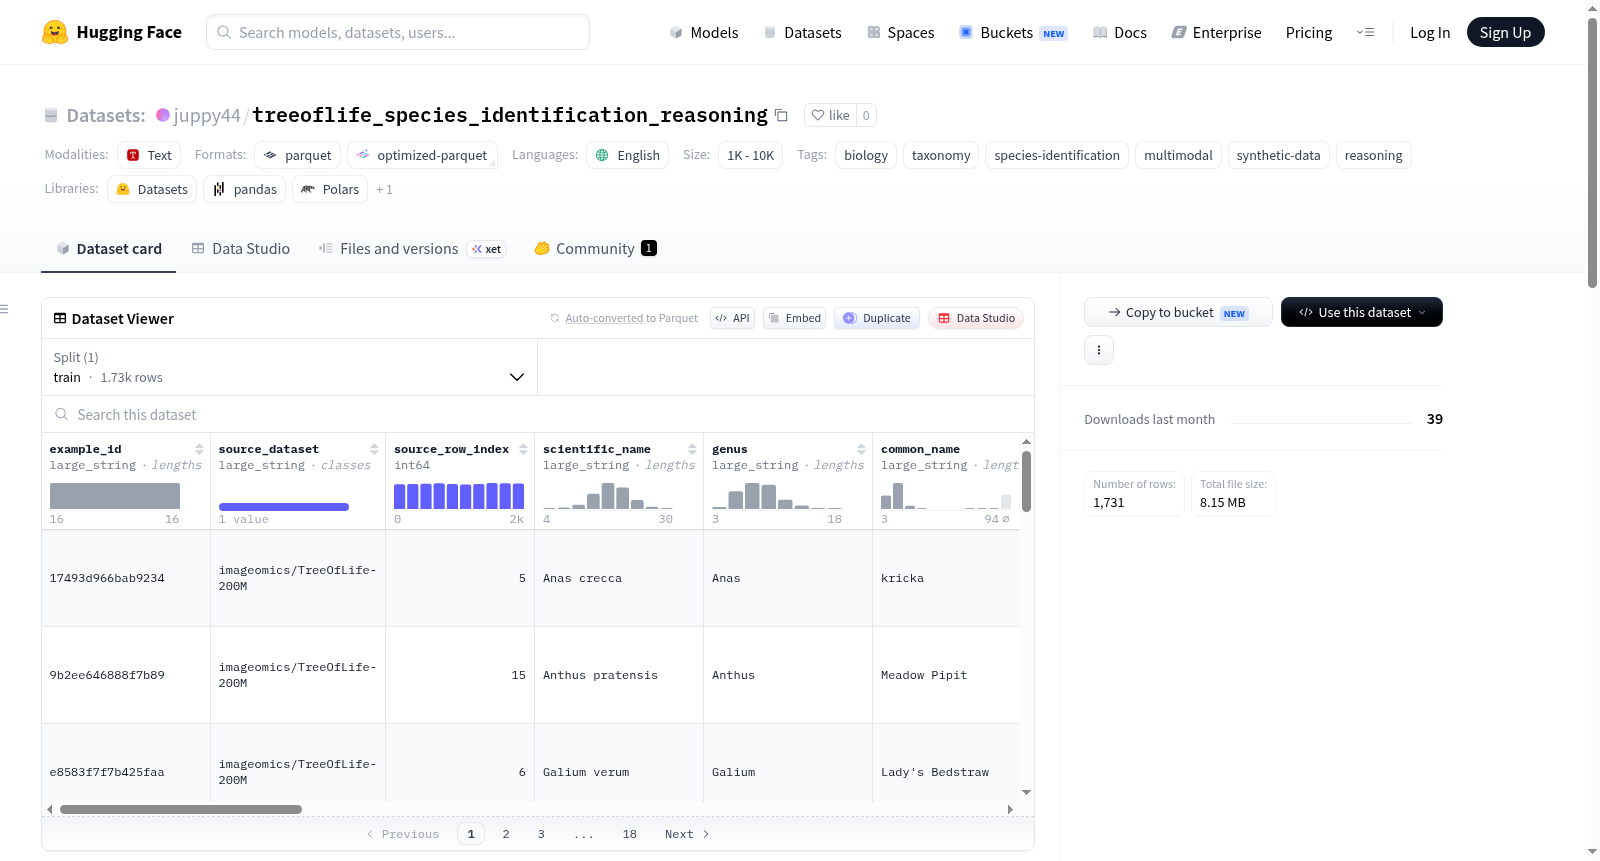
juppy44/treeoflife_species_identification_reasoning 数据集图片
构建方式
该数据集源自`imageomics/TreeOfLife-200M`图像元数据库,通过采样2000条记录,并结合英文维基百科API获取生物分类背景信息,借助OpenRouter平台调用`openai/gpt-5.4-mini`教师模型生成推理与答案。每个训练样本以特定标签结构封装推理过程和最终答案,确保了数据在多模态物种识别任务中的教学一致性。构建过程强调合成数据的可控性,但未对科学名称进行唯一性去重。
特点
数据集以多模态物种识别推理为核心,融合了图像URL、科学名称、属名、常用名以及维基百科摘要与全文等丰富元信息。输出采用结构化标签区分推理链与最终答案,便于模型学习逐步推理。尽管数据合成过程严谨,但维基百科匹配的误差和单图像物种识别的局限性是内在特点,同时数据集明确提示合成内容可能含错误,且学生模型推断时不应依赖维基百科文本。
使用方法
适用于训练和评估多模态物种识别代理的推理能力。使用者可直接利用`image_url`字段获取图像,结合`scientific_name`与`common_name`进行监督学习。推荐将`reasoning`和`final_answer`字段作为目标输出,构建输入图像到结构化推理回答的映射。需注意维基百科文本遵循Wikimedia许可协议,非CC0开源,且模型推理时应避免使用`wikipedia_summary`等字段作为输入特征。
背景与挑战
背景概述
在全球生物多样性面临严峻挑战的背景下,物种识别是生态监测、生物多样性保护和进化生物学研究的基础性任务。传统物种鉴定依赖于专家知识,耗时且难以规模化。随着大规模图像数据集和语言模型的发展,多模态智能体在生物分类学中的应用逐渐成为研究热点。TreeOfLife Synthetic Species Identification Reasoning数据集由Imageomics研究团队创建,基于TreeOfLife-200M图像数据集和维基百科生物文本,利用GPT-5.4-mini模型生成监督训练样本,旨在赋能多模态模型进行物种鉴定与推理。该数据集于2025年发布,聚焦于细粒度物种识别任务,推动计算分类学与多模态推理的交叉融合,为构建可解释、可泛化的生物识别智能体提供了关键的训练资源。
当前挑战
该数据集致力于应对两大核心挑战。在领域问题层面,物种级别的视觉识别极具难度,许多物种仅凭单张图像无法可靠区分,这要求模型具备超越像素级的推理能力,整合文本上下文和生物学先验知识。此外,细粒度分类中的类间差异极小,而类内变异显著,传统分类模型泛化性能不佳。在构建过程中,数据集面临合成噪声与错误传播的挑战:教师模型生成的推理输出可能存在幻觉,维基百科文本匹配不完美且受限于许可证要求。同时,从200万源图像中仅扫描2000行,样本规模有限,且学生模型在推理时无法获取维基百科全文,进一步加剧了多模态对齐与知识迁移的难度。
常用场景
经典使用场景
在生物多样性研究与生态学领域,物种识别往往依赖于专家经验与形态学特征,而TreeOfLife Synthetic Species Identification Reasoning数据集通过多模态合成数据为智能物种识别代理提供了监督学习范例。该数据集最经典的使用场景在于训练视觉-语言联合推理模型,使模型能够基于单一图像与隐含的生物学上下文进行物种鉴别。研究者可借此构建能够模拟分类学家推理过程的智能体,从图像中提取关键形态线索,并结合系统发育关系与地理分布等背景知识进行综合判断。这一范式不仅提升了物种识别的准确率,更在图像信息不充分时引入推理机制以弥补视觉特征的局限性,极大推动了自动化分类学与生物信息学交叉领域的发展。
实际应用
在实际应用中,该数据集为自动化生物监测与生态系统评估提供了强有力的技术支撑。基于该数据集训练的智能识别代理可部署于野外调查相机、无人机遥感平台及公民科学移动应用中,实现对昆虫、鸟类、植物等目标物种的实时鉴别与记录。尤其是当面对稀有物种或图像不清晰的场景时,模型能够通过推理机制调用隐含的生态位知识,例如分布区域、生境类型或同属物种的共性特征,从而做出更为可靠的判断。这种能力极大降低了传统人工鉴定对专家的依赖,加速了生物多样性调查的进程,有助于追踪入侵物种扩散、评估栖息地质量以及支持保护生物学决策。此外,该数据集还可用于开发教育工具,为非专业用户提供具备解释性的物种识别助手,普及分类学知识。
衍生相关工作
围绕该数据集已衍生出多项具有开创性的研究工作。在模型架构层面,研究者借鉴其多模态推理范式,提出了融合视觉编码器与语言解码器的物种识别推理网络,通过在注意力机制中嵌入分类学层级关系,实现了从粗粒度到细粒度的渐进式鉴别。在知识蒸馏领域,相关工作探索了如何将教师模型的推理链压缩为轻量级学生模型的隐式表征,在不牺牲解释性的前提下提升推理效率。此外,该数据集还推动了合成数据质量评估方法的发展,催生了一系列针对教师模型幻觉检测与维基百科匹配鲁棒性的基准测试。这些衍生工作不仅在计算生物学领域产生了广泛影响,也促进了通用多模态推理研究的进步,为构建更强大、更透明的人工智能系统提供了宝贵经验。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

