
AINovice2005/golden-glue-qqp
收藏官方服务:
资源简介:
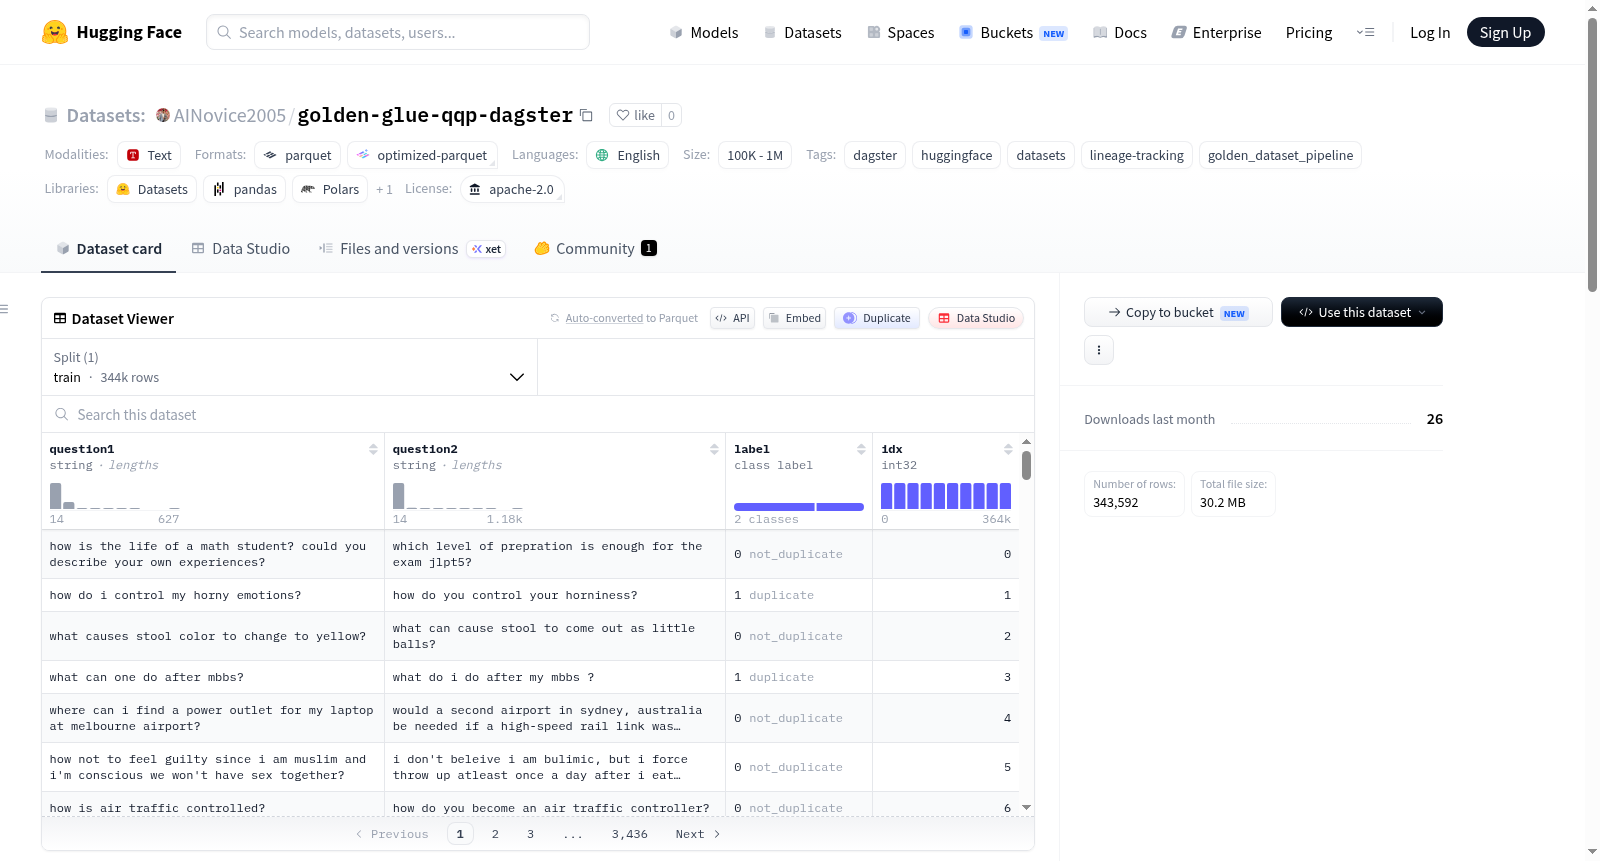
这是一个经过精心处理的GLUE QQP数据集,专门用于重复问题检测任务。数据集来源于nyu-mll/glue的QQP子集,并应用了去重、过滤和规范化等处理步骤:移除了重复的问题对、过滤了格式错误的示例、删除了过短的问题,并对文本格式进行了规范化。数据集包含343,592个训练样本,每个样本包含两个问题(question1和question2)、标签(0表示非重复,1表示重复)和索引。
Curated GLUE QQP dataset with deduplication, filtering, and normalization applied, specifically designed for duplicate question detection tasks. The dataset is derived from the QQP subset of nyu-mll/glue and includes processing steps such as removing duplicate question pairs, filtering malformed examples, eliminating short questions, and normalizing text formatting. It contains 343,592 training examples, each with two questions (question1 and question2), a label (0 for not_duplicate, 1 for duplicate), and an index.
提供机构:
AINovice2005搜集汇总
数据集介绍
构建方式
golden-glue-qqp数据集源自经典的GLUE基准中的QQP(Quora Question Pairs)任务,旨在通过精细化的数据清洗流程构建高质量的问句对匹配数据集。其构建过程涵盖多重严谨步骤:首先,去除原始数据中重复的问句对,消除冗余信息;其次,剔除格式异常或内容残缺的样本,确保每条数据完整可用;接着,过滤掉长度过短的问句,保留语义丰富的有效对;最后,对问句文本进行统一的格式规范化处理,提升数据一致性。整个流水线由dagster-hf-datasets框架驱动,并启用血缘追踪机制,保障数据处理的可复现性。最终数据集包含约34.4万条训练样本,每条记录由两个问句(question1、question2)及其标签(是否语义等价)构成。
使用方法
该数据集的使用极为便捷,依托Hugging Face的datasets库即可一键加载。用户仅需调用`load_dataset("AINovice2005/golden-glue-qqp")`,系统会自动下载并返回包含训练集(train)的Dataset对象。加载后,可直接通过键名`question1`、`question2`访问问句文本,通过`label`获取二分类标签(0表示非重复,1表示重复)。数据集适合直接用于文本语义匹配、问句相似度计算或自然语言推理等任务。此外,由于数据集已内置分割信息,用户无需手动划分,可直接用于模型训练与评估。
背景与挑战
背景概述
在自然语言处理领域,句子对语义等价性判断是核心任务之一,广泛应用于问答系统、信息检索与对话引擎。golden-glue-qqp数据集诞生于2026年,由AINovice2005研究团队基于纽约大学与华盛顿大学联合推出的GLUE基准中的QQP子集构建,旨在为复述检测提供高质量训练样本。该数据集通过去重、过滤与文本规范化等精细处理,解决了原始数据中噪声较多的问题,从而提升了模型对语义等价性判别的鲁棒性。作为GLUE体系的重要补充,它推动了自然语言理解任务中数据质量标准的演进。
当前挑战
该数据集所解决的领域挑战在于:复述检测任务需要模型精确区分语义等同的句子对与含义相异但表面相似的对子,而原始QQP数据中的重复示例、短文本噪声及非标准化格式常导致模型过拟合或泛化能力不足。在构建过程中,研究人员面临多重困难:需设计高效算法识别并移除343592条训练样本中的重复问句对,过滤掉缺失或格式异常的坏例,同时剔除过短问答片段以保证语义完整性,最后通过统一的文本规范化策略消除拼写与语法差异,这一系列操作在保持数据规模与提升质量间需精确平衡。
常用场景
经典使用场景
在自然语言处理领域,语义等价性判别是一项基础而关键的任务。golden-glue-qqp 数据集作为经典 GLUE 基准中 QQP 子集的精炼版本,专为训练和评估基于深度学习的文本匹配模型而设计。其核心应用场景在于判断两个自然语言问句是否表达了相同的语义意图,研究人员常将其与 BERT、RoBERTa 等预训练语言模型结合,通过微调范式来衡量模型在句对语义理解上的泛化能力。该数据集经过去重与规范化处理,确保了训练样本的高质量与低噪声,成为开发轻量级语义匹配系统的理想起点。
解决学术问题
该数据集直面自然语言理解中问句重复检测这一经典学术难题。原始 QQP 数据集中混杂的噪声样本与格式不一给模型训练带来偏差,golden-glue-qqp 通过系统性去重、过滤畸形样本及文本归一化,解决了因数据质量低下导致的性能瓶颈问题。其核心贡献在于为探究语义等价性提供了更可靠的实验基准,助力研究者剥离数据混杂因素,专注于模型架构对深层语义捕捉能力的改进,进而推动文本对分类、信息检索等学术分支的严谨演进。
实际应用
在真实商业场景中,重复问题检测是提升用户体验与系统效率的关键技术。golden-glue-qqp 数据集训练出的模型可直接部署于问答社区、在线客服系统及搜索引擎,用于自动合并语义一致的用户提问,减少人工重复劳动。例如,在大型论坛中,该模型能高效识别本质相同的咨询帖,辅助知识库去重;在智能助手领域,则可确保相似问题触发统一解答流程,从而优化服务响应速度与资源利用率,实现智能化运营。
数据集最近研究
最新研究方向
在自然语言处理领域,golden-glue-qqp数据集作为GLUE基准中QQP任务的精炼版本,聚焦于重复问题检测这一核心语义匹配任务。该数据集通过去重、过滤异常样本、剔除短文本以及统一文本格式等清洗流程,显著提升了数据质量与标注一致性,为构建高鲁棒性的文本对表示学习模型提供了可靠基础。当前前沿研究方向包括利用对比学习、提示微调等范式提升模型在细粒度语义等价判断上的泛化能力,同时结合大语言模型的可解释性分析,探索噪声数据对模型偏见与公平性的影响。这一精炼数据集的出现,呼应了学界对更干净、更可控评估基准的迫切需求,有助于推动跨句语义理解技术的实质性进步,尤其在智能客服、信息检索等真实场景中具有重要应用价值。
以上内容由遇见数据集搜集并总结生成


