tunisian-nlp-resources
收藏资源简介:
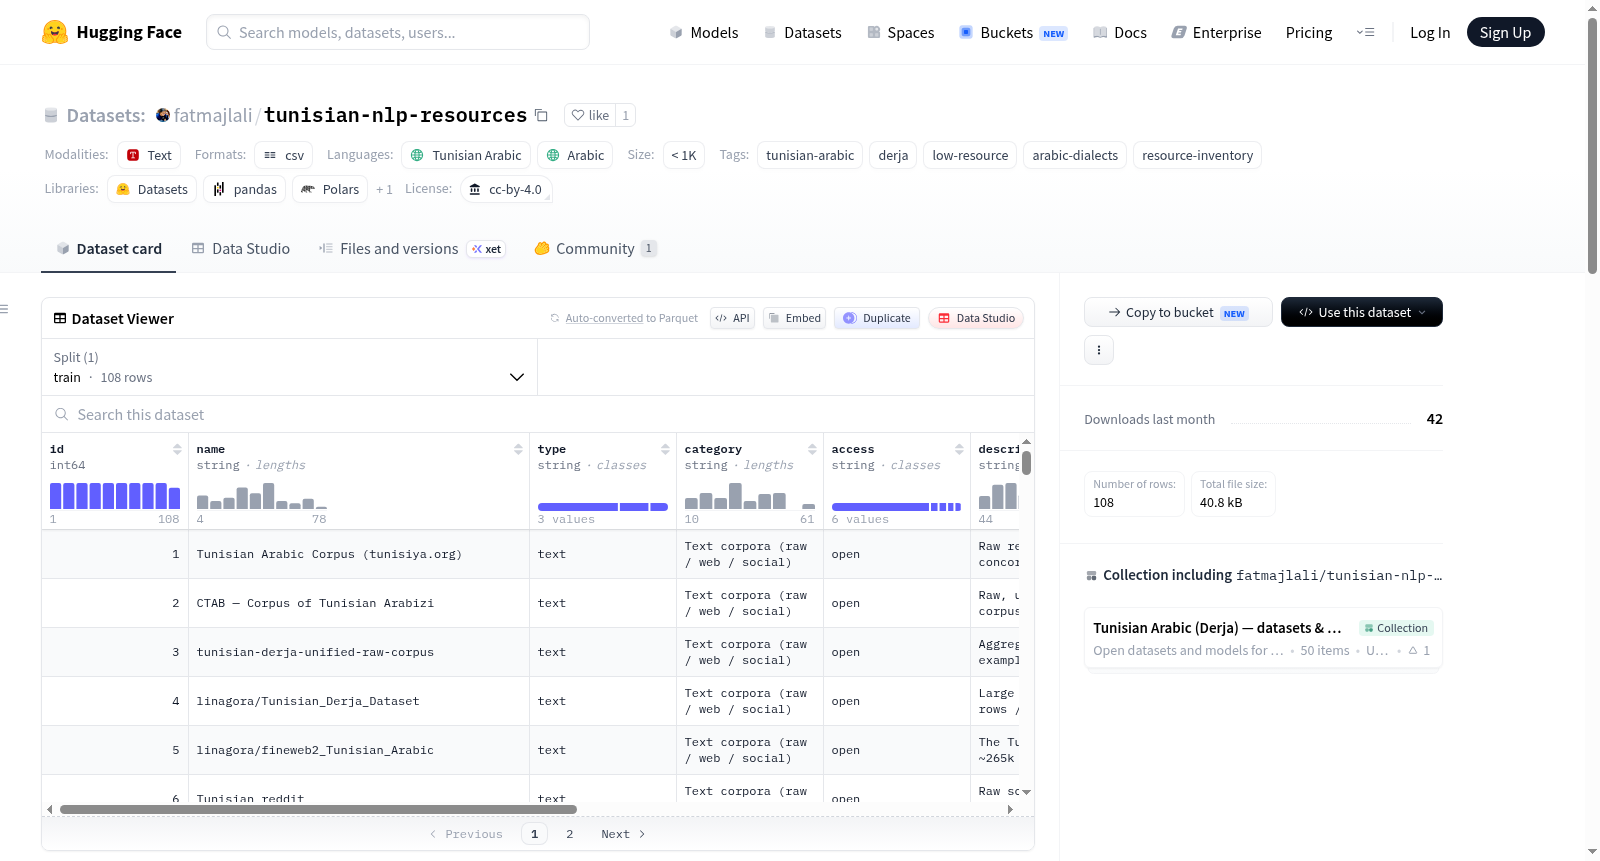
该数据集是一个经过访问验证的突尼斯阿拉伯语(Derja)NLP 资源清单,收录了包括数据集、语音语料、模型和基准测试在内的多种资源。每个资源都标注了其可获取性状态,如开放获取、需请求、付费、仅论文、门控、商业等。数据集以 CSV 格式提供,包含 108 行记录,其中 100 个为单独标记的资源,7 个为分组条目(组内各子项访问状态不同,标记为“varies (grouped entry)”),1 个为纯交叉引用。数据字段包括:编号(id)、资源名称(name)、类型(text / speech / model)、类别(category,如情感分析、方言识别、语音识别等)、访问状态(access)、一句话描述(description)、规范链接(url)和来源文件(file)。该数据集旨在帮助研究人员快速了解突尼斯阿拉伯语 NLP 资源的可用性,适用于低资源语言研究、资源调查、NLP 工具开发等场景。注意:该数据集仅为资源索引,不包含实际数据;访问状态由人工核实,可能随时间变化。权威版本维护在 GitHub 上,此 CSV 为查询和过滤的辅助视图。
This dataset is an access-verified inventory of Tunisian Arabic (Derja) NLP resources, including datasets, speech corpora, models, and benchmarks. Each resource is annotated with its accessibility status, such as open access, request required, paid, paper-only, gated, commercial, etc. The dataset is provided in CSV format, containing 108 rows, of which 100 are individually labeled resources, 7 are grouped entries (with varying access statuses marked as varies (grouped entry)), and 1 is a pure cross-reference. Data fields include: id, name, type (text/speech/model), category (e.g., sentiment analysis, dialect identification, speech recognition, etc.), access status, description, canonical URL, and source file. The dataset aims to help researchers quickly understand the availability of Tunisian Arabic NLP resources, suitable for low-resource language research, resource surveys, NLP tool development, etc. Note: This dataset is only a resource index and does not contain actual data; access statuses are verified manually and may change over time. The authoritative version is maintained on GitHub, and this CSV is an auxiliary view for querying and filtering.
突尼斯阿拉伯语(Derja)NLP 资源数据集
数据集概览
本数据集是一个经过访问验证的突尼斯阿拉伯语自然语言处理资源清单,覆盖数据集、语音语料库、模型和基准测试。每条资源均经过人工核查,标注其实际可获取性(开放获取、需申请、付费、仅论文等形式)。
基本信息
- 许可证: CC-BY-4.0
- 语言: 突尼斯阿拉伯语(aeb)、阿拉伯语(ar)
- 名称: Tunisian Arabic (Derja) NLP Resources
- 资源规模: n<1K(共108行数据)
- 数据文件:
resources.csv
内容构成
数据集包含 108 行记录,具体可分为:
- 100 个独立标注的资源条目
- 7 个分组条目(标注为
varies (grouped entry),子项访问状态不同) - 1 个纯交叉引用(无自身访问状态)
完整 GitHub 清单共包含 138 个标题(含研究人员和实验室)。多方言资源仅记录其中突尼斯阿拉伯语部分,而非整份资源。
数据列说明
- id: 行号
- name: 资源名称
- type: 文本/语音/模型
- category: 资源类别(情感分析、方言识别、自动语音识别等)
- access: 访问状态(开放/需申请/付费/仅论文/受限/商业/分组/未标记)
- description: 一行摘要
- url: 资源的权威链接
- file: 来源清单文件
数据用途与限制
- 本数据集仅索引资源,不重新分发资源本身。
- 访问状态为人工核实,链接可能存在失效风险。
- 对不确定的突尼斯方言覆盖情况加以标注而非剔除;经核查不含突尼斯方言数据的资源在 GitHub 上以“确认负面”记录,而非直接省略。
- CSV 是 Markdown 清单的有损投影:
- 分组条目的个别子项访问状态仅存在于 Markdown 原文中(其中一个受限资源因此未体现为独立值)
- 少数资源因跨类别交叉引用而出现两次
权威来源
- GitHub 维护仓库: https://github.com/jjlalli/Tunisian-Derja-NLP-Resources (权威版本,通过 issue 表单接收修正和补充)
- Hugging Face 镜像: 由
build-dataset-csv.py从上述仓库自动再生
引用方式
数据集已通过 Zenodo 存档并分配 DOI(概念 DOI,始终解析到最新版本):
bibtex @dataset{jlali_tunisian_nlp_resources, author = {Jlali, Fatma}, title = {Tunisian Arabic NLP Resources: an access-verified inventory}, publisher = {Zenodo}, doi = {10.5281/zenodo.21779464}, url = {https://doi.org/10.5281/zenodo.21779464} }