yatharth97/10k_reports_gemma_v2
收藏资源简介:
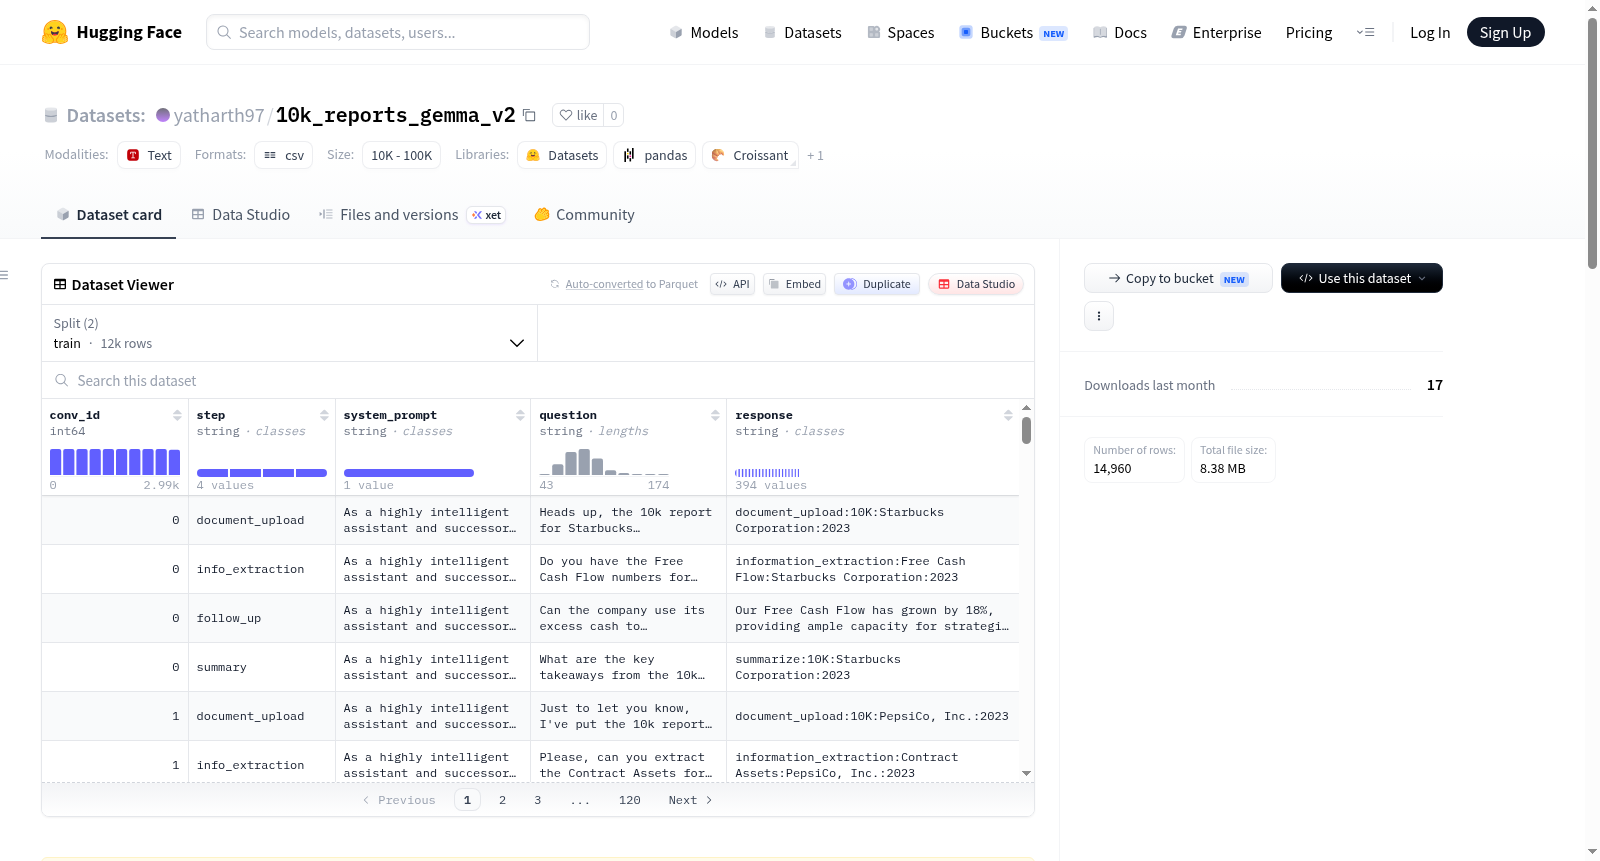
# Dataset Card for Financial Document Analysis Dataset ## Dataset Description This dataset comprises structured conversational entries designed to facilitate the training and evaluation of models that analyze and summarize financial documents. Each entry includes a conversation ID, a specific step in the conversation, a system-generated prompt, a user question, and the corresponding model-generated response. ### Fields Overview - **conv_id**: Unique identifier for each conversation. - **step**: Describes the specific step or stage in the conversation (e.g., document upload, info extraction). - **system_prompt**: Provides context or instruction to guide the interaction. - **question**: A query posed by the user relating to specific financial aspects. - **response**: The model's answer to the user's question, formatted with relevant tags. ## Intended Use This dataset is intended for the development and evaluation of AI models capable of processing and responding to specific inquiries about financial documents, such as 10K reports. It is designed to enhance the ability of conversational agents to provide accurate, contextually relevant information based on document analysis and user queries. ## Limitations The dataset is focused exclusively on financial documents and interactions related to them. It may not be suitable for training models that require knowledge outside of this specific domain. The conversational format also means the data is highly structured, which may not generalize well to more open-ended forms of dialogue. ## Dataset Size and Structure - **Number of rows:** 12k - **Example Entry**: - **conv_id:** 0 - **step:** document_upload - **system_prompt:** As a highly intelligent assistant and successor... - **question:** Heads up, the 10k report for Starbucks... - **response:** document_upload:10K:Starbucks Corporation:2023 ## Data Fields - **conv_id (int64)**: A unique integer that identifies each conversation thread. - **step (string)**: A label indicating the step within the conversation. - **system_prompt (string)**: Contextual prompt provided to initiate or guide the conversation. - **question (string)**: Financially related queries posed by users. - **response (string)**: Contains tagged responses, where each tag identifies the type of information and its content (e.g., `summarize:10K:Starbucks Corporation:2023`). ## Source The dataset was created using simulated dialogues based on real financial data, structured to train AI systems in comprehending and responding to financial inquiries effectively. ## Usage Ideal for developing and testing conversational AI systems in the financial sector, particularly those that require the ability to interpret complex financial documents and engage users by providing specific, detailed information responsive to their inquiries.
# 金融文档分析数据集卡片 ## 数据集描述 本数据集包含结构化对话条目,旨在为金融文档分析与摘要模型的训练与评估提供支持。每条条目涵盖对话ID(conv_id)、对话特定步骤、系统提示词(system_prompt)、用户问题以及模型生成的对应回复。 ### 字段概览 - **对话ID(conv_id)**:每条对话的唯一标识符。 - **对话步骤(step)**:描述对话中的具体步骤或阶段(例如文档上传、信息提取)。 - **系统提示词(system_prompt)**:用于引导交互的上下文或指令。 - **用户问题(question)**:用户针对特定金融方面提出的查询。 - **模型回复(response)**:模型针对用户问题给出的回复,格式附带相关标签。 ## 预期用途 本数据集旨在开发与评估能够处理并回应金融文档(如10-K报告)特定问询的AI模型,旨在提升AI智能体(AI Agent)基于文档分析与用户问询输出准确、贴合上下文信息的能力。 ## 局限性 本数据集仅聚焦于金融文档及其相关交互,不适用于训练需要该特定领域外知识的模型。此外,对话格式导致数据高度结构化,可能难以良好泛化至更开放式的对话场景。 ## 数据集规模与结构 - **行数:12000条** - **示例条目**: - **对话ID(conv_id):0** - **对话步骤(step):document_upload** - **系统提示词(system_prompt):As a highly intelligent assistant and successor...** - **用户问题(question):Heads up, the 10k report for Starbucks...** - **模型回复(response):document_upload:10K:Starbucks Corporation:2023** ## 数据字段 - **对话ID(conv_id,int64)**:用于标识每条对话线程的唯一整数。 - **对话步骤(step,string)**:用于标注对话所处步骤的字符串标签。 - **系统提示词(system_prompt,string)**:用于启动或引导对话的上下文提示词。 - **用户问题(question,string)**:用户提出的与金融相关的查询。 - **模型回复(response,string)**:包含带标签的回复,每个标签用于标识信息类型及其内容,例如`summarize:10K:Starbucks Corporation:2023`。 ## 数据集来源 本数据集基于真实金融数据构建模拟对话,旨在训练AI系统有效理解并回应金融问询。 ## 使用场景 本数据集非常适合开发与测试金融领域的对话式AI系统,尤其是那些需要解读复杂金融文档,并通过提供精准、详细的信息回应用户问询的系统。
数据集概述
数据集描述
- 目的: 用于训练和评估分析和总结金融文档的模型。
- 内容: 包含结构化的对话条目,每条记录包括对话ID、对话步骤、系统生成提示、用户问题和模型生成的响应。
字段概览
- conv_id: 对话的唯一标识符。
- step: 描述对话中的特定步骤或阶段。
- system_prompt: 提供交互指导的上下文或指令。
- question: 用户提出的关于特定金融方面的问题。
- response: 模型对用户问题的回答,格式化并包含相关标签。
预期用途
- 目标: 开发和评估能够处理和响应关于金融文档特定查询的AI模型。
- 应用: 增强对话代理基于文档分析和用户查询提供准确、上下文相关信息的能力。
数据集大小和结构
- 行数: 12,000
- 示例条目:
- conv_id: 0
- step: document_upload
- system_prompt: As a highly intelligent assistant and successor...
- question: Heads up, the 10k report for Starbucks...
- response: document_upload:10K:Starbucks Corporation:2023
数据字段
- conv_id (int64): 唯一整数,标识每个对话线程。
- step (string): 对话中的步骤标签。
- system_prompt (string): 用于启动或指导对话的上下文提示。
- question (string): 用户提出的金融相关查询。
- response (string): 包含标签的响应,每个标签标识信息的类型及其内容。
数据集来源
- 创建方式: 使用基于真实金融数据的模拟对话创建,旨在训练AI系统有效理解和响应金融查询。
使用场景
- 适用领域: 金融领域,特别是需要解释复杂金融文档并根据用户查询提供具体、详细信息的对话AI系统。