Nemotron-Personas-El-Salvador
收藏资源简介:
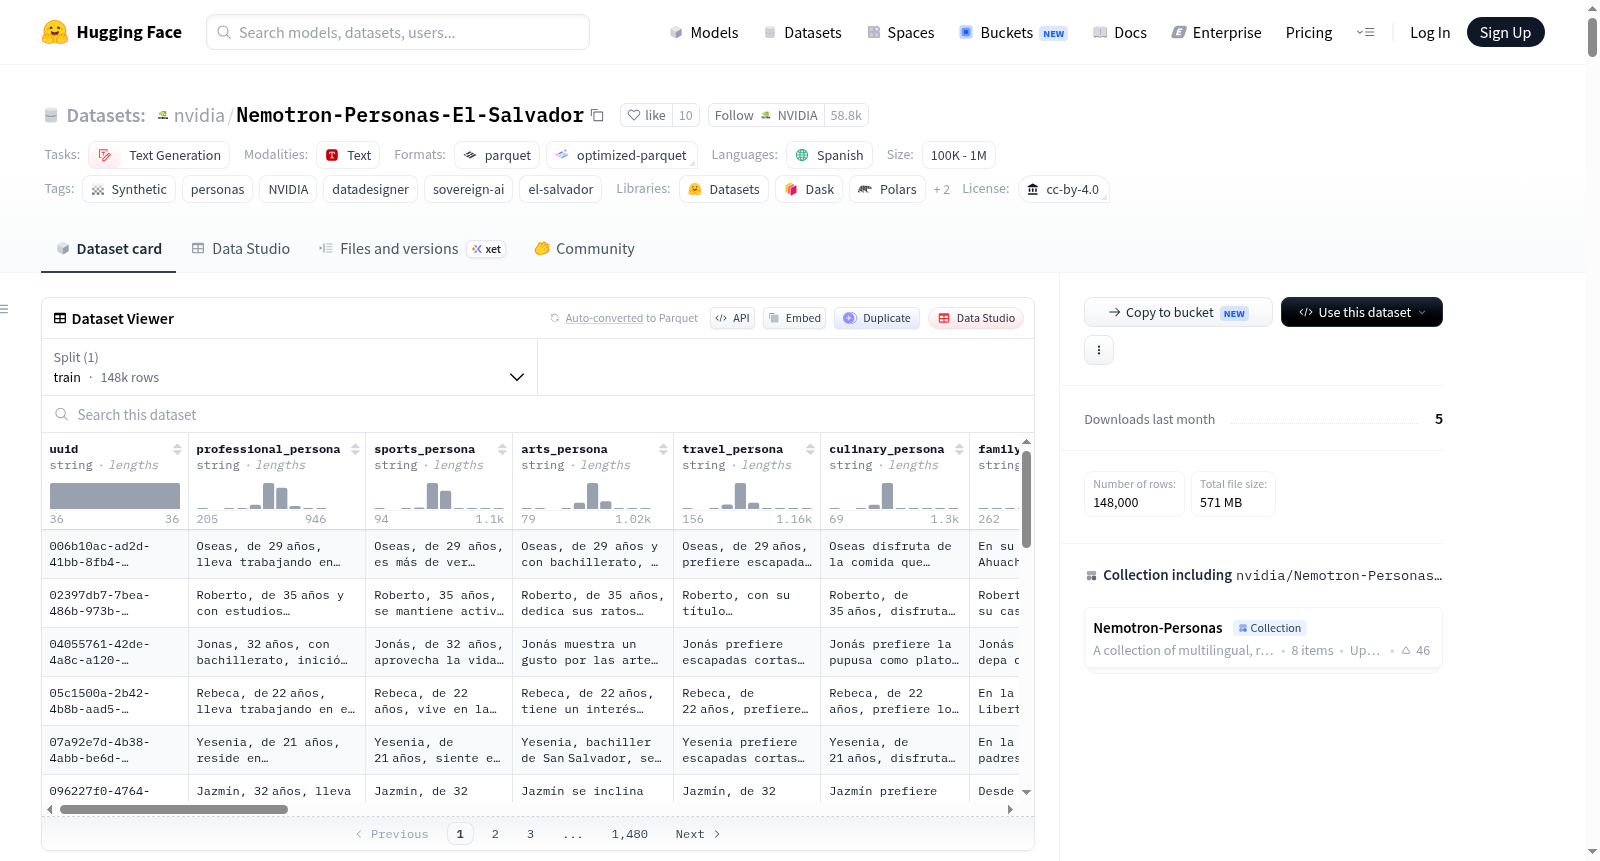
Nemotron-Personas-El-Salvador是一个开源的合成生成人物数据集,采用CC BY 4.0许可证。该数据集基于萨尔瓦多真实的人口统计、地理和人格特征分布构建,旨在准确反映该国人口的多样性和丰富性。数据集包含148,000条记录,总计100万个人物,涵盖300M token(其中161M为人物描述token)。数据结构包含25个字段:7个人物描述字段(通用人物、专业人物、体育人物、艺术人物、旅行人物、烹饪人物、家庭人物)和18个上下文字段(包括文化背景、技能专长、兴趣爱好、职业目标、性别、年龄、语言、婚姻状况、家庭类型、教育水平、职业、地理位置等)。所有人口统计属性均基于2024年萨尔瓦多人口和住房普查的官方统计数据,确保数据真实性和代表性。数据集完全覆盖萨尔瓦多全部14个部门和44个市镇,包含144,000个独特姓名和119种职业类型。该数据集专为支持主权AI开发而设计,通过提供基于真实分布的高质量合成数据,帮助提高数据多样性、减轻模型偏见、防止模型崩溃,特别适用于训练西班牙语萨尔瓦多方言的大型语言模型。数据集仅包含18岁及以上的成年人,所有数据均为人工生成,任何与真实人物的相似性纯属巧合。
Nemotron-Personas-El-Salvador is an open-source synthetic generated persona dataset under the CC BY 4.0 license. It is constructed based on real demographic, geographic, and personality trait distributions of El Salvador, aiming to accurately reflect the diversity and richness of the countrys population. The dataset contains 148,000 records, totaling 1 million personas, covering 300M tokens (with 161M being persona description tokens). The data structure includes 25 fields: 7 persona description fields (general persona, professional persona, sports persona, artistic persona, travel persona, culinary persona, family persona) and 18 contextual fields (including cultural background, skills and expertise, hobbies and interests, career goals, gender, age, language, marital status, family type, education level, occupation, geographical location, etc.). All demographic attributes are based on official statistical data from the 2024 El Salvador Population and Housing Census, ensuring data authenticity and representativeness. The dataset fully covers all 14 departments and 44 municipalities of El Salvador, including 144,000 unique names and 119 occupation types. It is specifically designed to support sovereign AI development by providing high-quality synthetic data based on real distributions, helping to improve data diversity, mitigate model bias, prevent model collapse, and is particularly suitable for training large language models in the Spanish Salvadoran dialect. The dataset only includes adults aged 18 and above, all data is artificially generated, and any resemblance to real persons is purely coincidental.
数据集概述:Nemotron-Personas-El-Salvador
基本信息
- 数据集名称: Nemotron-Personas-El-Salvador
- 许可证: CC BY 4.0(Creative Commons Attribution 4.0 International License)
- 语言: 西班牙语(萨尔瓦多西班牙语)
- 任务类别: 文本生成
- 数据集规模: 100K < n < 1M(训练集含 148,000 条记录)
- 数据集大小: 约 1.19 GB(下载大小约 568 MB)
- 发布日期: 2026年3月6日(通过 Hugging Face 发布)
- 版本: 1.0
- 开发者: WideLabs 与 NVIDIA Corporation
核心特点
- 数据性质: 完全由合成生成的个人档案,基于萨尔瓦多真实的人口、地理和人格特征分布,旨在捕捉萨尔瓦多人口的多样性与丰富性。
- 数据锚定: 基于 2024 年萨尔瓦多第七次人口与第六次住房普查(7º Censo de Población y 6º Censo de Vivienda 2024)的自报人口统计数据,以及来自国家自然人登记处(RNPN)的萨尔瓦多名字频率分布。
- 独特性: 该数据集是首个与萨尔瓦多官方统计数据(如姓名、性别、年龄、婚姻状况、教育、职业和位置等)对齐的萨尔瓦多数据集,是 NVIDIA Nemotron Personas 系列的一员。
数据集内容与结构
- 记录与人物: 包含 148,000 条记录,每条记录含 7 个人物档案,总计约 100 万个人物档案。
- Token 数量: 约 3 亿 token,其中人物 token 约 1.61 亿。
- 字段数量: 共 25 个字段,包括 7 个人物字段和 18 个上下文属性字段。
- 人物字段: professional_persona, sports_persona, arts_persona, travel_persona, culinary_persona, family_persona, persona(通用人物档案)。
- 上下文字段: 包括 uuid, cultural_background, skills_and_expertise, skills_and_expertise_list, hobbies_and_interests, hobbies_and_interests_list, career_goals_and_ambitions, sex, age, languages_spoken, marital_status, household_type, education_level, occupation, area, municipality, department, country。
- 地理覆盖: 完整覆盖萨尔瓦多所有 14 个省(departamentos)和 44 个市(municipios)(基于 2024 年行政重组)。
- 名字: 包含约 14.4 万个独特名字,生成依据约 5,377 个独特名字和约 2,036 个独特姓氏。
- 职业结构: 基于普查数据,包含 119 种不同职业类型,分布于 8 个就业类别。
- 人物类型多样性: 包含一般、专业、运动、艺术、旅行、烹饪、家庭等多种类型。
数据来源与种子数据
- 人口与住房普查数据: 源自 Banco Central de Reserva de El Salvador (BCR) / Oficina Nacional de Estadística y Censos (ONEC) 的 VII Censo de Población y VI Censo de Vivienda 2024(约 6,029,976 人)。该普查为该国首个 100% 数字化普查,提供性别、年龄、省、市、教育、婚姻状况、职业等锚定数据。
- 名字频率分布: 来自 Registro Nacional de las Personas Naturales (RNPN) 的公开数据门户 "Así Somos",基于 DUI 民事登记,用于生成约 5,377 个独特名字和约 2,036 个独特姓氏。
数据生成方法
- 工具: 使用 NVIDIA NeMo Data Designer(企业级复合 AI 系统)生成。
- 技术: 利用专有概率图模型(Probabilistic Graphical Model, PGM)与
openai/gpt-oss-120b模型(Apache 2.0 许可),以及 Data Designer 内置的验证器和评估器。
用途与目标
- 主要用途: 支持主权 AI(Sovereign AI)开发,特别是针对萨尔瓦多的 LLM 训练。用于提升合成生成数据的多样性,缓解数据或模型偏差,并防止模型崩溃(model collapse)。
- 目标用户: 开发主权 AI 的开发者、训练 LLM 的研究人员,以及希望改善合成数据多样性的用户。
- 数据范围: 仅涵盖成年人(18 岁及以上)。
排除内容
- 该数据集专注于人物档案,排除了 NeMo Data Designer 中可用的其他字段(如名字/姓氏、人格特质等)。
- 同时排除了企业客户通常关注的人物类型(如金融、医疗健康方向)。
- 所有数据均为完全人工生成,任何与真实人物的相似性纯属巧合。