phishing-email-training-dataset
收藏资源简介:
该数据集包含用于训练大型语言模型(LLMs)在电子邮件安全和钓鱼分析领域的指令遵循数据。数据集通过指令数据生成器生成,该生成器将提示模板应用于原始电子邮件数据,并从各种LLMs收集响应,从而为专注于网络安全的对话式AI模型创建高质量的训练数据。数据集由Montimage策划,语言为英语,采用MIT许可,任务为电子邮件钓鱼检测和网络安全分析,格式为对话式指令遵循(人机配对)。
This dataset provides instruction-following data for training large language models (LLMs) in the domains of email security and phishing analysis. It is generated via an instruction data generator, which applies prompt templates to raw email data and collects responses from various LLMs, thereby creating high-quality training data for conversational AI models focused on cybersecurity. Curated by Montimage, this dataset is in English, licensed under the MIT License, targets tasks including email phishing detection and cybersecurity analysis, and follows a conversational instruction-following format (human-machine pairing).
数据集概述
基本信息
- 数据集名称: Phishing Email Training Dataset
- 维护者/机构: Montimage
- 语言: 英语 (English)
- 许可证: MIT License
- 任务类别: 文本生成、文本分类
- 标签: 电子邮件、安全、网络钓鱼、合成数据、指令遵循
数据集描述
本数据集包含用于在电子邮件安全和网络钓鱼分析领域训练大语言模型的指令遵循数据。数据集旨在开发能够输出结构化JSON电子邮件分析的模型,以识别威胁、风险级别和具体的入侵指标。
直接用途
- 微调大语言模型: 训练模型使其能够作为专业的安全分析师,检测网络钓鱼企图并提供详细、结构化的解释。
- 网络安全研究: 用于分析网络钓鱼攻击趋势,并评估基于人工智能的检测系统的有效性。
- 教育目的: 为培训人类分析师如何发现和阐明网络钓鱼指标生成示例。
数据来源与生成
- 源数据: 源自CEAS-08电子邮件数据集(200个平衡样本)。
- 生成器模型:
gpt-oss-120b。 - 生成过程:
- 从CEAS-08数据集中提取原始电子邮件。
- 应用用于电子邮件分析的特定领域模板。
- 使用
gpt-oss-120b生成高质量的指令响应。
数据集结构
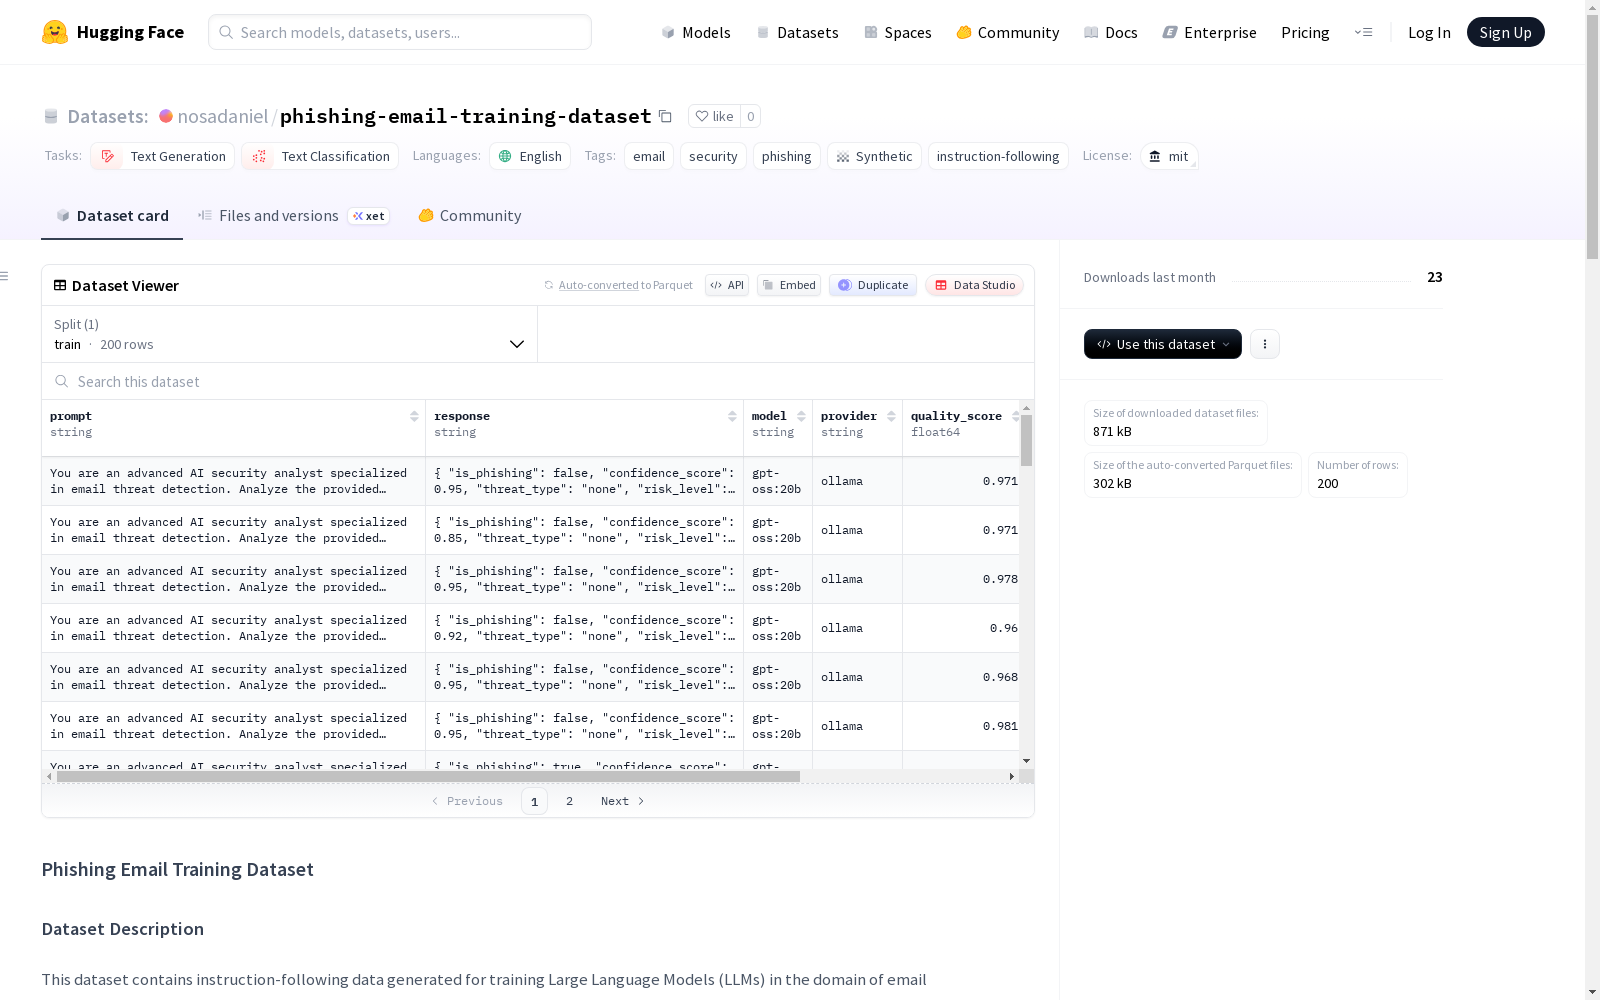
数据集为JSONL格式。每个条目包含训练对(prompt, response)以及用于验证和过滤的元数据。
数据字段说明
- 训练字段:
prompt: 需要分析的输入指令和电子邮件内容。response: 来自AI助手的预期高质量JSON分析和解释。
- 验证与元数据字段:
model,provider,model_config: 用于生成合成数据的模型相关信息。quality_score,confidence: 指示生成响应质量和确定性的指标。is_valid: 布尔标志,指示条目是否通过验证检查。label: 源数据集中的原始真实标签(例如,0表示正常邮件,1表示网络钓鱼邮件)。
数据实例
一个典型的数据实例包含一个要求分析电子邮件的提示,以及一个结构化的JSON响应,其中包含is_phishing、confidence_score、threat_type、risk_level、indicators、mitigation_recommendations和analysis_summary等字段。
作者与联系
- 作者: Montimage(电子邮件安全研究部门、AI/ML工程团队、网络安全领域专家)
- 联系邮箱: developer@montimage.com
- 问题反馈: https://github.com/montimage/instruction-data-generator/issues