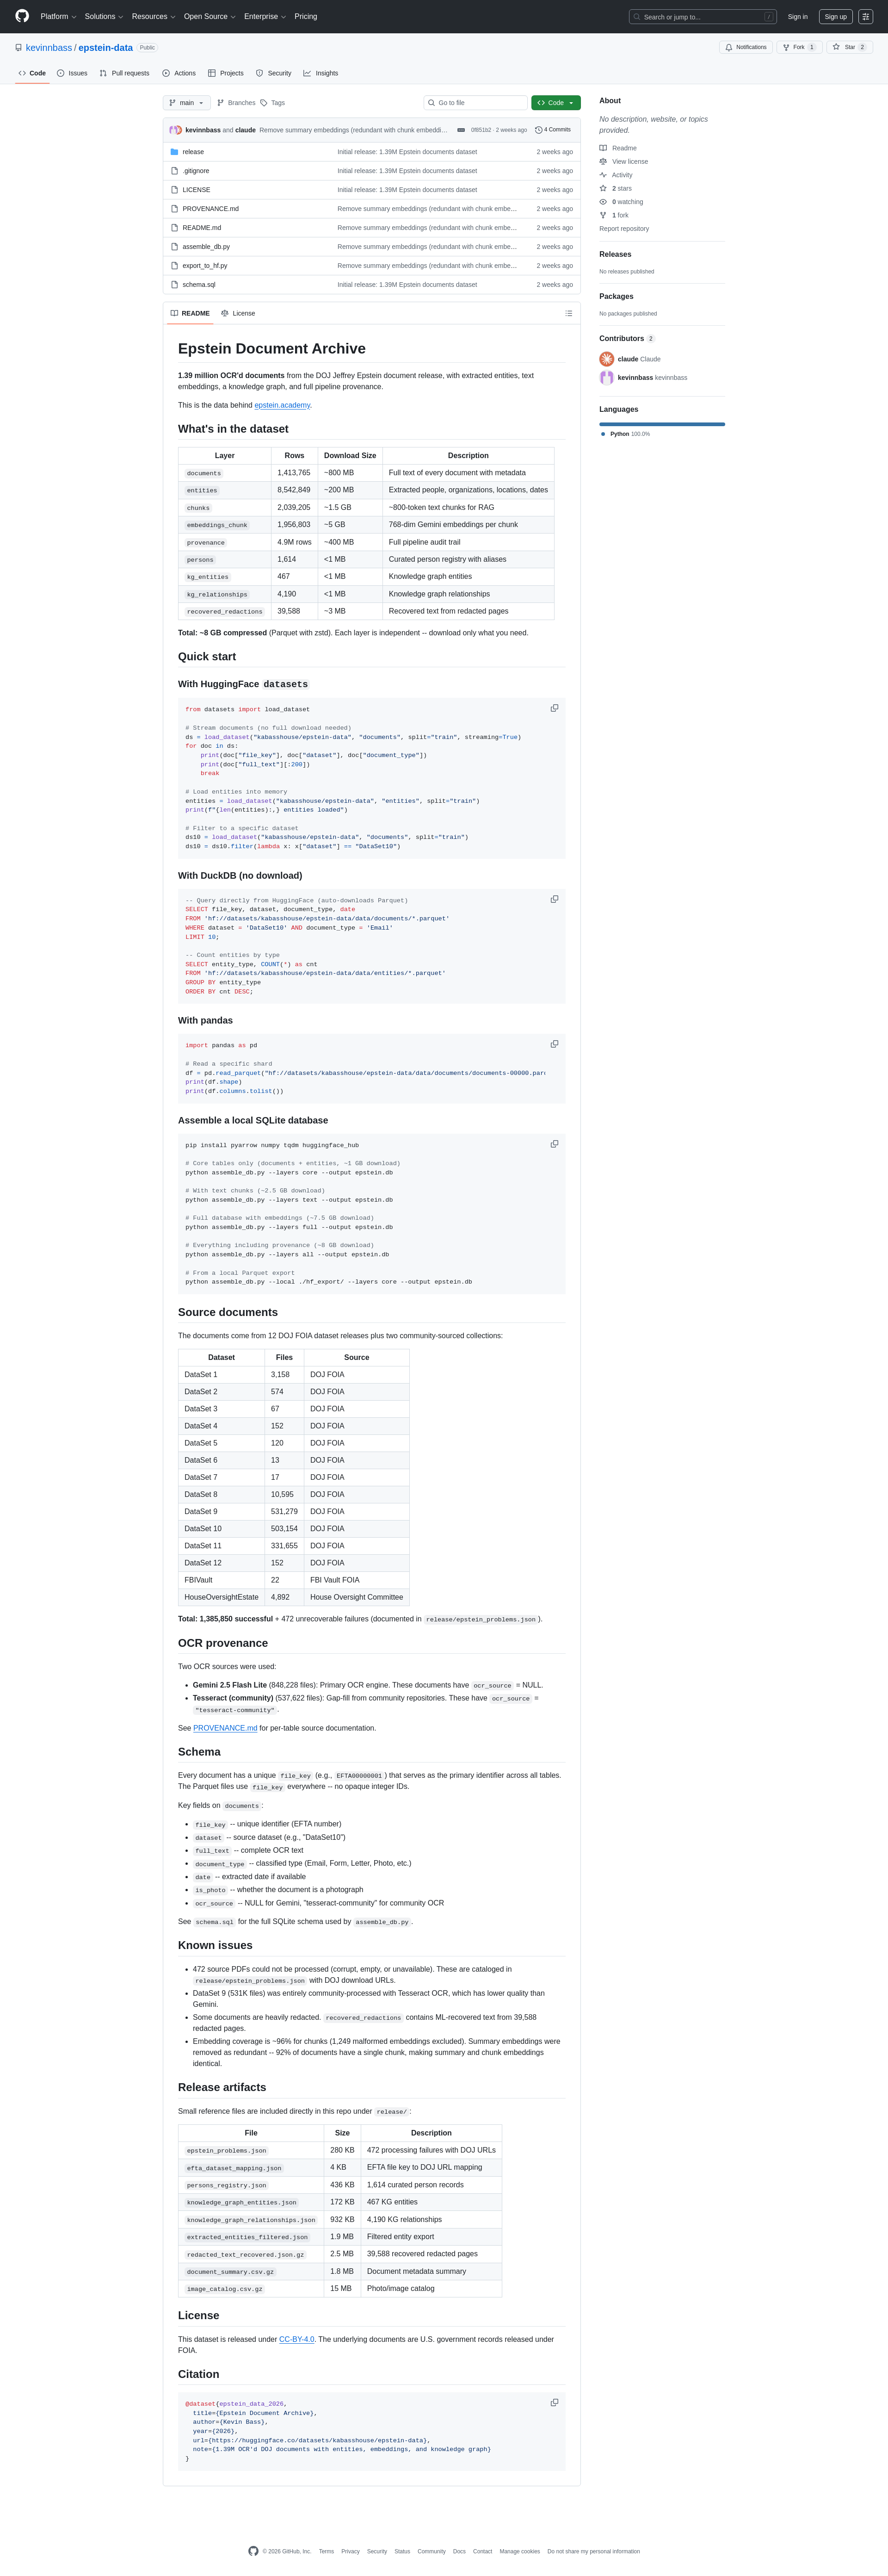
Epstein Document Archive
收藏资源简介:
包含来自DOJ Jeffrey Epstein文件发布的139万份OCR处理文件,提取的实体、文本嵌入、知识图谱和完整的管道来源。数据集包括文档、实体、文本块、嵌入、来源、人员注册表、知识图谱实体和关系、以及恢复的涂黑文本等多个层次。
This dataset contains 1.39 million OCR-processed documents sourced from the DOJ-released Jeffrey Epstein files, along with extracted entities, text embeddings, knowledge graphs, and complete pipeline provenance. It covers multiple data layers including full documents, entities, text chunks, embeddings, sources, person registries, knowledge graph entities and relationships, as well as recovered redacted text.
Epstein Document Archive 数据集概述
数据集基本信息
- 数据集名称:Epstein Document Archive
- 数据来源:美国司法部(DOJ)根据《信息自由法》(FOIA)发布的Jeffrey Epstein相关文件,以及两个社区来源的集合。
- 数据规模:包含约139万份经过光学字符识别(OCR)处理的文档。
- 总数据量:压缩后约8 GB(Parquet格式,使用zstd压缩)。
- 访问地址:https://huggingface.co/datasets/kabasshouse/epstein-data
- 许可协议:CC-BY-4.0。底层文档为根据FOIA发布的美国政府记录。
数据内容与结构
数据集由多个独立的数据层(Layer)组成,用户可按需下载。
| 数据层 | 行数 | 下载大小 | 描述 |
|---|---|---|---|
documents |
1,413,765 | ~800 MB | 每份文档的完整文本及元数据 |
entities |
8,542,849 | ~200 MB | 提取的人物、组织、地点、日期等实体 |
chunks |
2,039,205 | ~1.5 GB | 用于RAG的约800个token的文本块 |
embeddings_chunk |
1,956,803 | ~5 GB | 每个文本块的768维Gemini嵌入向量 |
provenance |
4.9M 行 | ~400 MB | 完整的数据处理流水线审计追踪 |
persons |
1,614 | <1 MB | 经过人工整理的人物注册表(含别名) |
kg_entities |
467 | <1 MB | 知识图谱实体 |
kg_relationships |
4,190 | <1 MB | 知识图谱关系 |
recovered_redactions |
39,588 | ~3 MB | 从被涂黑页面中恢复的文本 |
源文档构成
文档来源于12个DOJ FOIA数据集发布以及两个社区来源的集合。
| 数据集 | 文件数 | 来源 |
|---|---|---|
| DataSet 1 | 3,158 | DOJ FOIA |
| DataSet 2 | 574 | DOJ FOIA |
| DataSet 3 | 67 | DOJ FOIA |
| DataSet 4 | 152 | DOJ FOIA |
| DataSet 5 | 120 | DOJ FOIA |
| DataSet 6 | 13 | DOJ FOIA |
| DataSet 7 | 17 | DOJ FOIA |
| DataSet 8 | 10,595 | DOJ FOIA |
| DataSet 9 | 531,279 | DOJ FOIA |
| DataSet 10 | 503,154 | DOJ FOIA |
| DataSet 11 | 331,655 | DOJ FOIA |
| DataSet 12 | 152 | DOJ FOIA |
| FBIVault | 22 | FBI Vault FOIA |
| HouseOversightEstate | 4,892 | 众议院监督委员会 |
总计:1,385,850份成功处理的文档 + 472份无法恢复的失败文档(记录于release/epstein_problems.json)。
OCR处理来源
使用了两种OCR来源:
- Gemini 2.5 Flash Lite(848,228份文件):主要OCR引擎。这些文档的
ocr_source字段为NULL。 - Tesseract (community)(537,622份文件):来自社区仓库的补充。这些文档的
ocr_source字段为"tesseract-community"。
核心字段说明
每份文档都有一个唯一的file_key(例如EFTA00000001)作为所有表格中的主标识符。
documents表的关键字段:
file_key:唯一标识符(EFTA编号)dataset:源数据集(例如 "DataSet10")full_text:完整的OCR文本document_type:分类类型(Email, Form, Letter, Photo等)date:提取的日期(如果可用)is_photo:文档是否为照片ocr_source:NULL表示Gemini处理,"tesseract-community"表示社区OCR处理
已知问题
- 472个源PDF文件无法处理(损坏、为空或不可用)。这些文件记录在
release/epstein_problems.json中,并附有DOJ下载链接。 - DataSet 9(531K份文件)完全由社区使用Tesseract OCR处理,其质量低于Gemini。
- 部分文档被大量涂黑。
recovered_redactions包含了从39,588个被涂黑页面中通过机器学习恢复的文本。 - 文本块的嵌入向量覆盖率为约96%(1,249个格式错误的嵌入向量被排除)。摘要嵌入向量因冗余已被移除——92%的文档只有一个文本块,使得摘要嵌入和文本块嵌入完全相同。
发布文件
本仓库的release/目录下包含小型参考文件:
epstein_problems.json:472个处理失败的记录及DOJ链接。efta_dataset_mapping.json:EFTA文件键到DOJ URL的映射。persons_registry.json:1,614条人工整理的人物记录。knowledge_graph_entities.json:467个知识图谱实体。knowledge_graph_relationships.json:4,190条知识图谱关系。extracted_entities_filtered.json:过滤后的实体导出。redacted_text_recovered.json.gz:39,588个被涂黑页面恢复的文本。document_summary.csv.gz:文档元数据摘要。image_catalog.csv.gz:照片/图像目录。