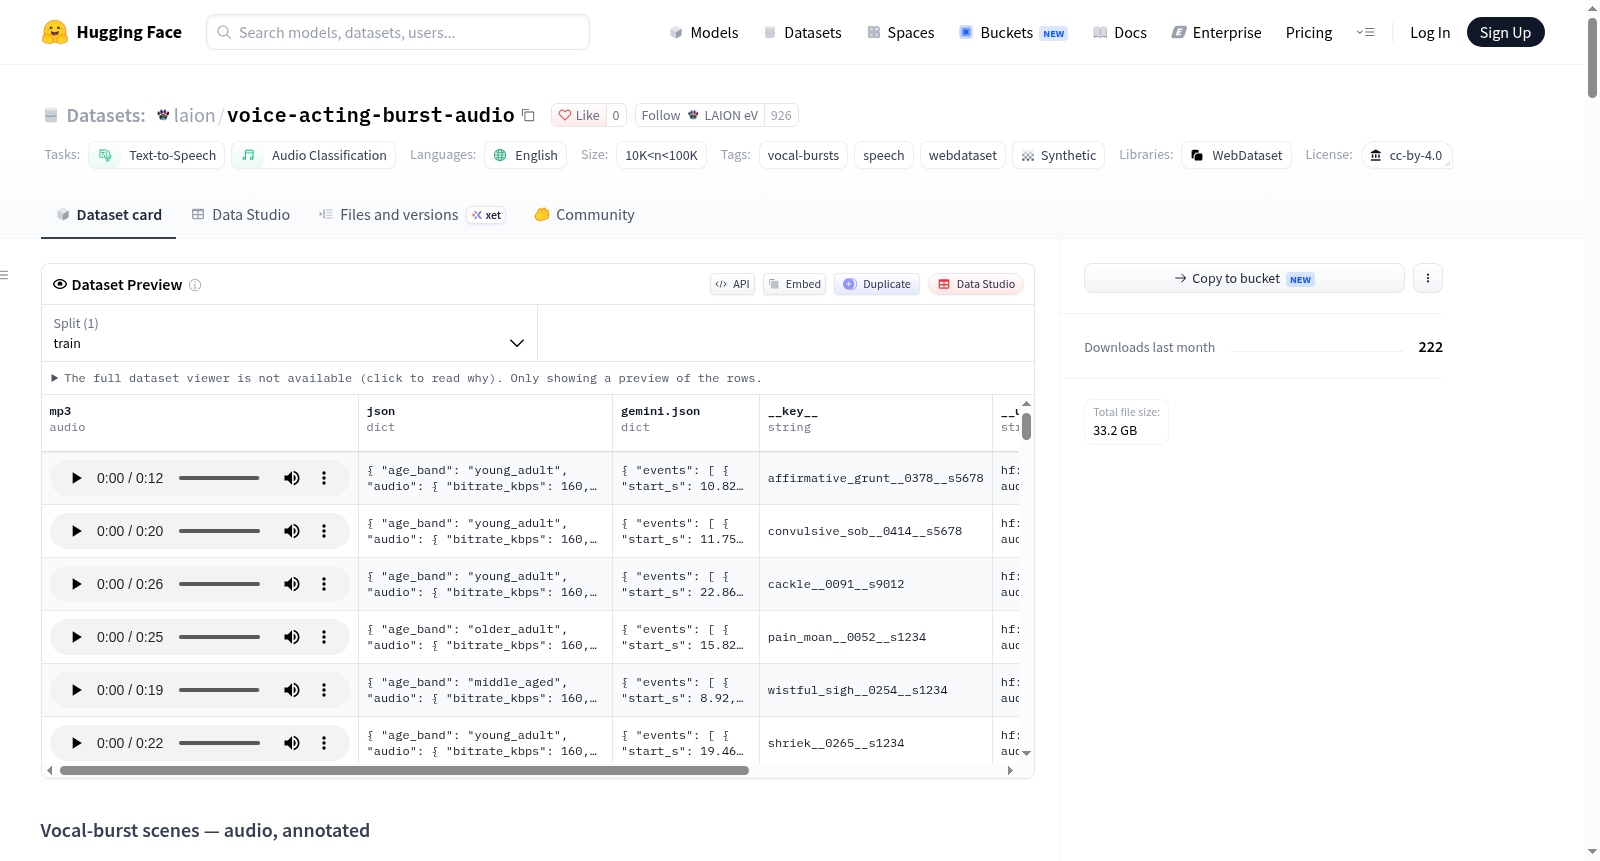
voice-acting-burst-audio
收藏资源简介:
该数据集包含73,500个生成的声爆发场景,涵盖49个声爆发类别(如深呼吸、叹息、哼唱、笑、尖叫等)。每个类别包含500个文本提示,每个提示使用3个随机种子生成,因此每个类别有1,500个样本。所有音频片段均由一个语音表演AI模型生成,并附有Gemini 3.8 Flash模型的自动标注,标注内容包括爆发事件在音频中的起始时间、结束时间、标签(共97种不同标签,总计123,004个事件)、置信度和描述。数据集的创建动机是为了弥补已有爆发检测器在识别多样性和准确性方面的不足,采用不同的生成器和标注器来提供更密集、更有目的的爆发音频。音频格式为48 kHz、160 kbps、单声道MP3,未重新编码。数据以WebDataset格式存储,包含74个tar分片文件(每个分片约1000个样本,最后一个分片500个),以及一个metadata.parquet文件(73,500行,每行对应一个片段)、统计JSON文件和标注统计JSON文件。数据集在性别(男女各36,750)、年龄组(年轻成人24,696、中年成人24,402、老年成人24,402)上保持平衡。每个片段还包含生成记录JSON(提示、类别、种子、说话人性别和年龄带、生成参数等)和标注JSON。该数据集适用于文本到语音、音频分类、语音爆发检测和标注等任务,但注意标注是模型意见,未经人工验证。许可证为CC BY 4.0。
This dataset contains 73,500 generated vocal burst scenarios covering 49 vocal burst categories (such as deep breath, sigh, hum, laugh, scream, etc.). Each category includes 500 text prompts, each prompt generated using 3 random seeds, resulting in 1,500 samples per category. All audio clips are generated by a voice performance AI model and automatically annotated with a Gemini 3.8 Flash model, including start time, end time, label (97 different labels, 123,004 events in total), confidence, and description. The dataset was created to address the lack of diversity and accuracy in existing burst detectors, using different generators and annotators to provide denser and more purposeful burst audio. Audio format is 48 kHz, 160 kbps, mono MP3, not re-encoded. Data is stored in WebDataset format, containing 74 tar shard files (approximately 1,000 samples per shard, 500 for the last shard), a metadata.parquet file (73,500 rows, each corresponding to a clip), a statistics JSON file, and an annotation statistics JSON file. The dataset is balanced in gender (36,750 each for male and female) and age groups (24,696 young adults, 24,402 middle-aged adults, 24,402 older adults). Each clip also includes a generation record JSON (prompt, category, seed, speaker gender and age band, generation parameters, etc.) and annotation JSON. The dataset is suitable for tasks such as text-to-speech, audio classification, vocal burst detection, and annotation, but note that annotations are model opinions and have not been manually verified. License is CC BY 4.0.
数据集概述:laion/voice-acting-burst-audio
基本信息
- 许可证:CC BY 4.0
- 任务类别:text-to-speech、audio-classification
- 语言:英语(en)
- 标签:vocal-bursts、speech、webdataset、synthetic
- 数据规模:10K<n<100K
- 数据集地址:https://huggingface.co/datasets/laion/voice-acting-burst-audio
数据集内容
- 包含 73,500 个生成场景,跨越 49 个 vocal-burst 类别,每类 500 条提示,每条提示以 3 个种子渲染,因此每条提示出现三次。
- 每个片段均带有 Gemini 3.8 Flash 标注,标注 burst 的位置和类型。
- 标注总计 123,004 个事件,覆盖 73,500 个片段(平均每片段 1.674 个),使用 97 个不同标签。
- 在 32 个 GH200 节点上以生成器默认设置生成(耗时 1 小时 49 分,128 ranks,零失败)。
- 提示词单独发布于
laion/voice-acting-burst-prompts。
数据集目的
该项目自有的 burst 检测器在 60 片段审计中未发出 Shriek、仅使用了 83 个标签中的 8 个,且仅在 60 个片段中的 3 个里将请求的 burst 排入前三。本项目发布的所有 burst 适配器均在该检测器标注的行上训练。本语料库从不同的生成器密集且有目的地获取 burst 音频,并使用不同的标注器进行标注。
注意:该标注是第二个模型的观点,并非经验证的 ground truth,无人工听审。
标注信息
| 项目 | 数值 |
|---|---|
| 已标注片段 | 73,500 |
| 成功响应 | 73,500 |
| 错误 / 无法解析 | 0 |
| 无响应的片段 | 0 |
| 发现的 burst 事件 | 123,004 |
| 每片段事件数 | 1.674 |
| 模型未听到 burst 的片段 | 394 |
| 使用的不同标签 | 97 |
| 事件长度中位数 | 1.27 s |
| 被裁剪到片段内的跨度 | 0 |
- 模型:
gemini-3.8-flash,thinkingLevel: "low",temperature 0,JSON schema 强制,通过 Batch API 运行。 - 实测成本:100.8 M 输入 token、12.6 M 输出 token、2,362,228 thinking token。
- 每个片段完整展示给模型,从不预先切割。
- 超出自身音频末端的跨度会被裁剪并标记为
out_of_range,绝不丢弃。
最常见的 25 个标签
| 标签(首选) | 事件数 |
|---|---|
| Deep Breath | 18,121 |
| Exasperated Sigh | 17,771 |
| Humming | 10,449 |
| Chuckle | 9,893 |
| Relief Sigh | 6,043 |
| Sharp Inhale | 5,937 |
| Yawn | 4,089 |
| Scream | 3,637 |
| Cackle | 2,434 |
| Hiss | 2,199 |
| Displeased Grunt | 1,991 |
| Frustrated Groan | 1,810 |
| Surprised Gasp | 1,760 |
| Affirmative Grunt | 1,699 |
| Hiccup | 1,691 |
| Growl | 1,633 |
| Contented Sigh | 1,621 |
| Guffaw | 1,602 |
| Breathy Giggle | 1,601 |
| Soft Hum | 1,527 |
| Coughing | 1,522 |
| Wistful Sigh | 1,478 |
| Exhausted Groan | 1,440 |
| Childlike Giggle | 1,423 |
| Sniff | 1,416 |
文件与布局
仓库根目录下共 81 个文件。
| 路径 | 数量 | 说明 |
|---|---|---|
shard-00000.tar … shard-00073.tar |
74 | 音频,每个片段带两个 JSON sidecar |
metadata.parquet |
1 | 每片段一行,7 列 —— 无需打开 tar 即可过滤语料库 |
stats.json |
1 | 语料库总量及按类别 / 性别 / 年龄的计数 |
annotation_stats.json |
1 | Gemini 标注运行:标签直方图、事件计数、token 使用量 |
vocal_burst_groups.json、GROUPS.md |
2 | 覆盖 118 个 burst 标签字符串的 23 组方案 |
README.md |
1 | 本卡片 |
- 每个 shard 含 1000 个样本,最后一个含 500 个。Shard 顺序是固定的种子排列,因此一个 shard 已包含完整分布,无需大型 shuffle buffer。
tar 内部 —— 每个片段三个成员,一个 stem
| 成员 | 格式 | 详情 |
|---|---|---|
<key>.mp3 |
MPEG-1 Layer III,48 kHz,160 kbps CBR,单声道 | 由生成器写入 —— 未重新编码,添加标注时也未再次重新编码 |
<key>.json |
JSON | 生成记录 |
<key>.gemini.json |
JSON | Gemini 标注 |
- 键格式为
<class>__<prompt index>__s<seed>,例如affirmative_grunt__0378__s5678。 - 从发布字节读回验证:所有 73,500 个文件的 MPEG 帧头均通过检查,所有 73,500 个键均从写入的 shard 中恰好往返一次。
不包含 codec token
本仓库不提供 MOSS codes、.moss.npy、embeddings 或 .vclap.npy —— 仅有音频和两个 JSON sidecar。若需 MOSS token,需自行使用 OpenMOSS-Team/MOSS-Audio-Tokenizer-v2 编码。也无 transcript 列。
<key>.json —— 生成记录
| 键 | 含义 |
|---|---|
key |
片段键,也是 tar 成员 stem |
cls |
该片段生成所用的 vocal-burst 类别(49 个之一) |
idx |
类别内的提示索引,0..499 |
seed |
生成种子;每条提示以 3 个种子渲染 |
prompt |
传给生成器的完整文本提示 |
gender、age_band |
请求的说话者性别和年龄段 |
spec |
结构化提示规范:age、register、place、topic、trigger、phon、position、return_to_calm、intensity |
settings |
生成器设置:cfg_scale、stg_scale、duration_multiplier、gen_duration、ref_duration |
audio |
旁边文件的 {codec, bitrate_kbps, channels, sr} |
dur_s、peak |
时长(秒)和峰值样本值 |
<key>.gemini.json —— 标注
| 键 | 含义 |
|---|---|
no_burst |
模型在该片段中未听到任何 vocal burst |
events |
{start_s, end_s, labels[1-3], confidence, description} 列表 —— labels[0] 为首选 |
overall |
一句话描述整个片段 |
usage |
该次调用的 token 计数 |
model、thinking_level |
gemini-3.8-flash、low |
metadata.parquet —— 列参考
7 列,73,500 行 —— 每片段一行:
| 列 | 类型 | 含义 |
|---|---|---|
key |
string |
片段键。这是 tar 成员 stem。 |
cls |
string |
片段生成所用的 vocal-burst 类别。49 个不同值,每类恰好 1,500 个片段 |
seed |
int64 |
生成种子。恰好三个值 —— 1234、5678、9012 —— 各 24,500 个片段 |
gender |
string |
请求的说话者性别 —— male / female,各 36,750 |
age_band |
string |
请求的年龄段 —— young_adult 24,696 / older_adult 24,402 / middle_aged 24,402 |
shard |
string |
tar 文件名,含 .tar 扩展名,例如 shard-00000.tar。74 个不同值 |
prompt |
string |
生成该片段的完整文本提示 |
- 注意
shard的拼写:它带有扩展名。直接用作文件名,不要再次追加.tar。
数据连接(Join)示例
python import tarfile, io, json import pyarrow.parquet as pq
meta = pq.read_table("metadata.parquet") row = meta.slice(0, 1).to_pylist()[0]
with tarfile.open(row["shard"]) as tf: # "shard-00000.tar" — extension included stem = row["key"] # the member stem audio = tf.extractfile(stem + ".mp3").read() gen = json.loads(tf.extractfile(stem + ".json").read()) ann = json.loads(tf.extractfile(stem + ".gemini.json").read())
print(row["cls"], ann["events"][0]["labels"], gen["audio"])
或在忽略 parquet 的情况下流式读取:
python import webdataset as wds ds = wds.WebDataset("shard-{00000..00073}.tar").decode() for r in ds: audio, meta, ann = r["mp3"], r["json"], r["gemini.json"]
均衡性
由构造保证,而非偶然:
| 项目 | 数值 |
|---|---|
| 男性 / 女性 | 36,750 / 36,750 |
| 年轻 / 中年 / 年长成人 | 24,696 / 24,402 / 24,402 |
| 每类 | 1,500(500 条提示 × 3 个种子) |
| 音频 | 32.8 GB |
音频格式
- 160 kbit/s 单声道 48 kHz MP3,由生成器写入 —— 未重新编码,添加标注时也未再次重新编码。
- 打包期间从字节中读回每个文件的 MPEG 帧头;所有 73,500 个均通过,所有 73,500 个键均从写入的 shard 中恰好往返一次。
相关数据集
laion/voice-acting-burst-prompts—— 提示词laion/vocal-bursts-gemini-segments—— 真实语音 burst 片段,CC BY 4.0laion/vocal-burst-classifier-gemini—— 在这些片段上训练的分类器
许可证
音频、提示词、标注和打包均以 CC BY 4.0 发布。
更正(2026-09-04)
本卡片早期版本称发布的 vocal-burst-detector-v2 “使用了 83 个标签中的 8 个”并“发出 Shriek 零次”。该结论基于 60 片段审计,不能推广。在两个完整语料库(72,500 个合成片段和 3,598 条真实话语)上运行,同一检测器在合成半部分发出 41 个不同标签,在真实半部分发出 36 个,并且它确实发出 Shriek —— 在 50 个合成片段和 49 个真实片段上。
60 片段审计实际观察到的是分布的集中程度:仅 Contented Sigh 就占 72,500 个合成片段中的 16,694 个,Surprised Gasp 为 7,451,Wistful Sigh 为 5,437。正确表述是检测器的有效词汇量小,而非其发出的词汇量为 8。本卡片其他地方的结论 —— 检测器是瓶颈,其失败在于粒度而非失聪 —— 未受影响。
类别分组
vocal_burst_groups.json 和 GROUPS.md 携带覆盖 117 个 burst 标签字符串的 23 组方案,将表示相同或非常相似声音的名称分组(snicker/chuckle、shriek/scream、cough/coughing)。在组级别对相同预测评分,平均生成命中率从 0.302 提升至 0.537;具有相同组大小的随机分组达到 0.355,因此 +0.182 归因于分组正确,其余为算术效应。分组使用定向提升而非原始混淆进行检查,因为无论请求什么,两个标签占所有标注者 top-1 调用的 29%,基于原始混淆合并会将生成失败记为命中。
- 对于分类器的训练,保留细粒度类别:折叠它们仅因随机概率上升而提高原始准确率。在评估时分组 —— 可在任意时间点进行,反之则不能。
说明
本数据集中的音频由语音表演 AI 模型生成。