
遇见数据集

touristgpt/Codeforces-COTs

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

Codeforces Trace Dataset是一个基于9,413个Codeforces问题(难度范围800-3500)的合成推理轨迹数据集。每个问题包含结构化的错误路径探索、发现叙述和伪代码,旨在教模型如何思考竞争性编程问题,而不仅仅是解决它们。数据集捕捉完整的推理过程,包括:1. 错误路径——详细探索无效方法及其失败原因;2. 发现叙述——第一人称视角描述如何从失败方法转向正确方法,并逐步跟踪示例;3. 伪代码——为正确方法提供清晰、可实现的伪代码;4. 新问题——包含新竞赛的问题和Open-r1数据集的所有问题。数据集模拟专家思考方式,尝试想法、遇到障碍、从失败中提取见解并构建解决方案。数据集结构分为两个难度层级(≤1700和≥1800),包含22个字段,涵盖问题元数据和生成轨迹字段。生成管道使用DeepSeek V3.2的三阶段流程。数据集可用于SFT训练、过程监督、错误路径学习和课程学习。

Codeforces Trace Dataset is a synthetic reasoning-trace dataset built from 9,413 Codeforces problems (800–3500 rating). Each problem includes structured wrong-path explorations, discovery narratives, and pseudocode designed to teach models how to think through competitive programming problems, not just solve them. The dataset captures the full reasoning process, including: 1. Wrong paths—detailed explorations of approaches that dont work, including why they fail; 2. Discovery narrative—a first-person account of pivoting from failed approaches to the correct one, with worked examples traced step-by-step; 3. Pseudocode—clean, implementation-ready pseudocode for the correct approach; 4. Newer Questions—questions from newer contests and all questions from the Open-r1 dataset. The dataset models how an expert thinks—trying ideas, hitting walls, extracting insights from failures, and building toward the solution. The dataset structure has two tiers based on difficulty (≤1700 and ≥1800), with 22 columns covering problem metadata and generated trace fields. The generation pipeline uses a 3-stage process with DeepSeek V3.2. The dataset is intended for SFT training, process supervision, wrong-path learning, and curriculum learning.
提供机构:
touristgpt
搜集汇总
数据集介绍
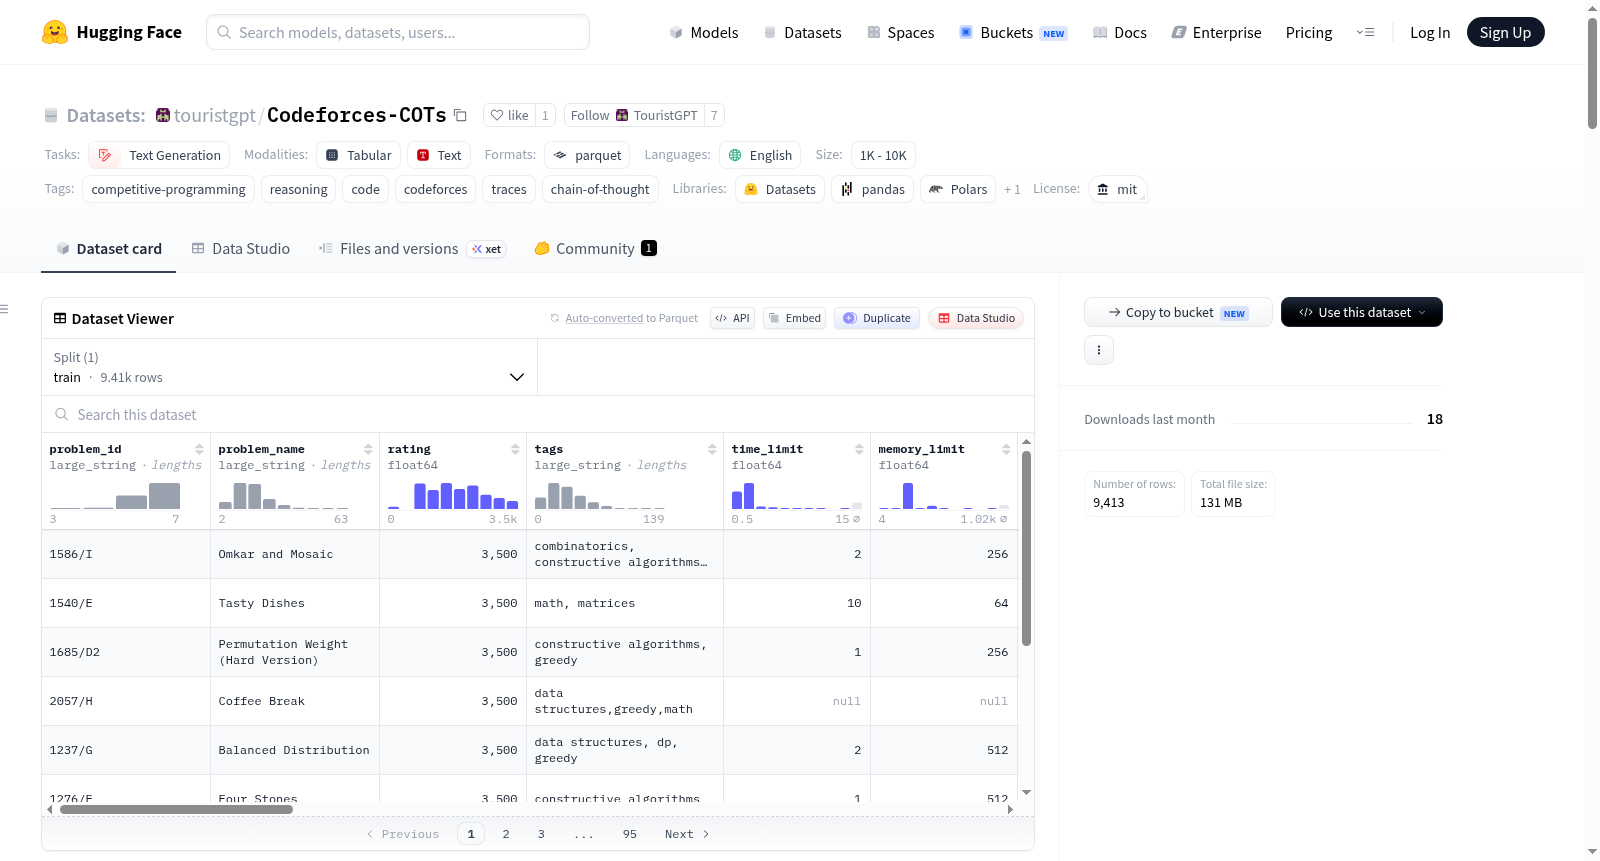
touristgpt/Codeforces-COTs 数据集图片
构建方式
Codeforces-COTs数据集的构建基于**9,413道Codeforces问题**,难度评级覆盖800至3500,旨在模拟专家解决竞赛编程题时的完整思维过程。数据集采用DeepSeek V3.2模型通过三阶段流水线生成:第一阶段针对每道问题及其官方题解,生成若干看似合理却错误的试错路径,并辅以一个指向正确解法的提示;第二阶段为每条错误路径构建详尽的探索过程,展示解题者尝试、碰壁并从失败中汲取教训;第三阶段则在错误路径与提示的上下文基础上,生成第一人称的发现叙事与实现伪代码。对于评级≤1700的题目,采用简化的单次调用流水线直接生成推理过程。所有内容均经判别模型评估质量,确保错误路径的合理性与可学习性。
特点
该数据集的核心创新在于其对推理过程的**高度结构化建模**,将专家思维分解为试错、洞察与收敛三个可复现的组件。数据集中包含分类明确的错误路径探索(最多四条)、第一人称发现叙事和可直接实现的伪代码,其中错误路径的格式因难度而异:简单题提供简短描述,难题则呈现长篇第一人称探索记录。难点题目的发现叙事严格遵循“承认失败—顿悟转折—逐步推导—实例验证—结构总结”的连贯结构。此外,数据集为每道题目提供了独特的解题提示(hint),量化统计显示平均叙事长度约17,800字符,伪代码约3,200字符,43.5%的题目包含三条错误路径,4.4%包含四条,形成了丰富的推理教学资源。
使用方法
用户可通过HuggingFace的datasets库直接加载数据,使用`load_dataset`函数获取训练集,并利用`filter`方法根据难度评级筛选特定题目。例如,选择评级≥2400的难题后,可访问其错误路径探索、发现叙事与伪代码字段进行训练或分析。此外,数据集以Parquet格式提供,便于使用pandas进行大规模数据处理,如筛选包含三条以上错误路径的样本。数据集适用于监督式微调训练、过程监督模型、错误路径学习以及课程学习等多种场景,其模块化的结构支持用户灵活定制:可根据需求在正确路径前拼接任意数量的错误路径探索,或仅保留正确推理部分,从而适配不同的推理模型训练目标。
背景与挑战
背景概述
在算法竞赛与程序合成领域,多数数据集仅提供问题与标准解答的配对,忽视了人类解题过程中试错与推理的认知本质。Codeforces-COTs 数据集由研究团队于2024年创建,基于 Codeforces 平台 9413 道题目(难度评级 800–3500),包含完整的错误路径探索、发现叙事及伪代码。其核心创新在于捕获专家级程序员‘假设—失败—洞察—修正’的思维链条,将稀疏的解题表征转化为结构化推理轨迹。该数据集对训练大语言模型的链式推理能力具有里程碑意义,为过程监督、课程学习及错误路径学习提供了高保真资源,推动了从答案匹配向认知过程建模的范式转变。
当前挑战
领域层面,现有程序合成方法往往忽略错误路径的教育价值,模型缺乏从失败中自我修正与泛化推理的能力;该数据集通过构建包含多重试错轨迹的样本,迫使模型学习假设验证与策略切换的元认知技能。构建过程中,团队面临两大挑战:一是确保合成错误路径的‘合理但错误’性,利用裁判模型筛选伪正解并避免可行替代方案的污染;二是针对不同难度题目设计差异化的生成流水线——对低难度题直接提取正确推理链,对高难题(≥1800)启用三阶段叙事框架,在保证质量的同时控制生成成本。此外,约1.8%题目因元数据缺失及极少数愚人节题目的干扰,需人工过滤以维护数据集纯净度。
常用场景
经典使用场景
Codeforces-COTs数据集专为强化推理模型的思维链能力而设计,尤其在竞赛编程领域。其经典使用场景在于通过结构化探索路径、发现叙事和伪代码,引导模型学习专家如何系统性地解决高难度编程问题。数据集覆盖800至3500分的Codeforces题目,按难度分为两档:1700分以下提供简短的错误路径描述与思维链,1800分以上则包含完整的错误路径探索、第一人称发现叙事及实现伪代码。这种分层设计使得研究者能够根据不同难度等级,灵活应用于模型推理过程的监督微调(SFT),从而提升模型对复杂问题的逻辑分解与逐步解决能力。
衍生相关工作
Codeforces-COTs衍生了一系列关键研究工作。首先,其结构化推理轨迹启发了思维链蒸馏(Chain-of-Thought Distillation)的新方法,研究者可基于此训练轻量级模型复现专家级推理过程。其次,数据集中“提示”(Hint)字段催生了Hint-Augmented Fine-Tuning范式,无需显式答案即可引导模型自主推导。此外,多级错误路径设计被应用于对抗性训练和过程监督信号提取,相关工作在提升模型对边界问题的敏感度上取得突破。最后,该数据集的分层难度结构(800-3500分)为课程学习(Curriculum Learning)提供了天然基准,推动了从简单到复杂逐步递进的模型训练策略研究,尤其在需要长链条推理的数学与代码任务中成果显著。
数据集最近研究
最新研究方向
当前,Codeforces-COTs数据集在编程竞赛推理领域开创了全新的研究范式,其核心创新在于首次系统性地将人类专家解决算法问题时的试错思维过程结构化。该数据集不仅记录最终的正确解法,更详尽地捕捉了错误的探索路径、从失败中提取的洞见以及逐步推导的思维链,特别是针对1800分以上的高难度题目,采用了包含错误路径探索、发现叙事和伪代码的三阶段生成流程。这一设计紧密关联了大型语言模型在复杂推理任务中的前沿方向——过程监督与错误路径学习,使得模型能够模仿人类编程专家“尝试-失败-反思-构建”的自然思维模式,而非简单的答案匹配。通过与DeepSeek V3.2等先进模型的深度结合,该数据集为推理模型的SFT训练提供了高质量的思维链语料,对于培养模型识别早期错误信号、进行假设验证并最终收敛至正确解的能力具有里程碑式的意义,显著推动了从“结果导向”到“过程导向”的推理研究转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

