
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-8B_strategy_trust_t1.25_g7_run2_metrics
收藏数据链接:
官方服务:
资源简介:
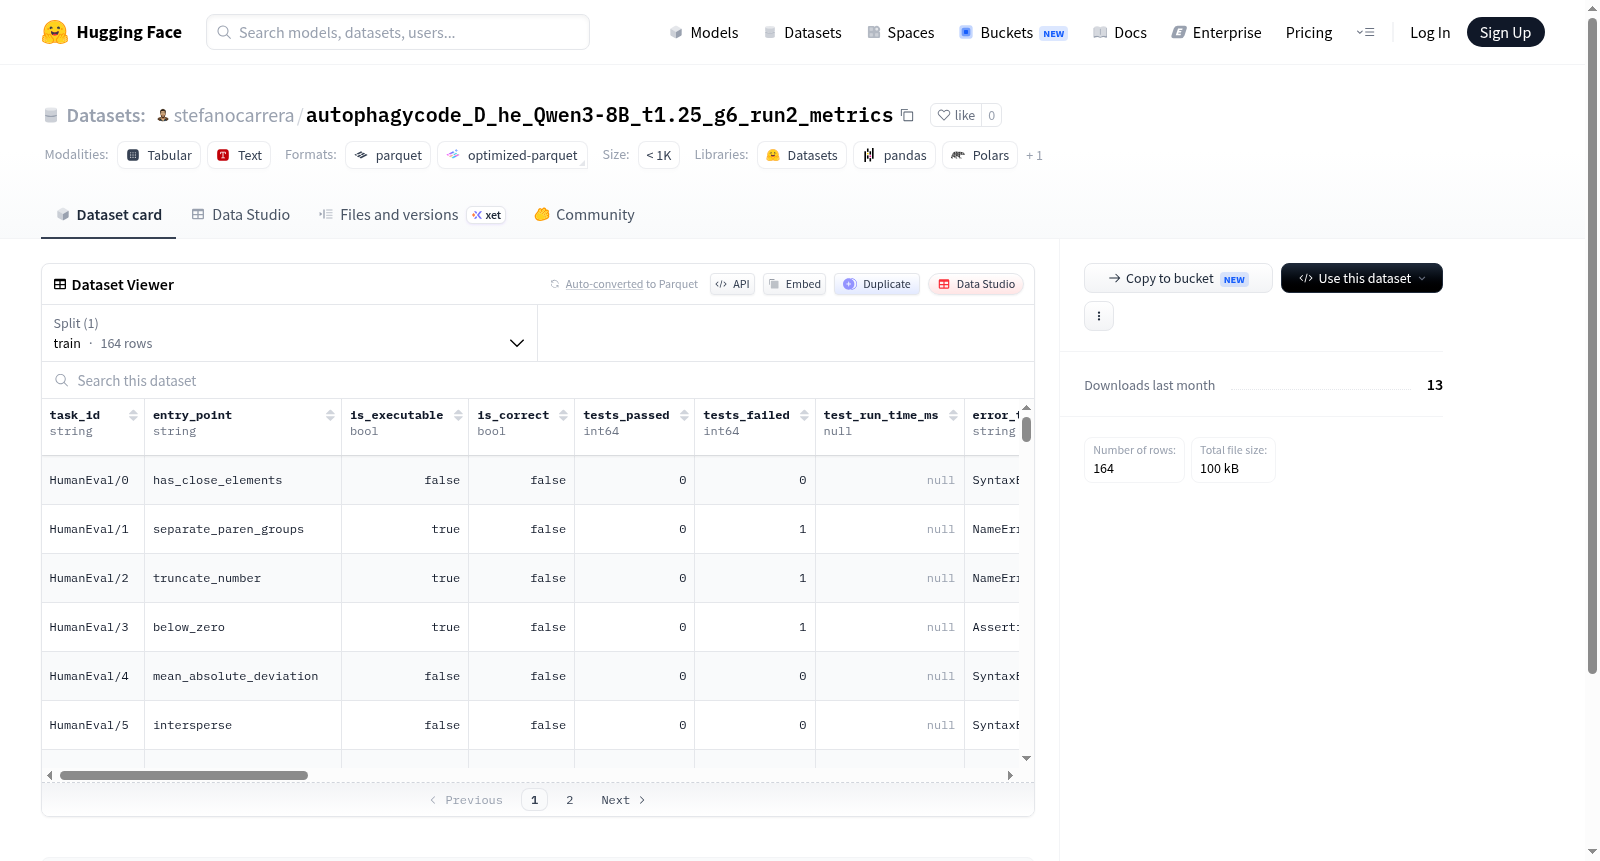
该数据集包含164个训练样本,用于分析代码任务的相关指标。特征包括任务ID、入口点、可执行性、测试通过/失败数、错误类型、代码复杂度度量(如Halstead指标、圈复杂度、可维护性指数)、代码行数、注释百分比、词汇多样性(TTR)、熵值等。数据集可能用于评估代码质量或编程任务性能,但具体用途未在README中明确说明。
This dataset contains 164 training samples for analyzing metrics related to code tasks. Features include task ID, entry point, executability, tests passed/failed, error type, code complexity measures (e.g., Halstead metrics, cyclomatic complexity, maintainability index), lines of code, comment percentage, lexical diversity (TTR), entropy values, and more. The dataset may be used for evaluating code quality or programming task performance, but specific use cases are not explicitly described in the README.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集源于对代码生成模型Qwen3-8B进行策略性评测的产物。研究者为模型设定了信任系数1.25与生成轮数7的配置,并实施了两轮运行以采集数据。构建过程聚焦于代码执行结果的细粒度量化,记录了每个任务实例的通过测试数、失败测试数及执行耗时,同时融合了Halstead复杂度、圈复杂度与维护性指数等静态软件度量指标,从而构建起一个兼具动态执行反馈与静态代码质量评估的多维评测基准。
使用方法
使用时可直接加载train分片中的数据,特征已预定义为规范的字段类型,便于接入机器学习管线。研究者可基于'tests_passed'与'tests_failed'字段构建代码正确性分类任务,或利用Halstead复杂度与维护性指数等连续特征进行代码质量回归分析。数据集亦适合用于探究预测熵与代码执行成功率之间的关联,为评估语言模型生成代码的鲁棒性提供量化支撑。
背景与挑战
背景概述
该数据集由研究人员基于Qwen3-8B模型在编程任务验证过程中构建而成,聚焦于代码生成质量与可执行性评估。其核心研究问题在于通过多元代码复杂度度量指标(如圈复杂度、Halstead复杂度)以及预测熵等统计特征,系统性地剖析模型生成代码的结构特性与功能性缺陷。数据集收录了164条训练样本,涵盖任务标识、执行状态、测试通过率及代码风格参数等维度,致力于弥合大语言模型代码生成能力与软件工程实践之间的鸿沟,为自动化代码质量评估与模型鲁棒性改进提供了珍贵的标注数据资源。
当前挑战
数据集面临的首要挑战在于代码生成领域评估体系的不完备性——传统基于测试用例的判定无法有效反映代码的可维护性与可理解性,而数据集中丰富的复杂度指标虽提供了多视角分析框架,却需进一步验证其与真实部署场景的关联度。构建过程中,研究者遭遇了执行环境动态变化导致的测试结果复现困难、空值运行时数据处理的规范化问题,以及任务重复识别(如entry_point_repeated字段)等衍生的数据清洗复杂性,这些技术瓶颈显著提升了数据集构建的门槛与验证成本。
常用场景
经典使用场景
该数据集专为评估大语言模型(LLM)在自动化代码生成任务中的表现而设计,尤其聚焦于可信度与策略一致性。其核心用途在于度量模型生成的代码是否严格遵循给定函数签名(entry_point),以及能否通过预定义的测试用例。通过记录代码的测试通过/失败数量、运行时错误类型等指标,研究者可以精准量化模型在解决特定编程问题时的功能性正确性与鲁棒性。此外,数据集还收录了代码的静态复杂度特征(如圈复杂度、Halstead度量)与信息论指标(如香农熵),使得经典的代码质量与生成置信度联合分析成为可能。
解决学术问题
该数据集解决了当前代码生成领域一个关键学术难题:如何系统性地评估模型输出在功能正确性之外的隐性特征,包括代码的可维护性、认知复杂度以及模型的预测不确定性。传统评测多依赖测试通过率单一维度,而此数据集通过引入Halstead难度与工作量、维护性指数、预测熵等多元指标,使得研究者能够深入剖析‘通过测试的代码是否真的优质’,并探究模型在歧义边界处的行为模式。这对理解大型语言模型的泛化边界、授信机制以及代码生成的认知负荷模型具有里程碑式的学术意义。
实际应用
在实际工程实践中,该数据集可被集成至自动化代码审查与持续集成(CI)流水线中,用于筛选和预警低质量或高风险的模型生成代码。例如,当模型生成的代码虽通过了功能测试但拥有过高的圈复杂度或极低的维护性指数时,系统可自动标记并提示人工介入重构。同时,基于预测熵与测试运行时间等指标,开发者能够量化部署前的算力成本与潜在故障概率,从而在自动驾驶、金融交易等对代码可靠性要求严苛的领域内,构建起一道基于数据驱动的代码可信过滤屏障。
数据集最近研究
最新研究方向
该数据集聚焦于代码生成模型的执行反馈与可执行性评估,融合了静态代码度量(如Halstead复杂度、圈复杂度、可维护性指数)与动态执行结果(如测试通过/失败计数、错误类型),为评估Qwen3-8B等大语言模型在编程任务中的真实代码生成质量提供了多维量化指标。在当前大模型编程能力激烈竞争的背景下,该数据集从可执行性和代码工程属性双重视角揭示了模型生成代码的健壮性与可维护性,为引导模型向实用化、高可靠性方向演进提供了关键评测基准,具有推动AI编程从代码补全迈向可信执行验证的前沿意义。
以上内容由遇见数据集搜集并总结生成


