
DCAgent/Kimi-2.6-exp-gfi-swesmith-random-filtered-10K-maxeps-32k
收藏数据链接:
官方服务:
资源简介:
该数据集包含多轮对话数据,涉及不同代理和模型提供者,记录对话内容、角色、任务类型、日期、运行ID、试验名称、结果和验证器输出等信息,适用于对话系统、任务执行和模型评估等研究。
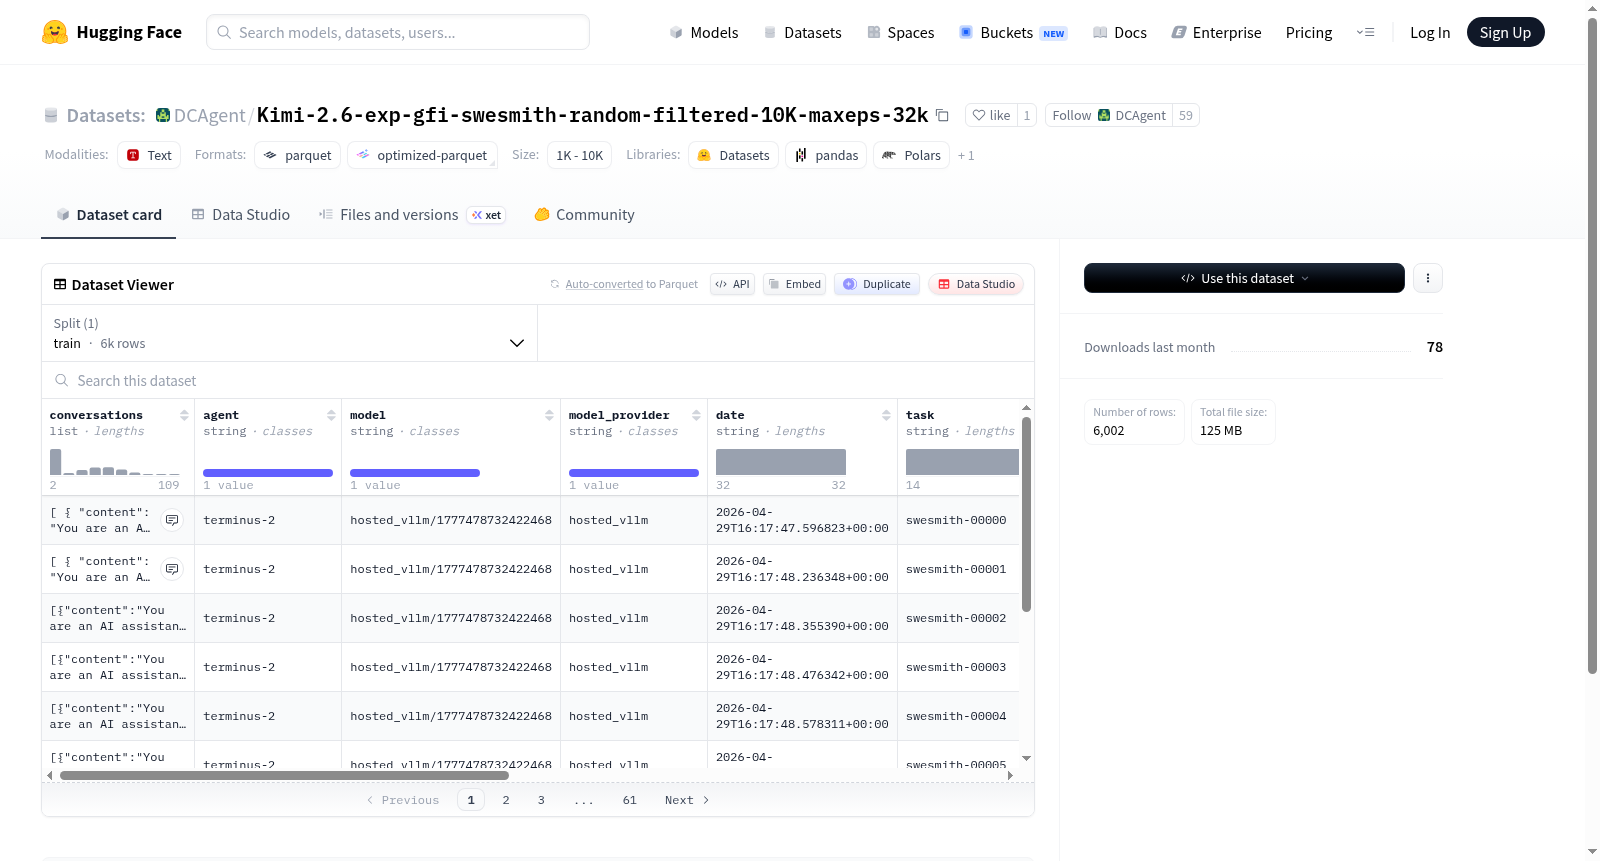
This dataset contains multi-turn conversation data involving different agents and model providers, recording conversation content, roles, task types, dates, run IDs, trial names, results, and verifier outputs, suitable for research in dialogue systems, task execution, and model evaluation.
提供机构:
DCAgent搜集汇总
数据集介绍
构建方式
该数据集基于Kimi-2.6-exp模型在特定推理任务中生成的轨迹数据构建而成。原始数据经gfi与swesmith两种过滤策略筛选,结合随机采样方法,从大规模生成结果中抽取10,000条样本,并设置最大上下文窗口为32k tokens,以确保数据质量与多样性的平衡。每条记录包含完整的对话历史(conversations)、模型标识(model)、任务类型(task)及验证器输出(verifier_output)等字段,最终以JSON格式存储,便于后续解析与处理。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,使用load_dataset函数指定数据集名称即可获取训练拆分(train),共包含6,002个样本。每条数据以字典形式提供,可便捷提取conversations字段作为模型输入,或利用result与verifier_output字段进行监督微调或强化学习。建议根据任务需求对对话长度进行截断或填充,以适配不同模型的token限制。此外,数据集的字段结构清晰,便于快速进行数据筛选与分析。
背景与挑战
背景概述
在大语言模型(LLM)快速迭代的背景下,针对特定模型的高质量微调数据成为推动模型能力跃升的关键。Kimi-2.6-exp-gfi-swesmith-random-filtered-10K-maxeps-32k数据集由月之暗面(Moonshot AI)团队于近期构建,旨在为Kimi 2.6实验版模型提供经过精细筛选与过滤的训练样本,核心研究问题聚焦于如何通过数据质量优化提升多轮对话与任务执行能力。该数据集包含6002条训练样本,每条样本均记录了完整的对话历史、模型输出、任务类型及验证结果等结构化信息,为深入分析模型在复杂交互场景中的表现提供了坚实基础。其独特的“随机过滤”与“最大回合数限制”策略,开创了针对长上下文场景的数据精简范式,对后续LLM微调数据集的设计产生了重要启示。
当前挑战
该数据集旨在解决大语言模型在长上下文对话与多步骤推理任务中表现不稳定这一领域难题,要求模型在复杂交互中保持逻辑连贯与准确响应。构建过程中面临的核心挑战包括:其一,原始数据噪声大,需设计高效的过滤机制去除低质量或无关样本,同时保留有助于提升模型泛化能力的关键实例;其二,由于数据源自特定实验版本模型(Kimi-2.6-exp),模型自身的输出偏差可能未被完全消除,导致数据集中隐含偏好倾向,影响微调模型的公平性与鲁棒性;其三,10K规模的约束迫使团队在信息密度与样本多样性之间寻求平衡,如何在有限样本量下覆盖更广泛的任务类型,对数据抽样策略提出了极高要求。
常用场景
经典使用场景
Kimi-2.6-exp-gfi-swesmith-random-filtered-10K-maxeps-32k数据集蕴含了海量多轮对话交互数据,其经典使用场景在于训练与微调大型语言模型。研究者可借助其中涵盖agent、model、task等多维标注信息的对话样本,提升模型在复杂任务指令下的理解与生成能力。该数据集特别适用于构建具备工具调用与自主规划能力的对话智能体,通过模拟真实用户与系统的交互过程,使模型学会在长上下文窗口内进行精准推理与响应。此外,其丰富的角色标注和结果验证字段,使得强化学习与偏好对齐训练成为可能,为打造更贴合人类意图的语言模型提供了坚实的数据基础。
解决学术问题
该数据集精准回应了当前学术领域关于大型语言模型对齐与泛化能力的核心挑战。它有效解决了如何在大规模多轮对话场景中,捕捉用户真实意图并实现高保真度交互响应的难题。通过纳入verifier_output和result等验证性标注,数据集为研究模型回答的正确性与可靠性提供了监督信号,从而攻克了在复杂任务中评估与提升模型推理质量的学术瓶颈。同时,其随机过滤策略与长上下文限制(32k maxeps)确保了数据的高质量与多样性,有助于探索模型对长序列信息的记忆与利用机制,为可解释性与鲁棒性研究开辟了新的实验路径。
实际应用
在实际应用层面,该数据集直接服务于智能客服、虚拟助手与自动化工作流编排系统的开发。模型中通过该数据集微调后,能够更从容地应对金融、医疗、教育等垂直领域的复杂用户需求,例如在需要多步推理的病例咨询或法律条款解析中,生成既准确又具备上下文连贯性的答复。此外,agent和trace_source字段的存在,使得训练出的模型可以担任多智能体系统中的协调角色,实时响应环境变化并动态调整任务策略。在电商导购与技术支持场景中,该数据集还能显著提升对话系统的意图识别准确率与任务完成率,从而优化用户体验并降低人工介入成本。
数据集最近研究
最新研究方向
在多智能体协作与强化学习领域,Kimi-2.6-exp-gfi-swesmith-random-filtered-10K-maxeps-32k数据集聚焦于大规模对话轨迹的精细筛选与高效利用。该数据集基于前沿的生成式过滤与随机采样策略,从海量交互数据中提取了约6000条高质量训练样本,每条样本包含完整的对话历史、角色扮演、任务标识及验证器输出等元信息。其设计理念与当前大语言模型作为智能代理的热点研究高度契合,旨在通过稀疏化、高信噪比的训练数据提升模型在复杂任务链中的推理与决策能力。该数据集的发布不仅为多轮对话中的反馈优化提供了标准化的基准资源,更推动了从通用语言理解到具身智能体的能力跃迁,对构建可解释、可追溯的自主代理系统具有里程碑式的意义。
以上内容由遇见数据集搜集并总结生成


