
Jake/glokta-public
收藏官方服务:
资源简介:
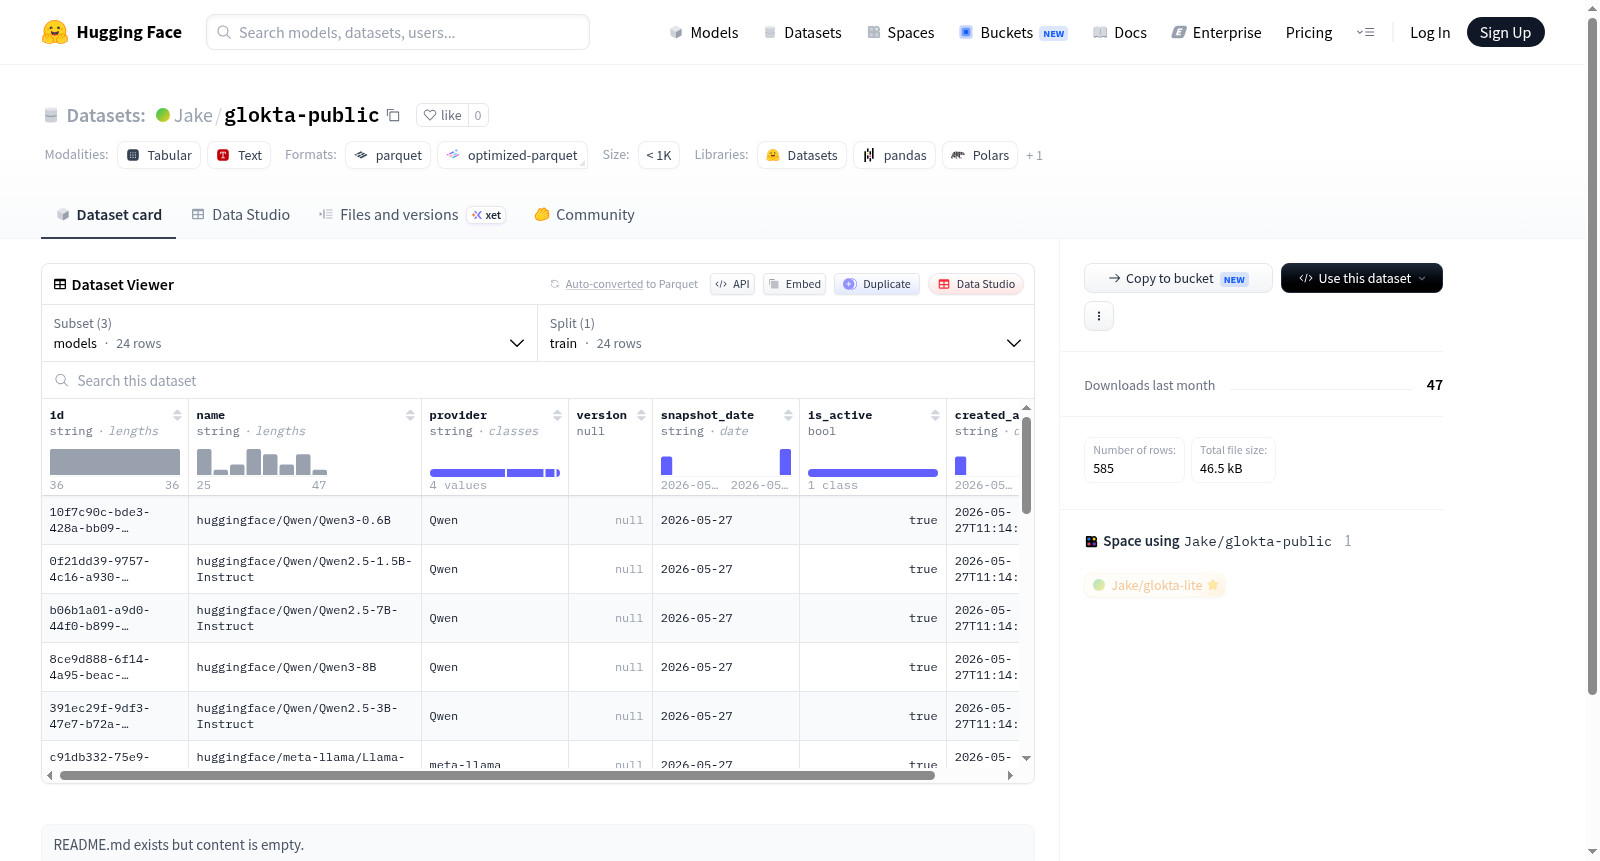
该数据集包含三个子集:models、probe_results和runs。models存储模型的基本信息,如ID、名称、提供商、版本、快照日期、活跃状态和创建时间;probe_results记录探测结果,包括探测名称、类别、检测器、通过/失败计数和分数;runs追踪运行记录,包含模型ID、触发者、状态、开始/完成时间、garak版本等。整体用于收集和分析AI模型在安全探测中的表现。
This dataset contains three subsets: models, probe_results, and runs. The models subset stores basic information about AI models, such as ID, name, provider, version, snapshot date, active status, and creation time. The probe_results subset records probe results, including probe name, category, detector, pass/fail counts, and scores. The runs subset tracks run records, including model ID, triggered_by, status, start/completion time, garak version, etc. Overall, it is used to collect and analyze the performance of AI models in security probes.
提供机构:
Jake搜集汇总
数据集介绍
构建方式
在人工智能安全评估领域,系统性检测语言模型脆弱性至关重要。glokta-public数据集由三个核心配置组成:models、probe_results与runs,分别对应模型元数据、探针测试结果及运行记录。其中models配置收录了24个模型样本,涵盖名称、提供商、快照日期及活跃状态等关键属性;probe_results配置包含524条探针执行记录,以通过失败计数与得分量化模型对特定探测的响应;runs配置则记录了37次完整评估过程的元数据,包括触发方式、状态及配置哈希。数据集各配置均以独立文件夹组织训练分割,采用Parquet格式存储,兼顾高效读取与压缩存储。
特点
该数据集最显著的特点在于其结构化的多维度评估框架。通过将模型信息、探针测试与运行日志分离存储,研究人员可灵活关联模型版本与探测结果,追溯每次评估的完整上下文。probe_results配置中的探测器类别与探针名称字段,支持对模型在对抗攻击、逻辑推理等特定维度的脆弱性进行精确度量。此外,runs配置中garak_config字段保留完整评估配置,结合时间戳与状态标记,便于复现实验与审计评估流程。这种层级分明的设计,为构建可重复的大语言模型安全基准提供了标准化数据基础。
使用方法
使用glokta-public数据集时,推荐通过Hugging Face Datasets库加载特定配置,例如以load_dataset('glokta-public', 'probe_results')方式获取探针结果。研究人员可借助pandas等工具分析probe_results中的得分分布,识别模型薄弱领域;或通过runs配置中的completed_at与garak_version字段,追溯不同时间点模型安全性能的变化趋势。models与其他配置的交叉查询,则能揭示提供商、模型版本与安全性之间的潜在关联。所有数据均以只读方式提供,建议用户结合官方garak工具进行扩展探测,以动态丰富评估结果集。
背景与挑战
背景概述
该数据集名为glokta-public,由相关研究团队创建,旨在系统性地评估大规模语言模型的安全性。数据集记录了模型在各类安全探测(probe)中的表现,包括探测名称、类别、通过率与得分等关键指标,为理解模型在面对恶意输入或越狱攻击时的脆弱性提供了结构化数据。其核心研究问题聚焦于如何量化模型安全响应的一致性,并推动模型安全评估的标准化。通过公开多个模型的探测结果,该数据集为学术界和工业界提供了可复现的基准,促进了语言模型安全领域的发展。
当前挑战
该数据集所解决的领域问题在于,当前大规模语言模型的安全评估缺乏统一框架,模型可能被诱导生成有害内容或泄露敏感信息,这一挑战亟需系统化的测试方法。构建过程中,团队面临如何设计广泛覆盖各类攻击模式的探测(probe)的难题,同时需确保探测结果的可比性与可解释性。此外,数据收集涉及多个模型版本的持续跟踪,版本管理与结果一致性维护成为技术瓶颈。数据集规模相对有限(24个模型、524条探测结果),如何扩展以涵盖更多模型与攻击类型,是未来持续优化的关键挑战。
常用场景
经典使用场景
glokta-public数据集专为大规模语言模型的安全性与鲁棒性评估而设计,其核心用途在于系统性地检测模型在对抗性探测下的脆弱表现。研究者借助该数据集,可通过配置不同种类的探测任务(probe),如越狱攻击、毒性生成或逻辑误导,量化评估模型在各类风险场景中的防御能力。数据集中包含的模型元信息、运行参数及逐项探测结果,使得对模型行为的多维度剖析成为可能,为深入理解语言模型的潜在安全隐患奠定了数据基础。
实际应用
在实际部署中,glokta-public数据集为AI安全审计与模型风控提供了关键支持。企业或研究机构可利用其中的探测结果数据库,对即将上线的语言模型进行全面的安全压力测试,快速识别模型在生成有害内容、泄露敏感信息或遵从恶意指令方面的薄弱环节。此外,基于该数据集的持续监测机制能够追踪模型更新或迭代后的安全性能漂移,为负责任的AI治理与合规审查提供了权威的数据依据。
衍生相关工作
基于glokta-public,学术界涌现了一系列关于对抗性探测优化与模型护栏加固的衍生工作。研究者提出通过分析数据集中失败案例的分布模式,开发更高效的自动探测策略以发现潜在的安全漏洞。同时,该数据集也催生了多种针对性的防御机制评估基准,例如比较不同红队测试工具在检测能力上的覆盖度与准确性。这些工作共同构筑了语言模型安全评估的实证研究生态,促进了从理论防护到工程落地的知识迁移。
以上内容由遇见数据集搜集并总结生成


