
遇见数据集

MM-Hallu/BEAF

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

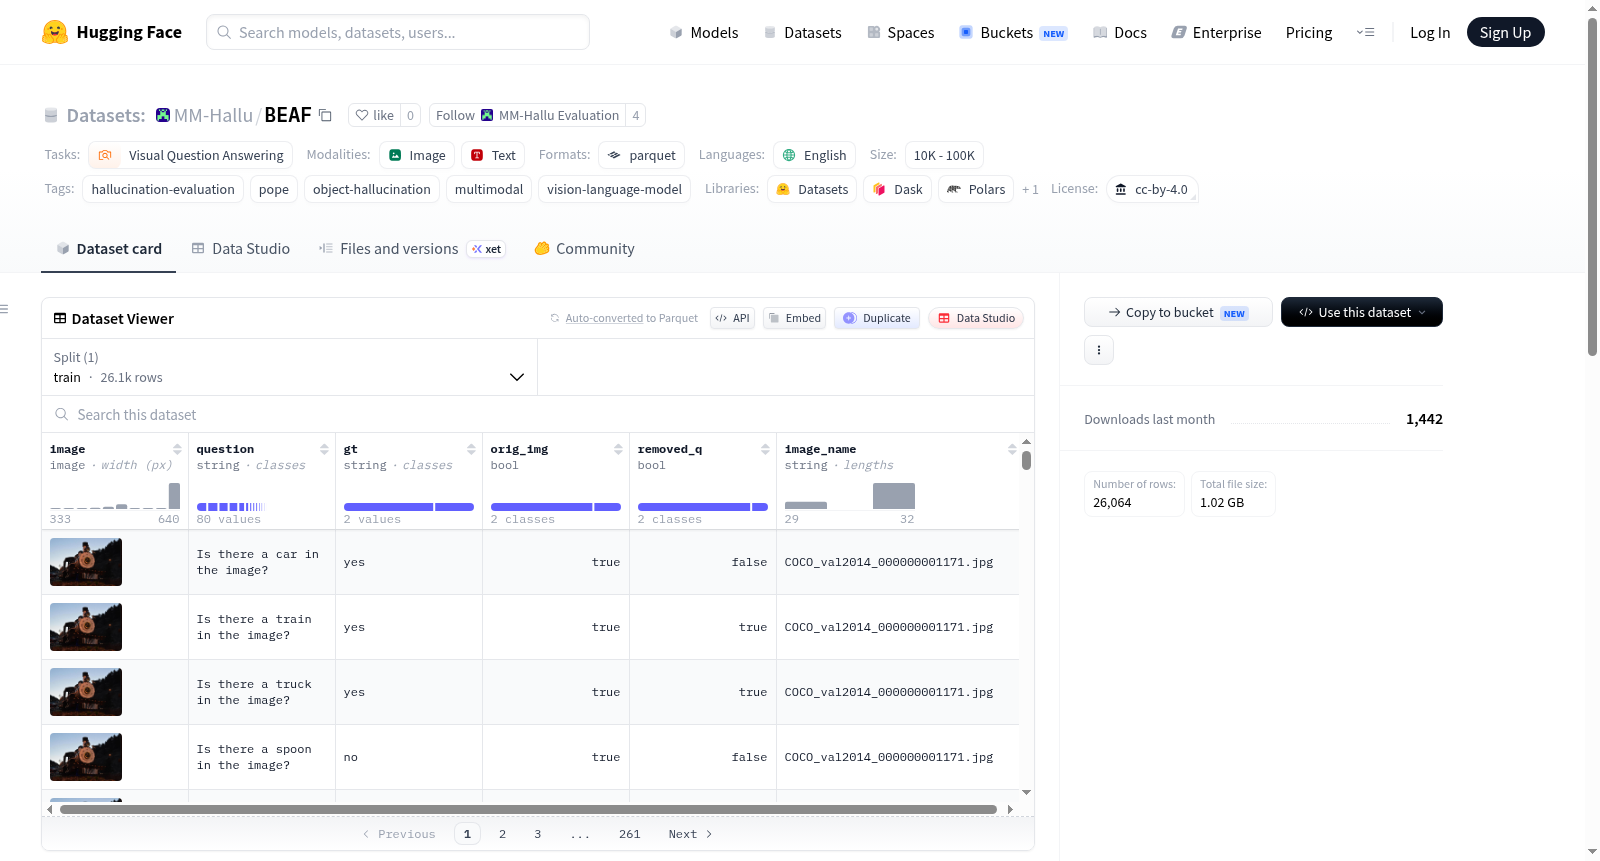
BEAF是一个用于评估视觉语言模型中对象幻觉的基准数据集,通过前后图像对比的方式构建。数据集包含26,064个问答对,覆盖2,223张图像(500张原始COCO图像和1,723张经过处理的图像)。每个数据样本包含图像、问题、真实答案等字段。问题采用POPE风格的二元问答形式,询问图像中是否存在特定对象。数据集还标注了图像是否为原始COCO图像、问题是否涉及被移除的对象等信息。问题分为四类:原始图像中存在的对象、原始图像中将被移除的对象、处理后图像中被移除的对象以及处理后图像中仍然存在的对象。评估指标包括准确率、精确率、召回率和F1分数。数据来源于ECCV 2024的BEAF项目。

BEAF is a benchmark for evaluating object hallucination in vision-language models using before-after image manipulation pairs. 26,064 QA pairs over 2,223 images (500 original COCO images + 1,723 manipulated images) with POPE-style yes/no questions. Each data sample includes fields such as image, question, ground truth answer, and annotations indicating whether the image is original COCO or whether the question refers to a removed object. Questions are categorized into four types: present objects in original images, to-be-removed objects in original images, removed objects in manipulated images, and remaining objects in manipulated images. Evaluation metrics include Accuracy, Precision, Recall, and F1. The data originates from the BEAF project presented at ECCV 2024.
提供机构:
MM-Hallu
搜集汇总
数据集介绍
MM-Hallu/BEAF 数据集图片
构建方式
BEAF数据集专为评估多模态大模型中的对象幻觉现象而设计,其构建基于图像编辑前后的对比策略。数据源自COCO数据集中的500张原始图像,并通过对这些图像进行物体移除操作,生成了1,723张经编辑的图像,共计2,223张图像。每张图像均配以POPE风格的二元问答对,问题形式为“图像中是否存在某对象?”,最终形成26,064个问答样本。数据集中标注了图像是否经过编辑(orig_img)以及问题是否指向被移除对象(removed_q),从而系统性地覆盖了原始与编辑场景下的对象存在与否的四种逻辑情形。
特点
BEAF数据集的核心特点在于其通过前后图像变化模拟了视觉语言模型在对象存在性判断中的常见错误模式。它区分了四种关键问题类型:原始图像中对象存在的稳定情形、原始图像中即将被移除对象的存在情形、编辑图像中被移除对象的不存在情形,以及编辑图像中未被移除对象的稳定情形。这种结构化设计使得数据集能够精准定位模型在物体级幻觉上的表现差异,并提供了全面的评估指标,包括准确率、精确率、召回率和F1分数。
使用方法
BEAF数据集适用于多模态大模型的幻觉检测与鲁棒性测试。使用时,模型需针对每张输入图像回答“是”或“否”的二元问题,答案应与给定的真实标注(gt)严格一致。评估过程通过计算二元分类指标(如准确率和F1分数)来衡量模型对不同类型问题的表现。该数据集以Parquet格式存储,可通过HuggingFace Datasets库加载,并支持标准的大视觉语言模型评估流程,便于研究者复现并对比模型在对象幻觉任务上的性能。
背景与挑战
背景概述
视觉语言模型(VLM)在理解图像内容方面取得了显著进展,但其生成描述时容易产生对象幻觉(object hallucination),即回答中存在图像中不存在的物体,这一问题严重限制了模型在实际应用中的可靠性。为系统评估和缓解这一缺陷,BEAF(Before-After Changes for Hallucination Evaluation)基准数据集于2024年由研究团队在ECCV会议上提出,核心基于POPE风格的二分类问答范式。该数据集巧妙利用图像编辑前后的变化对(before-after manipulation pairs),构建了包含26,064个问答对及2,223张图像的评测体系,其中500张源自COCO原始图像,1,723张为经过物体移除或保留的操纵图像。通过引入原始与操纵图像的稳定对象和待移除对象四类问题,BEAF为精细化诊断VLM的幻觉倾向提供了标准化测试平台,在多模态幻觉评估领域产生了重要影响。
当前挑战
BEAF所解决的领域核心挑战在于视觉语言模型普遍存在对象幻觉现象:模型在回答“图像中是否存在某物体”时,常因对视觉特征与语言先验的过度依赖而错误肯定不存在的物体,导致可信度下降。这对安全敏感场景如医疗影像解读、自动驾驶交互构成显著威胁。在数据集构建过程中,挑战主要体现在图像操纵的精准性与类别平衡设计上:需严格确保被移除物体在视觉上完全消失且不留下伪影,同时维持其余场景内容的高度一致性,以避免引入额外混淆变量。此外,如何在有限图像数量下生成足够多样且分布均衡的正负样本,使得每个操纵图像均能同时贡献稳定提问与移除提问,也是一项需要精密策划的难题。
常用场景
经典使用场景
BEAF数据集专为评估视觉语言模型(VLM)中的物体幻觉现象而设计,其核心应用在于通过对比原始图像与经过编辑操作的图像对,构建前后变化驱动的问答基准。该数据集包含超过2,200张图像和26,000余对是非型问题,采用POPE风格提问方式,要求模型判断图像中是否存在特定物体。经典使用方式是将原始COCO图像中存在的物体通过编辑移除,形成新图像,随后对移除前后的图像分别提问,考察模型能否正确识别物体状态的变化。这种设计巧妙地将幻觉检测转化为对动态场景理解的评估,广泛应用于多模态模型的鲁棒性测试与幻觉分析。
实际应用
在实际应用中,BEAF基准可嵌入视觉问答系统的开发与部署流程,作为模型出厂前的幻觉测试套件。在医疗影像诊断场景中,模型可能因训练数据偏差而幻觉出本不存在的病灶,使用BEAF的编辑对比逻辑可评估诊断模型对图像变异的敏感度。在自动驾驶感知模块中,该数据集可用于检验视觉模型是否错误感知被障碍物遮挡或已消失的元素,提升环境理解的可靠性。此外,在智能客服、图像描述生成以及基于内容的推荐系统等场景中,BEAF帮助开发者识别并修正模型过度臆测视觉内容的倾向,从而显著降低用户误导风险,增强多模态系统的可信度与安全性。
衍生相关工作
BEAF数据的提出催生了一系列关于视觉语言模型幻觉的经典后续工作。其中,POPE(Polling-based Object Probing Evaluation)评估方法作为本数据集的底层框架,被后续研究广泛引用以标准化幻觉度量。针对BEAF揭示的物体移除后模型仍坚持回答“存在”的问题,研究者陆续提出了判别性训练策略,如通过对比学习和负采样增强模型对物体存在性的敏感度。此外,基于BEAF的编辑逻辑,衍生出图像差异感知模块和因果介入方法,用于分离视觉特征与语言先验的混淆效应。ECCV 2024论文中对多款主流VLM(如CLIP、BLIP-2、LLaVA等)的评测结果,也构成了后续模型改进的重要参考基线。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

