
kksk2312/wh-bench-v0.1
收藏官方服务:
资源简介:
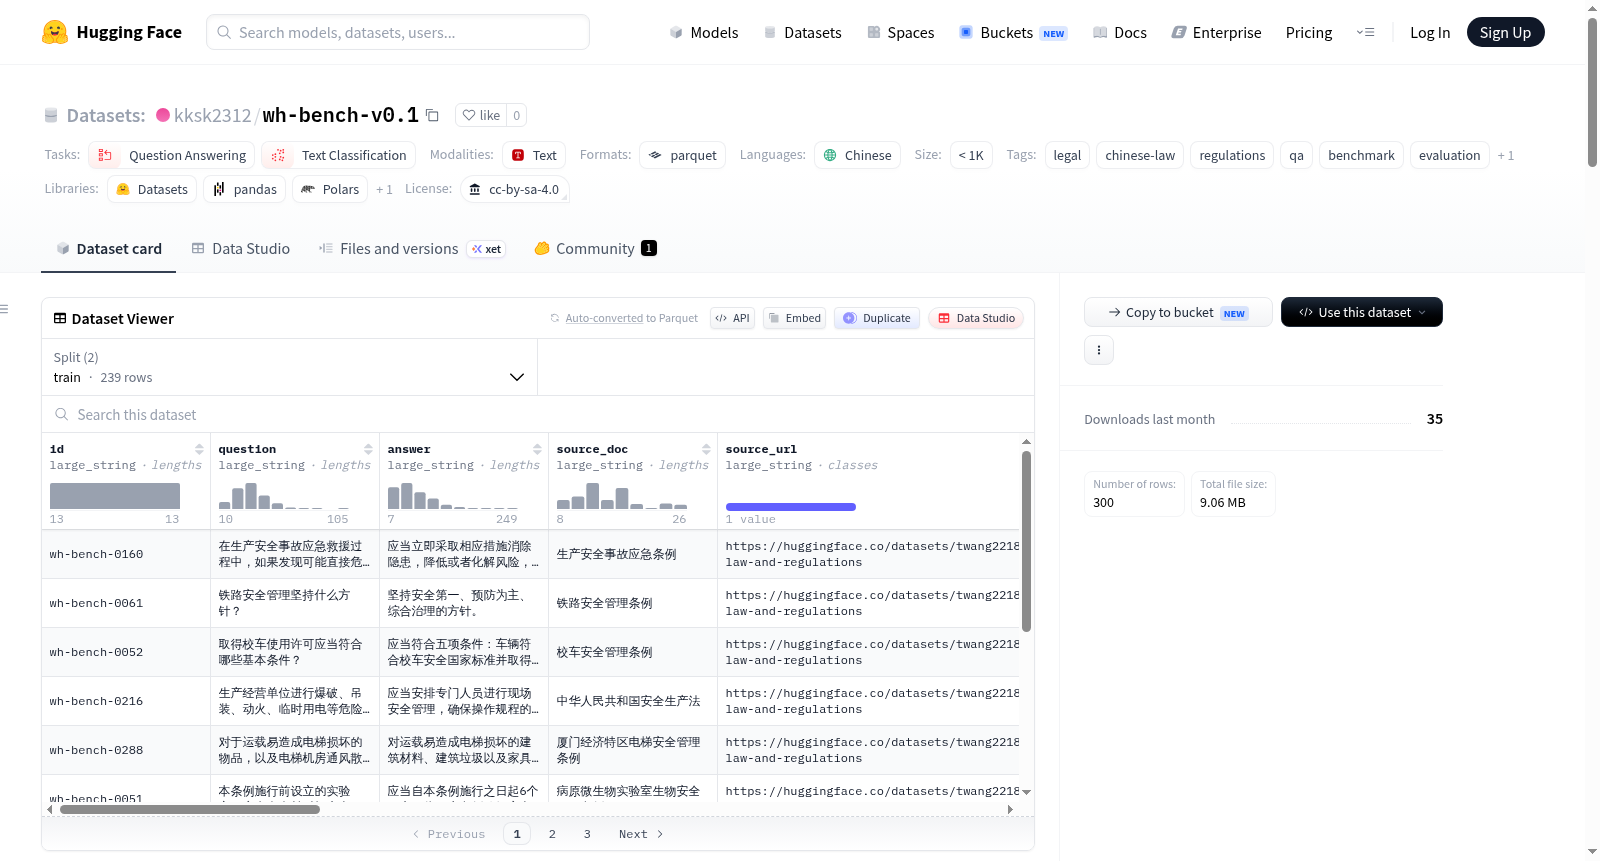
wh-bench v0.1 — 中文法律法规问答评测集
A small, high-quality, dual-LLM-jury verified Chinese legal-regulation QA benchmark for evaluating instruction-tuned LLMs on Chinese law knowledge.
提供机构:
kksk2312搜集汇总
数据集介绍
构建方式
该数据集基于公开的中国法律法规文本,采用三阶段流水线式构建路径。首先,利用GPT-5.4-mini模型对切分后的法规语料进行问答对蒸馏生成,并通过提示词强制模型输出原文引用。随后,实施基于规则的严格过滤机制,对字段完整性、引用准确性与文本长度进行校验,得到303个初始问答对。最后,引入双重LLM评委独立评审体系,由GPT-5.5与Claude Sonnet分别从 groundedness(根基性)、accuracy(准确性)、clarity(清晰性)与specificity(具体性)四个维度进行评分,并做出 pass/borderline/fail 的定性判决。仅当两位评委均给出fail时,该样本才被剔除,最终保留300个高质量问答对,形成训练集(239条)与测试集(61条)的划分。
特点
wh-bench v0.1的核心特征在于其独特的双重评审质量保障机制与严谨的溯源设计。每条问答不仅附带了原始法规文本的完整段落与原文逐字引用,还提供了两位独立LLM评委在四个维度的详细评分与开放式推理理由,这使得数据集的透明度和可验证性显著提升。数据集覆盖50部国家级与地方性法规,包含easy、medium、hard三种难度等级,尽管难度分布偏向简单(55.7%),但所有样本均通过严格陪审机制筛选,确保了事实性答案的高置信度。此外,数据集记录了评委之间的15个争议样本并加以保留,为研究模型评审中的分歧提供了珍贵素材。
使用方法
该数据集可通过HuggingFace Datasets库便捷加载,命令为 load_dataset("kksk2312/wh-bench-v0.1"),返回包含train与test两个分区的DatasetDict对象。每条数据提供question、answer、source_quote等关键字段,用户可直接用于评测指令微调模型的中文法律法规问答能力。出于严格评测考量,建议过滤掉 jury.contested 为 True 的争议样本(共15条),只保留双评委一致通过的样本以获取更纯净的评估结果。该数据集尤其适合用于测试模型的法律事实检索与精确引用能力,而非复杂的法律推理。研究者亦可参考随附的技术报告与数据表,了解完整的构建细节与局限性。
背景与挑战
背景概述
在法律人工智能领域,高质量的中文法律法规问答评测集对于评估指令微调大语言模型的法律知识掌握程度至关重要。wh-bench v0.1由研究者teee32于2026年5月创建,基于武汉市“AI+一人公司”政策倡议下的开源数据管道实验,依托50部国家级与地方性法规文本构建。该数据集聚焦于中文法律法规的事实性问答任务,通过双大语言模型陪审团验证机制,旨在为法律领域的大模型评估提供高可靠性的基准。其创新性的双模型独立评审方法为数据集质量控制树立了新范式,对推动法律AI评估的标准化具有重要参考价值。
当前挑战
wh-bench v0.1面临的挑战首先体现在领域问题的复杂性上:中文法律法规体系庞大且层级多样,涵盖从国家级法规到地方性条例的广泛内容,数据集的构建需要确保问答对既具备事实准确性又能忠实溯源至原始法律条文,这对自动生成与提取技术提出了极高要求。在构建过程中,项目面临三重困难:一是自蒸馏标签的非专家性质,即由大语言模型生成的问答对虽经引用锁定和双模型陪审团过滤,但仍难以完全替代专业法律人士的编写质量;二是裁判不一致问题,15对样本(约5%)存在GPT-5.5与Claude Sonnet的判分分歧,对数据集的严格使用构成挑战;三是难度分布严重偏向简单类(55.7%),限制了其在复杂法律推理评估中的应用,亟需在后续版本中扩充高难度样本并平衡权威来源的覆盖范围。
常用场景
经典使用场景
在法律人工智能的迅猛发展浪潮中,基于指令微调的大型语言模型在中文法律领域的知识掌握程度亟需严谨的评估工具。wh-bench-v0.1数据集正是为此而生,它作为一个经过双大型语言模型陪审团独立评审的高质量中文法律法规问答评测集,包含300条源自50部国家级与地方性法规的问答对。该数据集最经典的用法是作为评测基准,用于系统性地评估各类指令微调模型对中国法律知识的掌握深度与准确性,通过其内置的easy、medium、hard三级难度划分和严格的原文引用机制,为模型在法律事实检索、法规解读等维度的表现提供可信的量化指标。
解决学术问题
在法律人工智能的学术研究版图中,如何客观衡量大模型对中文法律知识的真实理解力始终是一个难以跨越的障碍。wh-bench-v0.1数据集的出现精准地解决了这一关键问题——它填补了中文法律领域缺乏高质量、可追溯、经独立评审的问答评测资源的空白。该数据集通过独创的双LLM陪审团评审机制(GPT-5.5与Claude Sonnet独立评分),在groundedness、accuracy、clarity、specificity四个维度上实现了严格的质控,使研究者得以摆脱依赖人工标注成本过高、自动评估可信度低的困境。其意义在于为法律大模型的评测提供了标准化范式和可复现的实验平台,推动了该领域从定性讨论向定量评估的科学转型。
衍生相关工作
wh-bench-v0.1数据集的构建范式已经催生了多项富有启发性的衍生工作。其首创的双LLM陪审团独立评审和交叉验证方法,为其他垂直领域的高质量数据集构建提供了可借鉴的方法论模板。该数据集所采用的从公开法规文本经LLM蒸馏、规则过滤再到双评委独立评审的三阶段构建管道,启示研究者探索将类似质控机制应用于医疗、金融等专业领域。此外,数据集报告中明确标识的15个陪审团争议样本和严格的评审标准,为后续研究如何优化模型对齐技术、提升评判一致性和减少评判偏差等问题提供了宝贵的实验素材和分析基础。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


