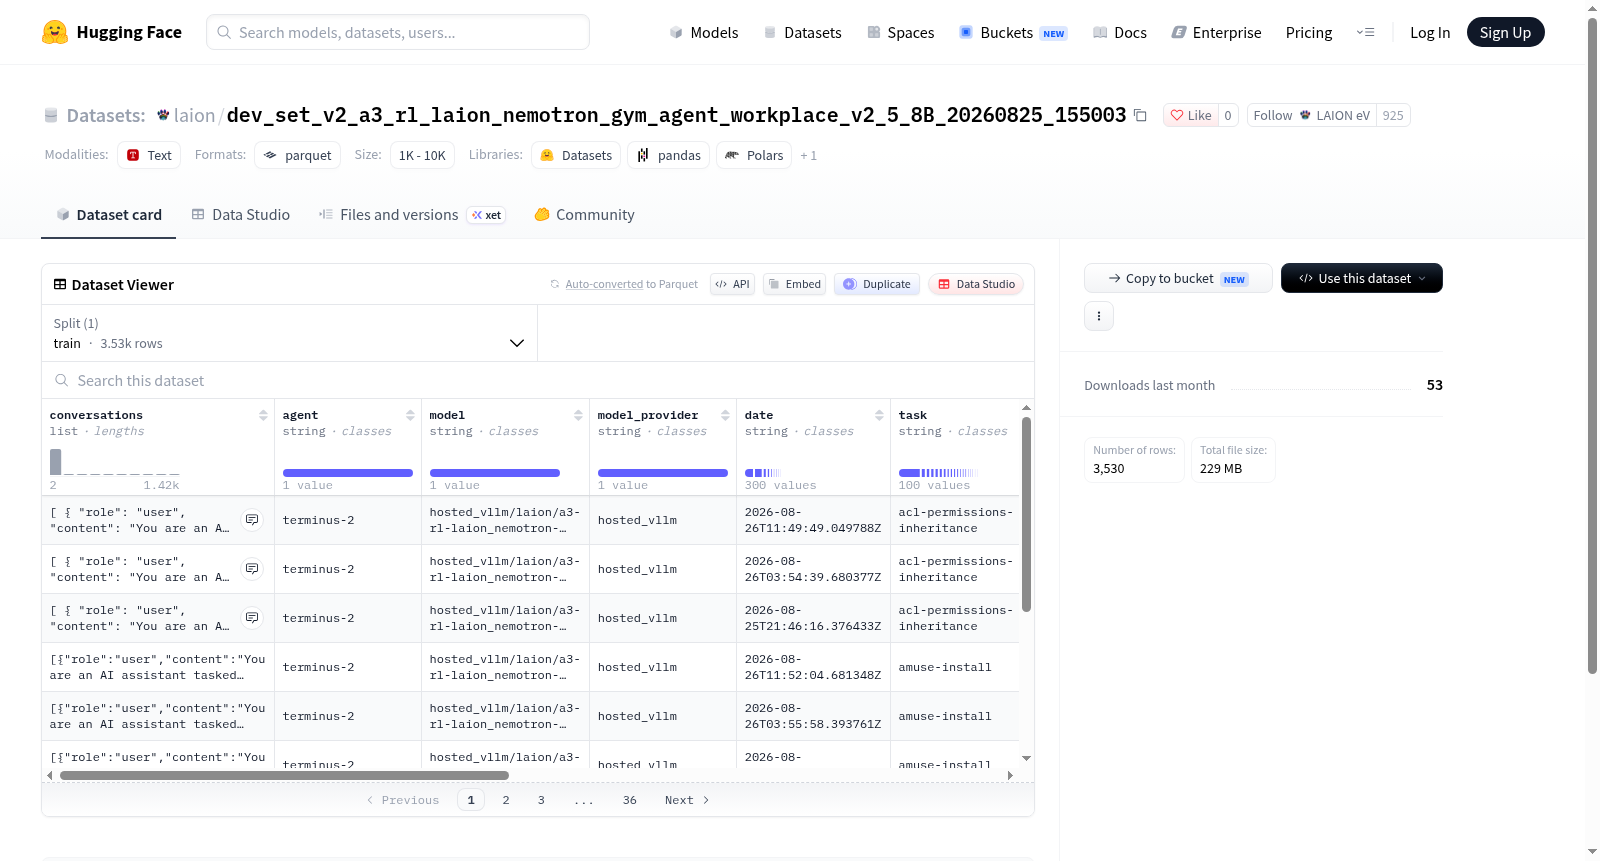
dev_set_v2_a3_rl_laion_nemotron_gym_agent_workplace_v2_5_8B_20260825_155003
收藏资源简介:
该数据集包含3530个多轮对话样本,每个样本由conversations字段记录对话历史(包括角色和内容),并附加元数据:agent(代理)、model(模型)、model_provider(模型提供方)、date(日期)、task(任务)、episode(回合)、run_id(运行ID)、trial_name(试验名称)、result(结果)、verifier_output(验证器输出)和trace_source(追踪来源)。数据集仅包含训练集,大小约262MB。适用于对话系统评估、模型行为追踪、多轮对话生成或验证任务。
This dataset contains 3530 multi-turn dialogue samples. Each sample records the conversation history in the conversations field (including roles and content), along with metadata: agent, model, model_provider, date, task, episode, run_id, trial_name, result, verifier_output, and trace_source. The dataset only includes a training set, approximately 262MB in size. It is suitable for dialogue system evaluation, model behavior tracking, multi-turn dialogue generation, or verification tasks.
数据集概述
该数据集名为 laion/dev_set_v2_a3_rl_laion_nemotron_gym_agent_workplace_v2_5_8B_20260825_155003,由 LAION 组织发布,是一个用于训练和评估智能体(Agent)在模拟工作场所环境中执行任务的数据集。数据集由 NVIDIA Nemotron 8B 模型通过强化学习(RL)生成,并使用 Gym 环境进行模拟。
数据规模
- 数据集总大小:262,263,383 字节(约 250 MB)
- 下载大小:229,130,626 字节(约 218.5 MB)
- 训练集样本数:3,530 条
- 数据划分:仅包含
train训练集,无独立验证或测试集
数据特征
每条数据包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表(多轮对话) | 由 role(角色)和 content(内容)组成的对话记录 |
agent |
字符串 | 执行任务的智能体名称 |
model |
字符串 | 生成数据的模型名称 |
model_provider |
字符串 | 模型提供方 |
date |
字符串 | 数据生成日期 |
task |
字符串 | 任务描述或任务标识 |
episode |
字符串 | 强化学习中的回合(episode)标识 |
run_id |
字符串 | 运行 ID |
trial_name |
字符串 | 试验名称 |
result |
字符串 | 任务执行结果 |
verifier_output |
字符串 | 验证器(verifier)的输出 |
trace_source |
字符串 | 数据来源或轨迹来源 |
数据格式
- 配置名称:
default - 数据文件路径:
data/train-*(支持通配符匹配多个分片文件) - 数据格式:每条数据是一个 JSON 对象,包含上述所有字段
用途
该数据集适用于:
- 训练智能体在模拟工作场所环境中执行复杂任务的能力
- 评估基于强化学习的智能体决策和对话能力
- 研究多轮对话与任务执行的结合场景