
遇见数据集

slprl/common-sense-facts-audio

收藏
Hugging Face2026-06-18 更新2026-06-21 收录
官方服务:

资源简介:

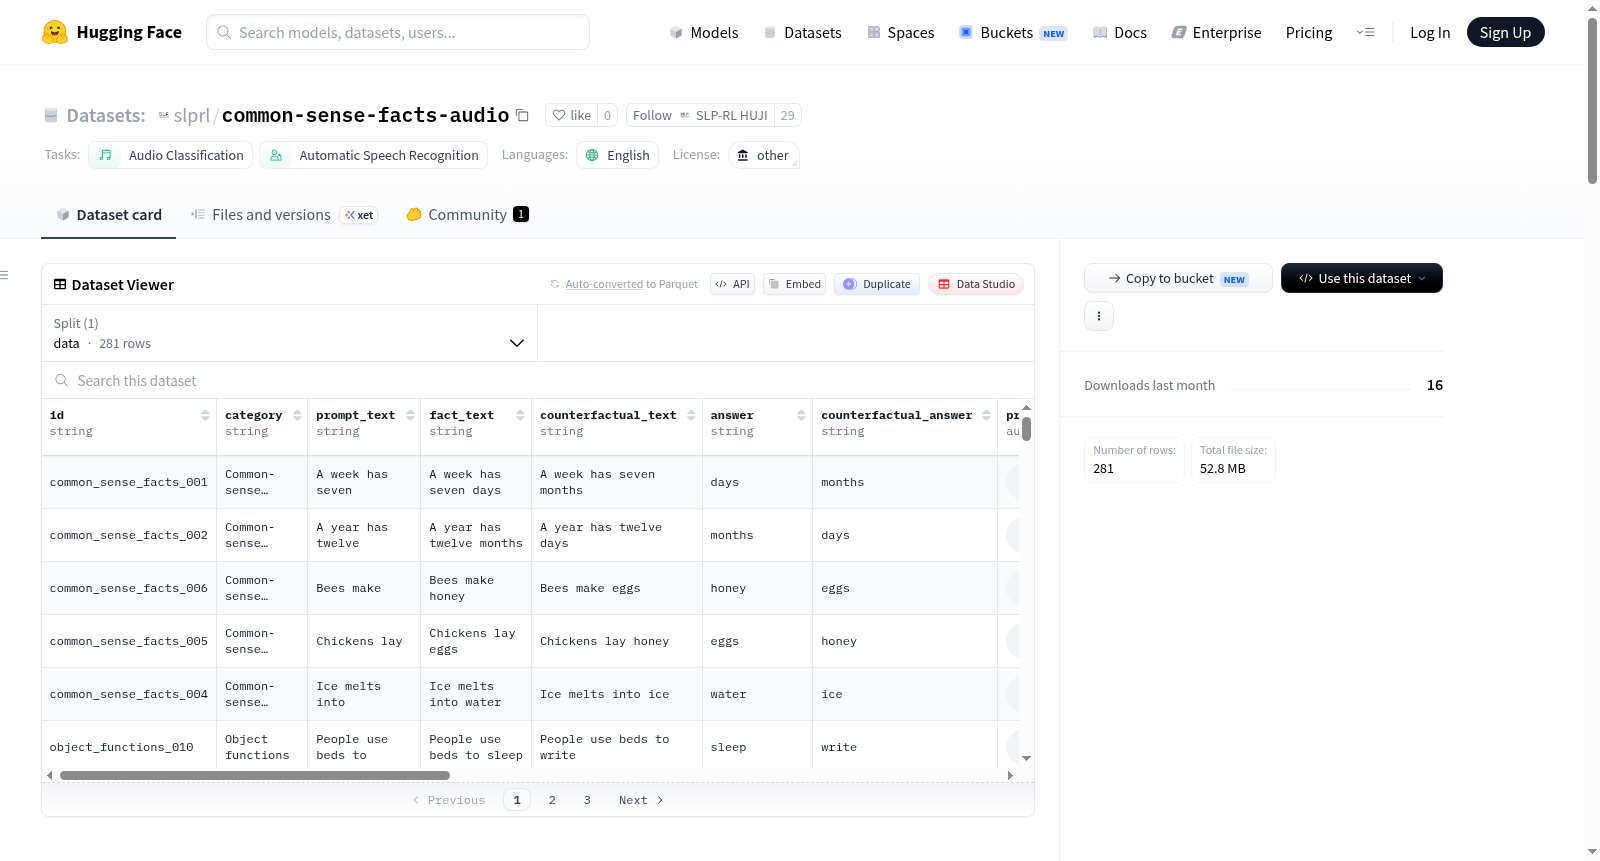
该数据集包含三种配对版本的语音常识事实提示:1. prompt:不完整的事实提示,例如“法国的首都是”;2. fact:正确的完整句子,例如“法国的首都是巴黎”;3. counterfactual:错误的完整句子,例如“法国的首都是罗马”。数据集未定义训练/验证/测试分割,所有示例都包含在名为“data”的单一中性分割中。每个示例对应一个基本事实,包含三个音频文件(prompt_audio、fact_audio、counterfactual_audio)以及提示音频的单词级时间戳(prompt_words、prompt_word_starts、prompt_word_ends)。数据集共有281个示例,涵盖多个类别,如颜色、星期、月份、对象功能、常识事实、国家语言、家庭关系、数值事实、反义词、婴儿动物与职业、首都城市、简单算术和数字序列。音频文件为WAV格式,采样率可能不同,时间戳通过强制对齐获得。数据集旨在用于语音-语言模型对齐、口语语言模型中的事实回忆和探测研究。

This dataset contains spoken common-sense factual prompts in three paired versions: 1. prompt: incomplete factual prompt, e.g., the capital of france is; 2. fact: correct full sentence, e.g., the capital of france is paris; 3. counterfactual: incorrect full sentence, e.g., the capital of france is rome. The dataset does not define train/validation/test splits; all examples are provided in a single neutral split named data. Each row corresponds to one base fact and contains three audio files (prompt_audio, fact_audio, counterfactual_audio) and word-level timestamps for the prompt audio (prompt_words, prompt_word_starts, prompt_word_ends). There are 281 examples covering categories such as Colors, Days of the week, Months of the year, Object functions, Common-sense facts, Country languages, Family relations, Numerical facts, Opposites, Baby animals & professions, Capital cities, Simple arithmetic, and Number sequences. Audio files are in WAV format with varying sampling rates, and timestamps are obtained via forced alignment. The dataset is intended for research on speech-language model alignment, factual recall in spoken language models, and probing studies.
提供机构:
slprl
搜集汇总
数据集介绍
slprl/common-sense-facts-audio 数据集图片
构建方式
该数据集精心构建了一个包含281个样本的语音常识事实语料库,每个样本围绕一个基础事实衍生出三种音频形式:不完整的提示语音、完整的正确事实语音以及对应的错误反事实语音。所有样本被统一归入名为'data'的单一数据划分中,未预先定义训练、验证或测试集分割。数据集涵盖了颜色、星期、月份、物体功能、常识事实、国家语言、家庭关系、数值事实、反义词、动物幼崽与职业、首都城市、简单算术及数字序列等多元语义类别。音频文件均以WAV格式存储,且提示语音附带了通过强制对齐获得的词级时间戳信息。
特点
该数据集最显著的特点在于其三元组结构设计,每个样本同时提供正确事实与错误反事实的语音对照,为探究语音语言模型的事实记忆与对齐能力提供了理想的研究材料。数据集包含13个语义类别,覆盖了从日常生活到基础知识的广泛常识领域。值得注意的是,不同音频源的采样率可能各异且未经重采样处理,保持了原始录音的自然特性。提示语音的词级时间戳进一步增强了数据集的实用价值,支持细粒度的语音-文本对齐分析。
使用方法
该数据集可直接通过HuggingFace Datasets库加载使用,用户仅需指定配置名为'default'并加载'data'划分即可获取全部样本。每个样本包含id、类别、文本及音频等多字段信息,研究人员可依据任务需求选择性地使用prompt_audio、fact_audio与counterfactual_audio字段进行语音语言模型的事实召回评估、语音-文本对齐研究或探针实验。词级时间戳字段prompt_words、prompt_word_starts与prompt_word_ends可用于需要时间对齐信息的细粒度分析任务。引用时请使用提供的BibTeX格式条目。
背景与挑战
背景概述
Common Sense Facts Audio数据集由slprl团队于2026年创建,专注于探索语音与常识知识之间的深层关联。该数据集以语音形式呈现了281条常识性事实提示,涵盖颜色、星期、月份、首都城市、简单算术等13个语义类别,旨在推动语音-语言模型对齐、口语模型中的事实召回以及相关探测研究。其核心研究问题在于,如何通过语音信号承载和验证常识知识,从而增强模型对事实性信息的理解与生成能力。作为首个将常识事实以多版本语音对(正确事实与反事实)形式公开的数据集,它为评估和提升语音语言模型在知识驱动任务中的表现提供了独特资源,对语音人工智能领域具有重要的奠基意义。
当前挑战
该数据集所解决的领域问题包括:语音语言模型在常识推理和事实召回方面存在显著短板,现有语音数据集多聚焦于语音识别或情感分析,缺乏对知识型内容的系统覆盖,导致模型难以在真实对话中准确调用常识。构建过程中面临的主要挑战有:一,如何设计既符合自然语音特征又具备知识完备性的提示文本,确保281个样本能有效代表多种常识类别;二,音频录制与对齐的复杂性——不同来源的音频采样率不一致,且需通过强制对齐获取词级时间戳,而反事实句的生成需在语义上合理且语音上自然,避免引入混淆因素;三,在有限样本量下保持类别平衡,同时为模型探测提供清晰的正确与错误对比信号,这对数据质量控制提出了严苛要求。
常用场景
经典使用场景
Common Sense Facts Audio数据集专为研究语音-语言模型的对齐与事实性回忆而构建。其经典使用场景包括评估和提升语音语言模型对常识知识的掌握能力——通过提供不完整常识提示的语音片段(如“the capital of france is”),并配以正确与错误两种完整陈述的音频(如“paris”和“rome”),研究者可系统性地评测模型在听觉模态下区分事实与反事实信息的能力。该设计支持对语音模型深层语义理解与知识检索机制的精细剖析,尤其聚焦于模型能否在缺乏视觉文本线索的条件下,从语音流中提取并验证世界知识。
实际应用
在实际应用中,Common Sense Facts Audio数据集为智能语音助手、教育辅导机器人、无障碍阅读系统等场景提供了不可或缺的测试与训练素材。例如,在开发面向儿童的语音问答设备时,该数据集能帮助系统学习正确回答常识性问题,避免传播错误信息。在车载语音辅助或家用智能音箱中,利用该数据训练模型可提升其对用户提问(如“一周中星期天之后是哪一天?”)的准确响应能力。此外,其反事实音频还可用于语音内容审核场景,帮助检测和纠正语音生成过程中可能出现的事实性偏差,从而确保消费级语音产品输出的可靠性与教育价值。
衍生相关工作
此数据集已催生多项衍生研究。在一些关于语音常识推理的探索中,研究者利用其事实与反事实的对比结构,提出了一种基于对比学习的语音表征优化方法,显著提高了模型区分真假陈述的准确率。另有工作将其与文本语义空间对齐,开发了跨模态知识蒸馏框架,使得语音模型能够从文本常识库中受益。此外,还有研究工作聚焦于该数据集提供的词级时间戳信息,实现了对语音提示中关键信息点的精准定位与注意力加权,从而在语速变化和口音干扰下仍能保持高鲁棒性的事实检索。这些衍生成果共同拓展了语音语言理解领域的技术边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

