omr-voices
收藏资源简介:
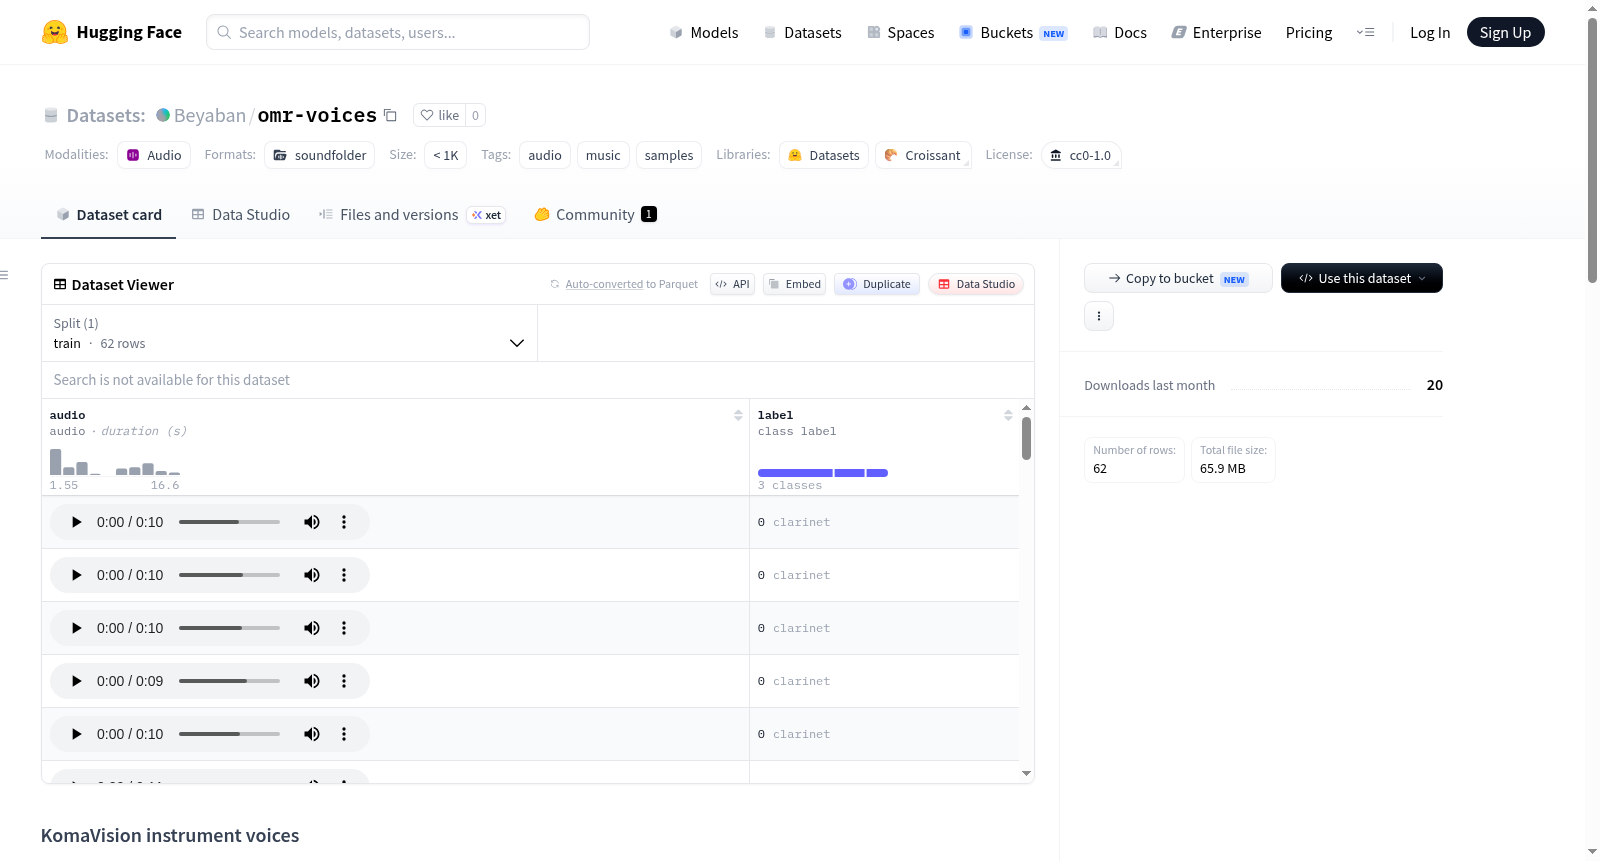
KomaVision instrument voices 数据集是 KomaVision 应用程序用于演奏乐谱的采样乐器声音,取自 VSCO 2 Community Edition 的原始未修改文件。所有文件保持完整长度、立体声、原始位深和采样率,未经任何修剪、压缩、降混或重采样。数据集包含两种乐器:单簧管和小提琴。单簧管部分来自 Woodwinds/Clarinet/susLong 的中等力度层,共 11 个文件,总大小 20.2 MB;小提琴部分来自 Strings/Solo Violin/Arco Vib 的强力度层,共 15 个文件,总大小 35.4 MB。所有文件均提供 SHA-256 校验和以验证完整性。注意:单簧管的音高标签比实际音高低一个八度(例如标为 D2 实际为 D3),且文件 DCClar_susLong_F#5_v2_rr1_sum.wav 实际音高为 F6 而非 F#6,相差一个半音。数据集采用 CC0 1.0 许可,但建议致谢 Versilian Studios LLC / Sam Gossner。该数据集适用于音乐采样、声音合成、乐器库构建等任务。
The KomaVision instrument voices dataset is a collection of sampled instrument sounds used by the KomaVision application for playing musical scores, taken from the original unmodified files of VSCO 2 Community Edition. All files retain full length, stereo, original bit depth and sample rate, without any trimming, compression, downmixing, or resampling. The dataset contains two instruments: clarinet and violin. The clarinet part comes from the medium velocity layer of Woodwinds/Clarinet/susLong, with 11 files totaling 20.2 MB; the violin part comes from the strong velocity layer of Strings/Solo Violin/Arco Vib, with 15 files totaling 35.4 MB. All files are provided with SHA-256 checksums to verify integrity. Note: The pitch labels of the clarinet are one octave lower than the actual pitch (e.g., labeled D2 but actually D3), and the file DCClar_susLong_F#5_v2_rr1_sum.wav is actually F6 instead of F#6, a semitone difference. The dataset is licensed under CC0 1.0, but acknowledgment of Versilian Studios LLC / Sam Gossner is suggested. This dataset is suitable for tasks such as music sampling, sound synthesis, and instrument library construction.
KomaVision instrument voices 数据集详情
基本信息
- 数据集名称:KomaVision instrument voices
- 许可协议:CC0 1.0(源自 VSCO-2-CE 仓库中的 CC0 1.0 法律文本)
- 标签:audio、music、samples
- 来源:KomaVision 应用运行时所使用的采样乐器文件,仅在用户选择特定乐器时由应用获取
数据内容
该数据集包含 26 个音频文件,均为 VSCO 2 Community Edition 原始文件,未经过任何修剪、压缩、混音降采样或重新调整电平,保留了完整长度、立体声、原始位深度和原始文件名。
| 文件夹 | 来源 | 文件数 | 大小 |
|---|---|---|---|
clarinet/ |
Woodwinds/Clarinet/susLong,v2(中)力度层 |
11 | 20.2 MB |
violin/ |
Strings/Solo Violin/Arco Vib,f 层 |
15 | 35.4 MB |
重要注意事项
1. 音高标签与真实音高存在偏差
- 单簧管:文件名中的音高标签比实际发声音高低一个八度(如
DCClar_susLong_D2_…实际发声为 D3,146.7 Hz),所有 11 个文件一致如此。 - 小提琴:文件名音高标签为标准科学音高,无需偏移。
- 切勿直接依据文件名读取音高。
2. 特定文件标注异常
- 文件
DCClar_susLong_F#5_v2_rr1_sum.wav实际发声为 F6(1397 Hz),而非文件名标注的 F#6,其在源头被错标了半音。但该文件本身音准正常,完全可用,且保留了原始文件名以维护来源可追溯性。 - 应用内部使用测量频率而非解析文件名。
校验和
数据集中每个文件均提供了 SHA-256 校验和,用于验证文件与源版本的一致性。这些校验和由应用仓库中的 scripts/prepare_voices.py 脚本计算并核对。
许可与致谢
- 尽管 CC0 不要求署名,但数据集仍对 Versilian Studios LLC / Sam Gossner 予以致谢(VSCO 2 CE 的 readme 有此要求)。
- 当 VSCO 2 CE 的“条款”与 CC0 文件发生冲突时,以 CC0 为准——CC0 一旦适用即不可撤销。
- 仅收录 Versilian 自己的单簧管和独奏小提琴录音,未包含 v1.1“legacy”/Ivy Audio 材料(其来源较为混杂)。