
遇见数据集

DeepSWE-Gym2

收藏
Hugging Face2026-09-06 更新2026-09-07 收录
官方服务:

资源简介:

该数据集是多个高质量软件工程(SWE)数据集的合并版本,经过过滤和去重处理,旨在提升DeepSWE风格问题、基准测试以及通用编码技能的表现。数据集专门筛选了原始数据集中包含复杂/长代码问题的样本,平均样本大小为214.19KB,总未压缩大小为17.56GB,共计85974个样例。数据集由MoreThought策划并共享,采用MIT许可证。数据来源包括DeepSWE-Gym、SWE-Gym、SWE-rebench-V2-Filtered-Verified、SWE-bench-extra、SWE-Next、Multi-SWE-RL-Verified和SWE-Synth等HuggingFace数据集,以及多篇相关论文。该数据集适用于改进基准测试结果、提升通用编程能力、训练软件工程/编码代理以及改进长上下文编码任务。注意:为避免样例重叠,请勿将该数据集与其他变体或版本一起使用。

This dataset is a merged version of multiple high-quality software engineering (SWE) datasets, filtered and deduplicated to enhance DeepSWE-style problems, benchmarks, and general coding skills. The dataset specifically selects samples containing complex/long code problems from the original datasets, with an average sample size of 214.19KB, a total uncompressed size of 17.56GB, and a total of 85,974 samples. The dataset is curated and shared by MoreThought under the MIT license. Data sources include HuggingFace datasets such as DeepSWE-Gym, SWE-Gym, SWE-rebench-V2-Filtered-Verified, SWE-bench-extra, SWE-Next, Multi-SWE-RL-Verified, and SWE-Synth, as well as multiple related papers. This dataset is suitable for improving benchmark results, enhancing general programming abilities, training software engineering/coding agents, and improving long-context coding tasks. Note: To avoid sample overlap, do not use this dataset with other variants or versions.

创建时间:
2026-09-06
原始信息汇总

数据集概述

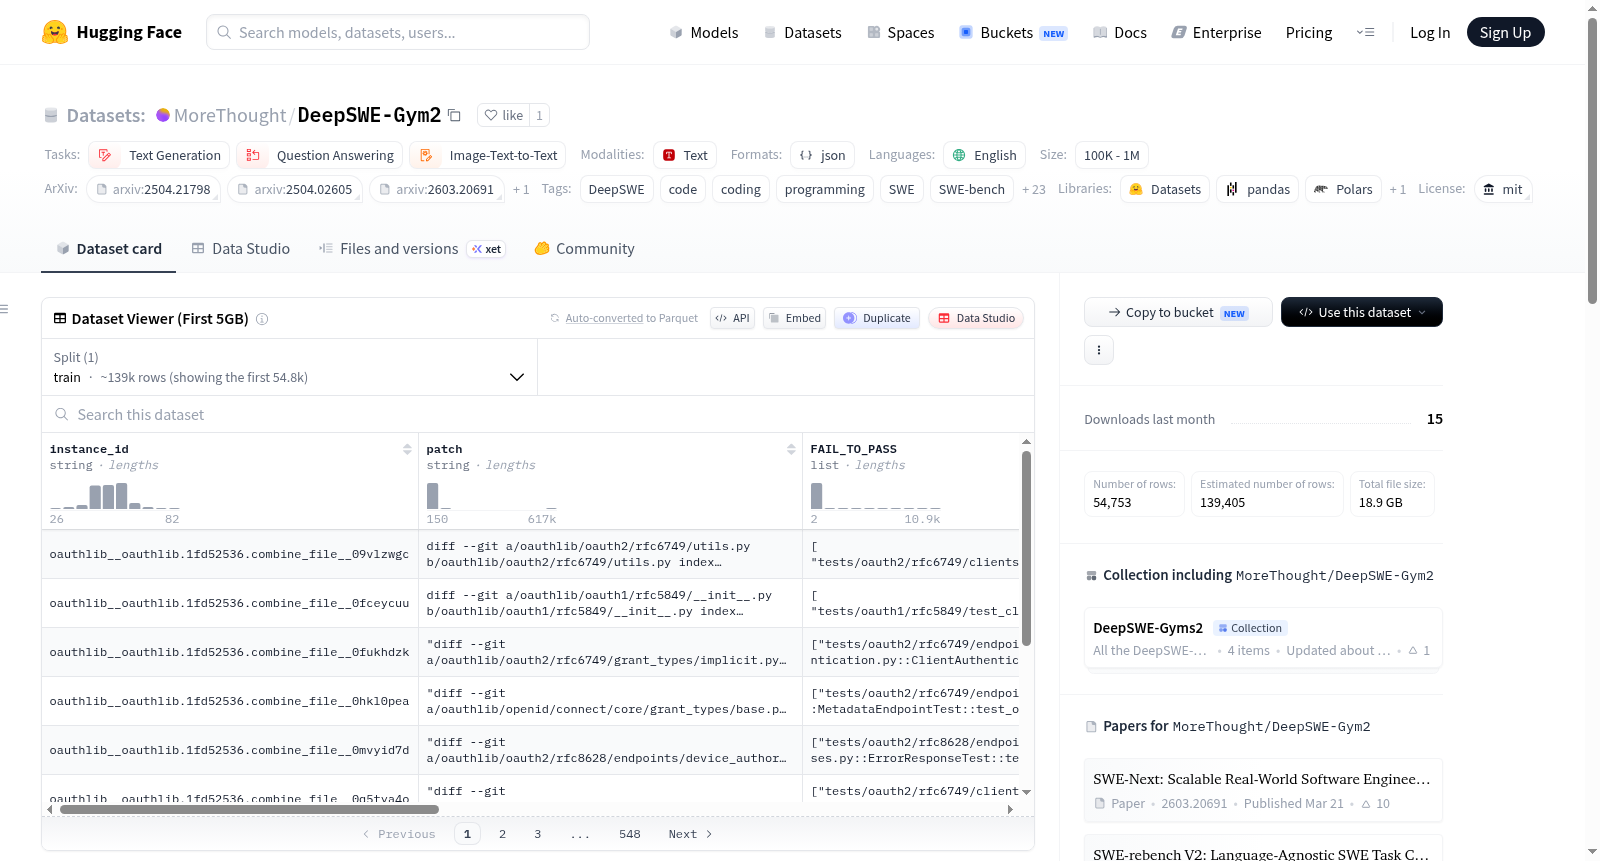
DeepSWE-Gym2 是一个经过筛选和去重处理的高质量软件工程(SWE)数据集合并版本,旨在提升 DeepSWE 风格问题、基准测试及通用编码能力上的表现。

基本信息

  • 名称: DeepSWE-Gym2
  • 维护方: MoreThought
  • 许可证: MIT
  • 规模: 85,974 条样本(10K < n < 100K)
  • 数据大小: 未压缩总大小约 17.56 GB,平均每条样本约 214.19 KB(部分样本可达 28 MB)
  • 任务类型: 文本生成、问答、图像-文本到文本
  • 语言: 英语
  • 编程语言覆盖: Python、JavaScript、TypeScript、Java、C++、Rust、Go

数据来源

该数据集由以下多个 SWE 相关数据集合并、过滤和去重而成:

  • MoreThought/DeepSWE-Gym
  • SWE-Gym/SWE-Gym
  • PrimeIntellect/SWE-rebench-V2-Filtered-Verified
  • nebius/SWE-bench-extra
  • TIGER-Lab/SWE-Next
  • PrimeIntellect/Multi-SWE-RL-Verified
  • swesynth/SWE-Synth

另参考了若干相关研究论文(详见数据集原始页面)。

用途

  • 提升基准测试结果
  • 增强通用编码能力
  • 训练软件工程/编码代理(Agent)
  • 改善长上下文编码能力

重要提示

  • 避免数据重叠: 不应将此数据集与其他变体或版本混合使用,以免产生重叠样本。
  • 训练资源要求高: 大多数大语言模型无法直接处理接近 28 MB 的超长样本,需使用专门脚本来进行有效训练。
搜集汇总
数据集介绍
DeepSWE-Gym2 数据集图片
构建方式
DeepSWE-Gym2数据集由MoreThought团队精心策展,整合了多个高质量软件工程(SWE)数据集的精华,并经过严格的过滤与去重处理。该数据集融合了来自DeepSWE-Gym、SWE-Gym、SWE-rebench-V2、SWE-bench-extra、SWE-Next、Multi-SWE-RL-Verified及SWE-Synth等多个来源的复杂代码问题,旨在提升模型在DeepSWE风格任务及通用编程能力上的表现。构建过程中,特别筛选了平均样本规模达214.19KB、总解压体积为17.56GB的85974个高复杂度样例,确保了数据的多样性与挑战性。
使用方法
该数据集主要应用于提升模型在基准测试中的成绩,增强通用代码生成与推理能力,并专用于训练软件工程智能体。由于数据集中存在超大样本(最大可达28MB),直接使用常规训练框架可能导致内存溢出,建议采用专门的分层训练脚本或梯度累积策略,以有效处理长上下文序列。使用时务必注意,若同时使用其他SWE数据集或其变体,可能导致样本重叠,影响评估结果的准确性,因此应仅依赖DeepSWE-Gym2进行训练与评估。
背景与挑战
背景概述
DeepSWE-Gym2数据集由MoreThought机构于近期创建并共享,旨在应对软件工程智能体(SWE agents)在复杂代码推理与长上下文理解方面日益严峻的挑战。该数据集整合了包括DeepSWE-Gym、SWE-Gym、SWE-rebench-V2、SWE-bench-extra、SWE-Next、Multi-SWE-RL-Verified及SWE-Synth在内的多个高质量软件工程数据源,经过精心过滤与去重,聚焦于复杂且长的代码问题,平均每个样本达214.19KB,总计包含85,974个示例。其构建缘起于对DeepSWE风格问题及通用编码能力提升的迫切需求,尤其在多文件修改、跨语言(如Python、JavaScript、Java、C++、Rust、Go)及推理密集型任务上。该数据集通过提供大规模、高难度的软件工程训练语料,为训练能够处理真实世界仓库级代码的智能体奠定了坚实基础,对推动自动化代码生成与修复领域的研究具有显著影响力,有望成为评估和提升模型软件工程能力的重要基准资源。
当前挑战
DeepSWE-Gym2数据集面临的挑战涵盖领域问题与构建过程双重维度。在领域层面,核心挑战在于解决软件工程中代码智能体对长序列(部分样本高达28MB)的建模能力不足问题,这类任务需要模型捕获跨文件的语义关联、理解复杂的仓库结构及执行逻辑,远超传统代码生成任务的难度;同时,多语言(含C++、Rust等)与多任务(如推理、问答)的融合进一步增加了泛化难度。在构建过程中,首要挑战是数据来源异构且存在高度重叠,需设计精细的去重及过滤策略以防止训练时数据泄漏,确保数据纯净度;其次,从各原始数据集中筛选出复杂且长的样本不仅需要权衡质量与规模,还需处理不同标注格式及问题表述的差异性;此外,管理总计17.56GB的超大数据体量并保证其质量一致性也颇具挑战,直接采用常规训练脚本容易导致显存溢出,因此需要开发专门的训练脚本以适应超长上下文,这为数据集的可用性设置了技术门槛。
常用场景
经典使用场景
DeepSWE-Gym2数据集在软件工程智能体训练领域占据核心地位。它融合了多个高质量SWE数据源,经过精细过滤与去重,聚焦于复杂长期的代码问题,平均样本规模达214.19KB,总数据量逾8.5万条。该数据集专为提升深度软件工程(DeepSWE)风格任务的基准性能而设计,适用于训练具备长上下文建模能力的编程智能体,尤其擅长处理跨文件、多文件的代码修复与生成任务。作为强化学习与监督微调的基石,它为大型语言模型提供了丰富的仓储级代码挑战,是评估与增强模型代码推理与生成能力的理想测试场。
解决学术问题
该数据集有效应对了软件工程领域中现有代码数据集质量参差不齐、样本重复度高、以及缺乏真实世界复杂性问题。通过整合SWE-bench、SWE-Gym、Multi-SWE-RL等来源,并采用严格的过滤与去重机制,它解决了长期困扰研究者的数据分布偏差与过拟合问题,为训练泛化能力强的代码模型提供了干净、多样化的数据基础。其引入的高复杂度长上下文样本有助于攻克多文件级代码理解的学术难题,推动软件工程自动化研究从单函数编程迈向仓库级系统开发,显著提升了模型在真实软件场景中的代码修复与功能实现能力。
实际应用
实际应用中,DeepSWE-Gym2被广泛用于提升大型语言模型的编码综合能力,尤其在软件工程(SWE)任务的基准测试中表现突出。研究团队与工程开发者借助该数据集监督微调(SFT)各类代码模型,训练出的智能体能更精准地解决GitHub issues、生成补丁和重构代码。例如,在自动化程序修复、CI/CD漏洞修复、代码审查辅助等场景中,基于此数据集训练的模型展现出对长上下文代码库的深刻理解与操作能力。此外,它也作为强化学习环境,帮助智能体在真实软件项目中习得决策策略,从而支撑起下一代软件开发助手的构建。
数据集最近研究
最新研究方向
DeepSWE-Gym2数据集的最新研究方向聚焦于软件工程智能体的复杂代码理解与生成能力提升,尤其关注跨语言、多文件级别的长上下文推理挑战。该数据集融合了SWE-bench、SWE-Gym等前沿基准的精选样本,针对高难度、大规模代码问题进行了过滤与去重,平均样本规模达214KB,旨在推动智能体在真实软件工程场景下的鲁棒性和效能。当前研究热点包括基于强化学习的智能体微调、长上下文建模策略,以及利用合成数据增强泛化性能,其MIT许可和开源性质促进了领域内的协作与创新,为下一代自动化编程系统奠定数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

