Annoy-PyEdu-Rs-Raw
收藏资源简介:
本数据集是PythonEdu-Rs数据集的处理后原始数据,由HuggingFaceTB团队提供。数据以JSONL格式存储,具体文件名为0_368500_filtered_v2_ds25.sced.jsonl。每条数据记录包含多个字段:问题描述(用于概述编程任务)、输入/输出要求与约束(指定代码的输入输出规范)、参考代码(包括可选的导入包、辅助函数和主入口函数)、入口函数名称(标识主函数)、输入/输出对列表(每个元素包含输入参数和返回值,但可能为空,因为执行时输入/输出规模可能超出预设约束)、数据来源(标识数据来源)、分配的推理类型类别(分类推理类型)以及样本元信息(额外元数据)。需要注意的是,由于基于大语言模型的转换过程存在不完美之处,部分问题描述可能包含的信息不足以完整描述对应代码。该数据集适用于Python编程教育、代码生成、代码理解或测试用例生成等相关任务,并采用odc-by许可证。
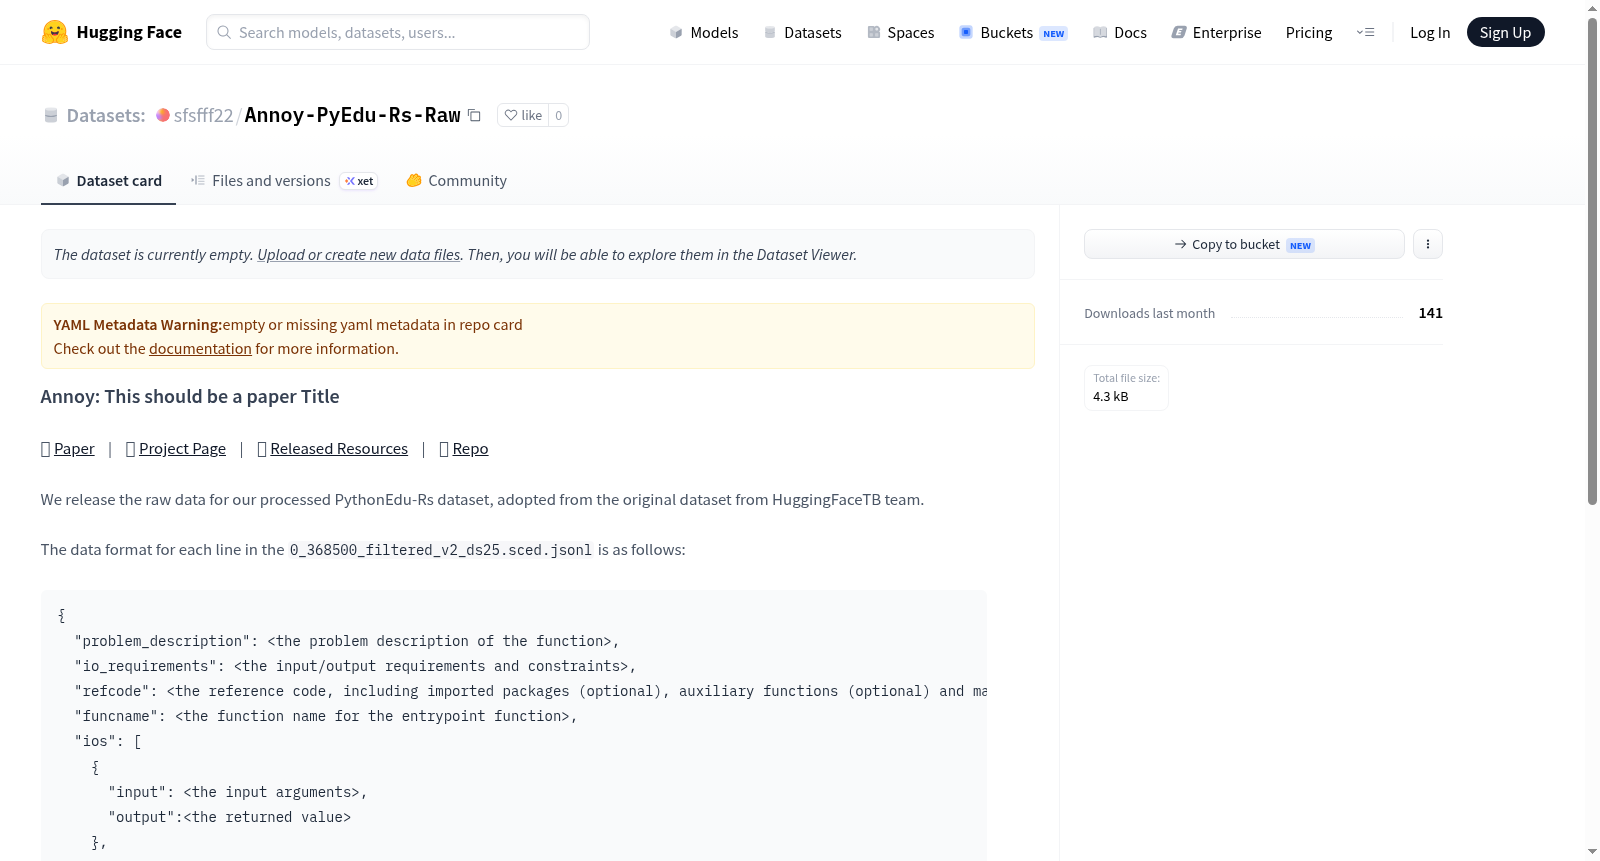
This dataset is the processed raw data of the PythonEdu-Rs dataset, provided by HuggingFaceTB team. The data is stored in JSONL format, with the specific file name 0_368500_filtered_v2_ds25.sced.jsonl. Each data record includes multiple fields: problem description (to outline programming tasks), input/output requirements and constraints (specifying code input and output specifications), reference code (including optional import packages, helper functions, and main entry function), entry function name (identifying the main function), input/output pair list (each element contains input parameters and return values, but may be empty due to input/output scale exceeding preset constraints during execution), data source (identifying the data origin), assigned reasoning type category (classifying reasoning types), and sample meta information (additional metadata). It should be noted that due to imperfections in the large language model-based conversion process, some problem descriptions may contain insufficient information to fully describe the corresponding code. This dataset is suitable for tasks related to Python programming education, code generation, code understanding, or test case generation, and uses the odc-by license.
数据集概述
- 名称:Annoy-PyEdu-Rs-Raw
- 来源:基于 HuggingFaceTB 团队的原始 PythonEdu-Rs 数据集,经过处理后发布。
- 许可协议:odc-by(开放数据共享署名许可)。
数据文件
- 文件名:
0_368500_filtered_v2_ds25.sced.jsonl - 数据格式:每行为一个 JSON 对象,包含以下字段:
| 字段名 | 说明 |
|---|---|
problem_description |
函数的问题描述 |
io_requirements |
输入/输出要求与约束 |
refcode |
参考代码,包含导入包(可选)、辅助函数(可选)和主入口函数 |
funcname |
入口函数的函数名 |
ios |
输入/输出示例数组,每个元素包含 input(输入参数)和 output(返回值) |
source |
原始代码文件的来源 |
category |
该样本的推理类型 |
meta |
样本的元信息 |
注意事项
- 部分
ios字段为空,原因是执行代码时输入/输出规模过大,超出约束条件,因此未存储或后续使用。 - 由于基于 LLM 的变换不够完美,部分
problem_description信息不足以完整描述代码,这将在未来版本中改进。
相关资源
- 论文:https://huggingface.co/papers/xxxx.xxxxx
- 项目页面:https://specx.github.io/
- 已发布资源集合:https://huggingface.co/collections/sfsfff22/specx-67a978e28fd926b56a4f55a2
- 代码仓库:https://github.com/maa-gardovillip/Annoy