
mutisya/tts-speakers-7lang-15k-25-49-v2_v2-tildefix-mer-v1
收藏数据链接:
官方服务:
资源简介:
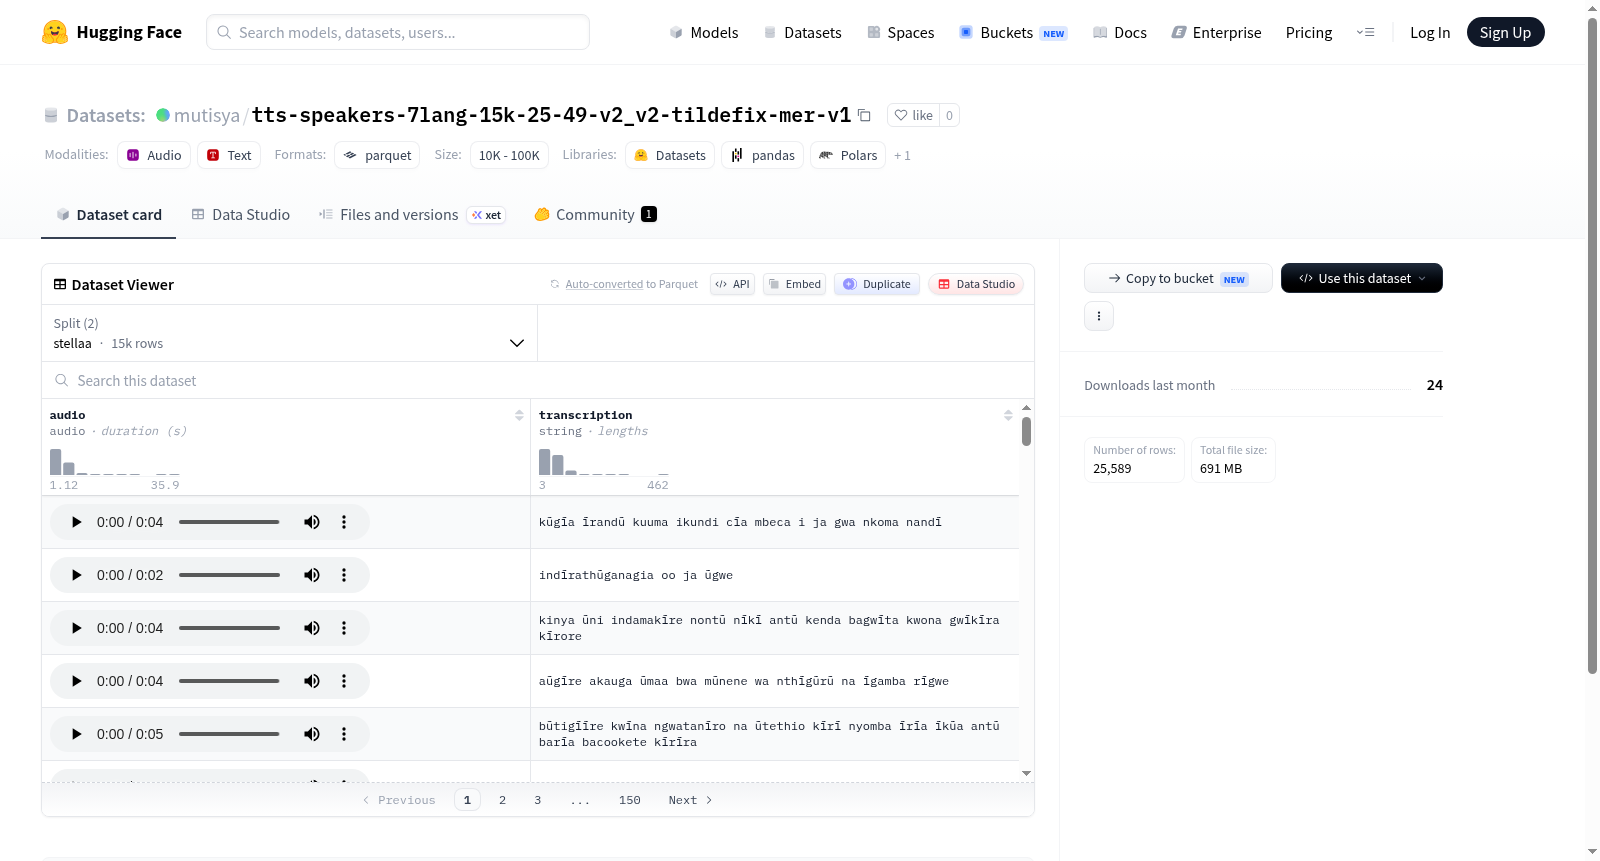
该数据集名为mer_Latn,包含音频和转录文本特征,音频采样率为16000Hz。数据集分为两个部分:stellaa(15,000个示例,约402MB)和erick(10,589个示例,约332MB),总大小约734MB。数据文件路径对应mer_Latn配置下的分割。
The dataset named mer_Latn includes audio and transcription features, with audio sampled at 16000 Hz. It is divided into two splits: stellaa (15,000 examples, approximately 402 MB) and erick (10,589 examples, approximately 332 MB), with a total size of about 734 MB. Data file paths correspond to the splits under the mer_Latn configuration.
提供机构:
mutisya搜集汇总
数据集介绍
构建方式
该数据集聚焦于多语种语音合成任务,通过收集7种语言、涵盖15,000个样本的语音数据构建而成。数据来自两位发言人(stellaa和erick),分别贡献了15,000和10,589条录音,总计超过25,000条语音样本。所有音频均被统一重采样至16kHz采样率,并配以对应的文本转录,形成结构化的语音-文本对。数据集以mer_Latn为配置名,采用分片存储方式组织数据文件,便于分批次加载与处理。
特点
数据集以多语言覆盖性为核心亮点,整合了7种不同语言的语音资源,为多语种语音合成研究提供了丰富的训练素材。每条样本包含16kHz的高质量音频与精准的文本转录,确保了数据的一致性与可用性。数据集拆分自两位发言人的独立子集,保留了语音多样性的同时,也为评估跨说话人泛化能力提供了可能。整体规模适中,兼顾了训练效率与数据多样性。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,指定配置名mer_Latn即可获取语音与转录字段。音频数据以16kHz的采样率读取,可直接用于语音合成模型的输入。数据集已按发言人划分为stellaa和erick两个子集,用户可根据研究需求选择单一子集进行训练,或合并使用以增强模型对声学特征的鲁棒性。适合用于训练基于文本到语音(TTS)的多语言声学模型或说话人自适应系统。
背景与挑战
背景概述
该数据集名为tts-speakers-7lang-15k-25-49-v2_v2-tildefix-mer-v1,聚焦于多语言语音合成领域,旨在为文本到语音(TTS)系统提供高质量、多说话人的语音数据。数据集创建于近期,由研究团队针对7种语言(涵盖拉丁字母书写系统)进行采集与整理,其中mer_Latn配置包含约2.5万条音频样本,由两位说话人(stellaa和erick)录制,音频采样率为16kHz,并配有对应的文本转录。该数据集的核心研究问题在于解决低资源语言和跨语言TTS系统中的数据稀缺问题,通过提供多样化的说话人声音和语言覆盖,推动语音合成模型的泛化能力与自然度提升,对多语言语音交互、无障碍技术及人机语音界面等领域具有重要影响。
当前挑战
该数据集面临的挑战主要来自两大方面。领域问题层面,多语言TTS系统需处理不同语言的音素差异、韵律变化及重音模式,尤其对于低资源语言,缺乏大规模高质量标注数据,导致合成语音的准确性与自然度不足;构建过程中,数据采集需覆盖7种语言并确保每位说话人的录音环境一致性,避免背景噪声与回声干扰,同时文本转录需精确匹配发音,手动标注成本高且易出错。此外,数据集中说话人数量有限(仅2位),可能无法充分代表各语言的口音与方言变体,限制了模型在真实场景下的鲁棒性。
常用场景
经典使用场景
在语音合成与多语言语音处理的研究领域中,该数据集汇聚了来自7种语言、超过15000条高质量语音样本,每条样本均配备精准的文本转录,采样率为16kHz。经典应用场景聚焦于训练多说话人、多语种的文本到语音(TTS)模型,尤其适用于构建能够适应不同语言和说话人特征的声学模型与声码器,为跨语言语音克隆和个性化语音生成提供坚实的数据基础。
实际应用
实际应用层面,该数据集可赋能多语言智能语音助手、跨语言有声读物制作、多语种导航系统及无障碍沟通工具的开发。例如,国际客服系统中需支持不同语言的个性化语音回复,教育平台的多语种朗读功能,均能依托此数据集构建自然且富有表现力的合成语音,显著提升用户交互体验与信息传递效率。
衍生相关工作
衍生的经典工作包括多语言说话人编码器预训练、基于共享声学空间的零样本语音合成方法,以及语言无关的韵律建模研究。此外,该数据集常被用于验证跨语言自适应TTS框架、多任务联合训练策略(如结合音素识别与声学建模),并催生了系列迁移学习与元学习方法,为后续开源多语言TTS工具包(如Coqui TTS)提供了基准训练资源。
以上内容由遇见数据集搜集并总结生成


