VINS-120K
收藏资源简介:
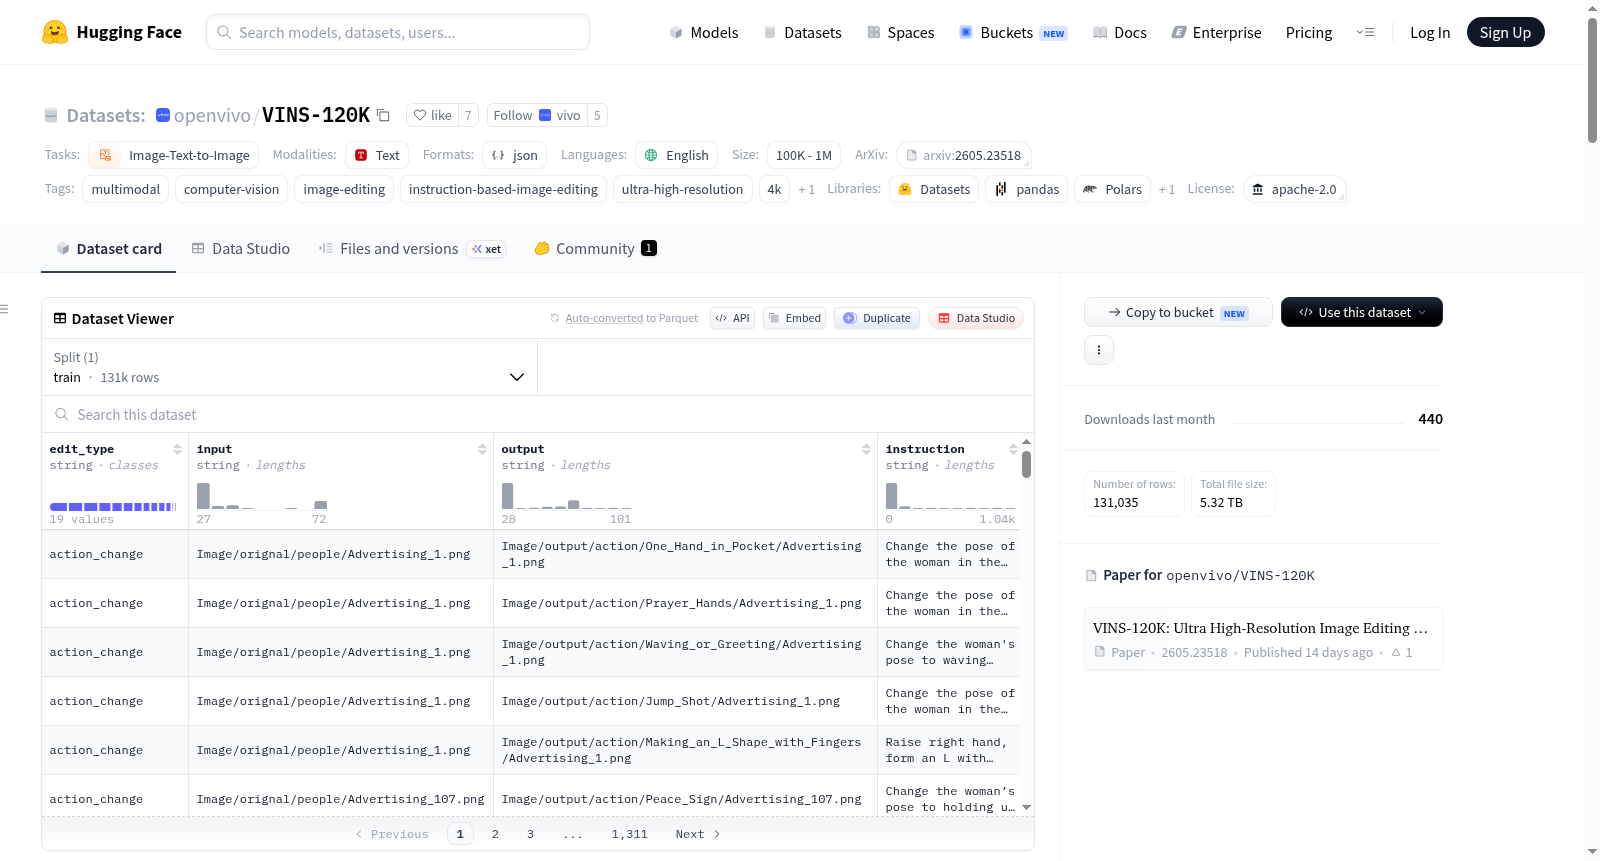
VINS-120K是一个用于指令引导的超高分辨率图像编辑的大规模数据集,包含120K个精心筛选的编辑三元组,每个样本由源图像、编辑后目标图像和英文编辑指令组成。所有图像分辨率不低于4K,覆盖13种编辑类型,包括局部编辑、全局编辑、相机移动和个性化生成。数据来源于真实世界的超高分辨率视频和高质量开源编辑数据,经过多阶段过滤以确保视觉质量、指令对齐和美学保真度。数据集结构上,每个标注条目包含编辑类型、源图像相对路径、编辑后图像相对路径和英文指令。训练数据分为nano-consistent、ultravideo和x2edit三个部分,对应三个JSON标注文件。此外,数据集提供了名为VINS-4KEval的评测基准,包含509个精心挑选的4K/UHR测试样本,用于评估指令引导的超高分辨率图像编辑模型的性能,重点关注指令遵循、结构保持和细节质量。数据集采用Apache License 2.0许可发布。
VINS-120K is a large-scale dataset for instruction-guided ultra-high-resolution image editing, containing 120K carefully curated editing triplets, each consisting of a source image, an edited target image, and an English editing instruction. All images are in ultra-high resolution, with a resolution of at least 4K. The dataset covers 13 editing types, including local editing, global editing, camera movement, and personalized generation. Data is sourced from real-world ultra-high-resolution videos and high-quality open-source editing data, and undergoes multi-stage filtering to ensure visual quality, instruction alignment, and aesthetic fidelity. In terms of structure, each annotation entry includes the editing type, relative path of the source image, relative path of the edited image, and the English instruction. The training data is divided into three parts: nano-consistent, ultravideo, and x2edit, corresponding to three JSON annotation files. Additionally, the dataset provides an evaluation benchmark called VINS-4KEval, which includes 509 carefully selected 4K/UHR test samples for assessing the performance of instruction-guided ultra-high-resolution image editing models, with a focus on instruction following, structure preservation, and detail quality. The dataset is released under the Apache License 2.0.
数据集概述
VINS-120K 是一个面向指令式超高清图像编辑的大规模数据集,旨在支持基于文本指令的、分辨率不低于 4K 的高质量图像编辑任务。
- 规模:包含 120,000 个精心构建的编辑三元组,每个样本由源图像、编辑后的目标图像和英文编辑指令组成。
- 分辨率:所有图像均为超高清图像,分辨率不低于 4K。
- 编辑类型:覆盖 13 种编辑类型,涵盖局部编辑、全局编辑、相机运动以及个性化生成。
- 数据来源:基于真实世界的超高清视频和高质量开源编辑数据构建,并通过多阶段筛选以确保视觉质量、指令对齐和美学保真度。
数据集结构
每个注释条目遵循以下格式:
edit_type:编辑类别input:源图像的相对路径output:编辑后图像的相对路径instruction:英文编辑指令
训练数据分为三个部分:
nano-consistent/ultravideo/x2edit/
对应的注释文件为:
nano-consistent.jsonultravideo.jsonx2edit.json
数据文件
仓库包含图像归档文件和 JSON 注释文件,目录结构如下:
. ├── nano-consistent/ │ ├── Image.tar.split.000 │ ├── Image.tar.split.001 │ ├── ... │ └── Image.tar.split.012 ├── ultravideo/ │ ├── clips_short_.tar │ └── ... ├── x2edit/ │ ├── 0.tar.split. │ ├── 1.tar.split.* │ ├── ... │ └── 7.tar.split.* ├── nano-consistent.json ├── ultravideo.json ├── x2edit.json ├── benchmark.tar └── assets/ └── vins120k_overview.jpg
基准测试:VINS-4KEval
数据集还提供了名为 VINS-4KEval 的基准测试集,包含 509 个精心挑选的 4K/UHR 测试样本,覆盖与 VINS-120K 相同的 13 种编辑类型,用于评估模型在超高清图像编辑方面的指令跟随、结构保持和细节质量。
许可证
该数据集采用 Apache License 2.0 许可发布。
引用
bibtex @inproceedings{chen2026vins, title={VINS-120K: Ultra High-Resolution Image Editing with A Large-Scale Dataset}, author={Chen, Zhizhou and Guan, Shanyan and Gao, Zhanxin and Ci, En and Ge, Yanhao and Li, Wei and Zhang, Zhenyu and Yang, Jian and Tai, Ying}, booktitle={Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition}, pages={15302--15312}, year={2026} }