
遇见数据集

kasuboski/gleam-code-corpus

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

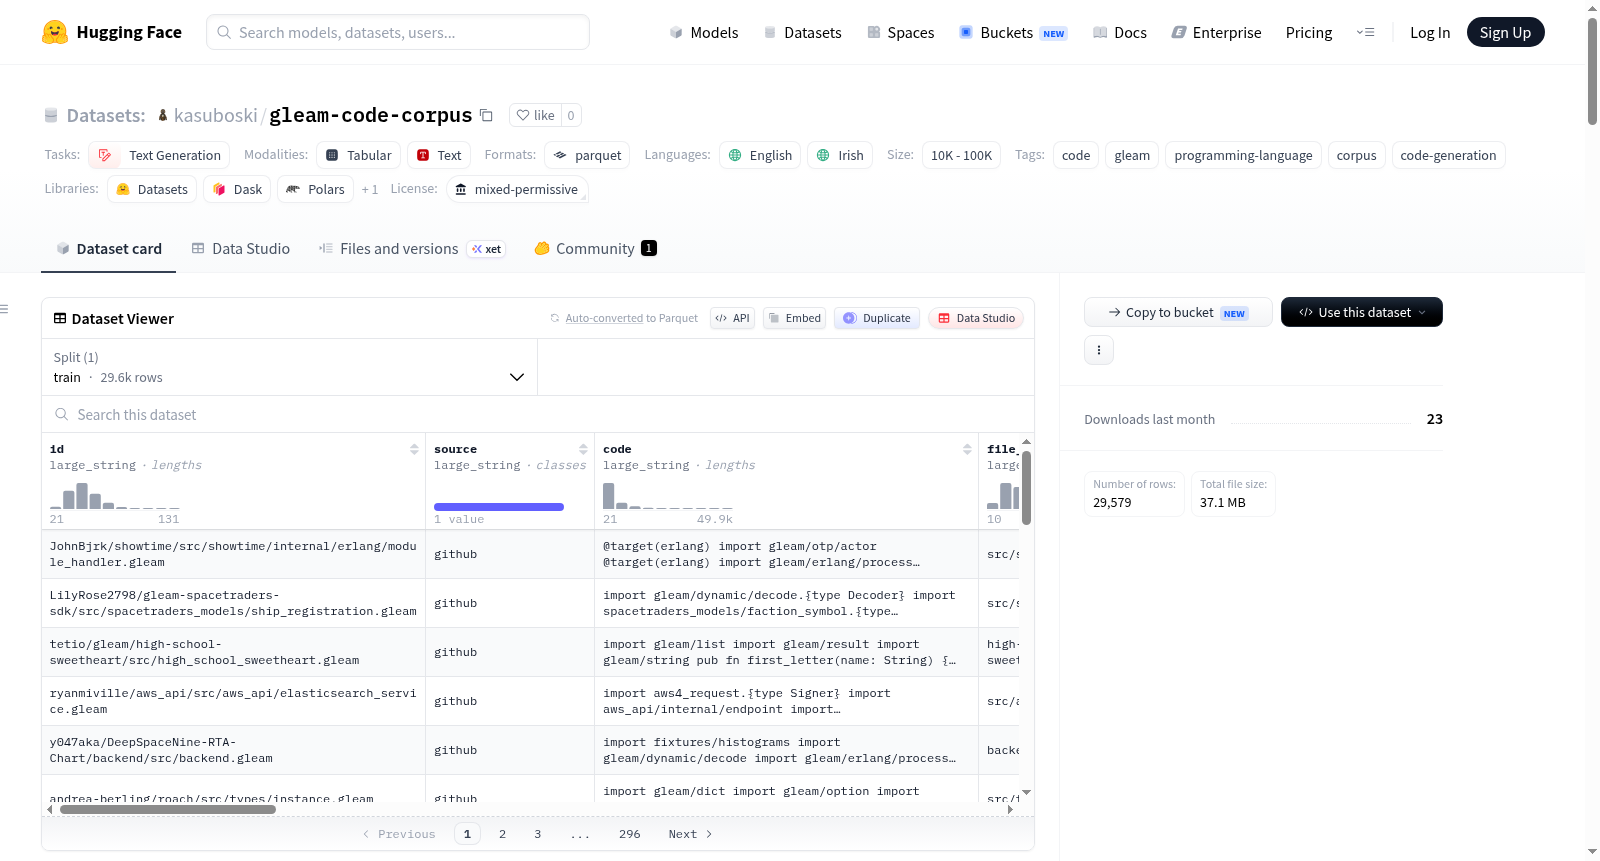
Gleam代码语料库是一个结构化、带属性的语料库,包含从1,528个GitHub仓库收集的22,581个Gleam源代码文件,用于持续预训练和代码生成研究。每个文件都包含完整的属性信息,如仓库所有者、名称、URL、许可证、星标数量以及可用的Hex.pm包元数据。该数据集适用于代码聚焦语言模型的持续预训练、Gleam代码生成的微调、小型编程语言生态系统研究以及Gleam习语和模式的参考语料库。它不是指令/响应对(参见配套的gleam-sft数据集)、文档(语言导览、hexdocs——单独的数据集)或原始未过滤数据(已移除生成文件、未许可代码和重复项)。

A structured, attributed corpus of 22,581 Gleam source files collected from 1,528 GitHub repositories for continued pre-training and code generation research. Every file includes full attribution — repo owner, name, URL, license, star count, and Hex.pm package metadata where available. What this is for: Continued pre-training (CPT) of code-focused language models, Fine-tuning models for Gleam code generation, Research on small programming language ecosystems, Reference corpus for Gleam idioms and patterns. What this is NOT: Instruction/response pairs (see the companion `gleam-sft` dataset, coming later), Documentation (language tour, hexdocs — separate dataset, coming later), Raw/unfiltered data (generated files, unlicensed code, and duplicates have been removed).
提供机构:
kasuboski
搜集汇总
数据集介绍
kasuboski/gleam-code-corpus 数据集图片
构建方式
该数据集的构建基于对Gleam编程语言生态系统的系统性挖掘。首先,通过GitHub搜索API以星标范围和日期范围分块查询,突破每查询1000条结果的限制,发现4660个独立仓库。随后,与Hex.pm包管理器的搜索结果交叉比对,以补充包名称及下载量信息。每个仓库以浅克隆方式提取所有.gleam文件,经过去重和严格的过滤流程,包括移除生成文件(字符数超5万)、存根文件(字符数不足20)、无许可证及非宽松许可的仓库、基于习题平台的低多样性代码,并对内容进行精确去重。最终,从69413个原始文件中筛选出22581个高质量文件,压缩率达67%。
特点
此数据集具备结构化、可归因且高度精炼的特点。它收录了来自1528个GitHub仓库的22581个Gleam源文件,每个文件均附带完整元数据,如仓库所有者、名称、许可证类型、星标数以及Hex.pm包信息。数据按配置分为三类:全量语料库、仅官方仓库子集、以及社区活跃仓库子集(星标≥10或Hex下载量≥1000),均采用宽松许可证。来源分布显示近半数文件来自src目录,测试与示例文件各占一定比例,星标从零至过千的多样化分布确保了代码风格与复杂度的广度,为模型训练提供了丰富的Gleam语言模式参考。
使用方法
该数据集专为代码语言模型的持续预训练与微调而设计,主要面向Gleam语言代码生成研究。通过HuggingFace Datasets库即可便捷加载,支持三种配置选择:‘all’获取完整语料,‘official’锁定官方仓库,‘community_top’聚焦社区高质量代码。每条记录为单个.gleam源文件,包含原始代码、仓库归属及许可证等字段。用户可遍历数据集访问代码内容,结合许可证信息进行合规使用。需注意,fork字段可靠性有限,Hex.pm元数据存在不完整性(仅44%文件关联),部分近重复分叉和半生成内容可能影响极端去重需求,但不妨碍整体训练质量。
背景与挑战
背景概述
Gleam是一种面向并发的强类型函数式编程语言,近年来在Web开发与系统编程领域逐渐崭露头角。然而,由于其中小规模的生态系统,专门针对Gleam代码的预训练语料库严重匮乏,限制了代码生成模型在该语言上的表现。为此,研究人员于2026年创建了Gleam Code Corpus数据集,由kasuboski及其合作团队从GitHub和Hex.pm平台系统收集并精心筛选了22,581个高质量Gleam源文件,涵盖1,528个仓库。该数据集旨在支持代码语言的持续预训练、微调代码生成模型,以及对小规模编程语言生态系统的研究。其发布填补了Gleam领域缺乏结构化、可归属语料库的空白,为代码智能研究和Gleam社区的发展提供了坚实基础。
当前挑战
该数据集构建面临多重挑战。在领域问题层面,针对小规模编程语言的代码生成研究普遍受限于数据匮乏,模型易因训练样本不足而泛化能力弱,新兴语言如Gleam因此难以享受到主流语言成熟的预训练成果。在构建过程中,首先需要突破GitHub搜索API每次查询最多返回1,000个结果的限制,通过星标范围与日期范围分块,从超过4,600个仓库中实现有效发现。其次,获取授权许可的挑战尤为突出,由于大量仓库未明确许可或使用GPL等非宽松许可证,经严格过滤后,42,368个文件因无许可证被移除。此外,还需解决自动生成文件、模板化代码和内容重复的问题,通过多阶段质量管线剔除了近70%的原始文件,最终保留22,581个高可用样本,并确保每条记录包含完整的归属元数据以保障溯源与合规性。
常用场景
经典使用场景
本数据集作为针对Gleam编程语言的首个大规模有属性语料库,其最经典的使用场景在于支撑代码导向的语言模型的持续预训练与微调过程。研究者可借助其中涵盖的22,581个源文件及丰富的元数据信息,构建能够理解并生成Gleam代码的神经架构,从而推动小众编程语言领域自然语言处理研究的纵深发展。
实际应用
在实际工程应用中,该语料库可被用于开发面向Gleam语言的代码自动补全、错误检测与修复、文档生成等智能化开发工具。企业团队能够基于这些数据微调专用语言模型,提升在Gleam生态内进行项目迭代和维护时的开发效率。同时,它也为Hex.pm包管理器相关的自动化代码注释与API推荐服务提供了训练素材,促进了Gleam社区工具链的成熟。
衍生相关工作
基于本数据集,研究者已或即将开展多类衍生工作,包括配套的指令微调数据集(如companion `gleam-sft`)以及文档语料库的构建。这些资源共同构成了Gleam语言模型训练的完整基础设施,催生了关于小众语言持续预训练策略、异构许可代码的合规使用、以及基于社区活跃度进行数据筛选等方法的探索,为编程语言处理领域提供了可复现的研究基线。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

