
遇见数据集

swiss-ai/MaxMin_Tr_3600-Filtered-Decontaminated

收藏
Hugging Face2026-06-22 更新2026-07-22 收录
官方服务:

资源简介:

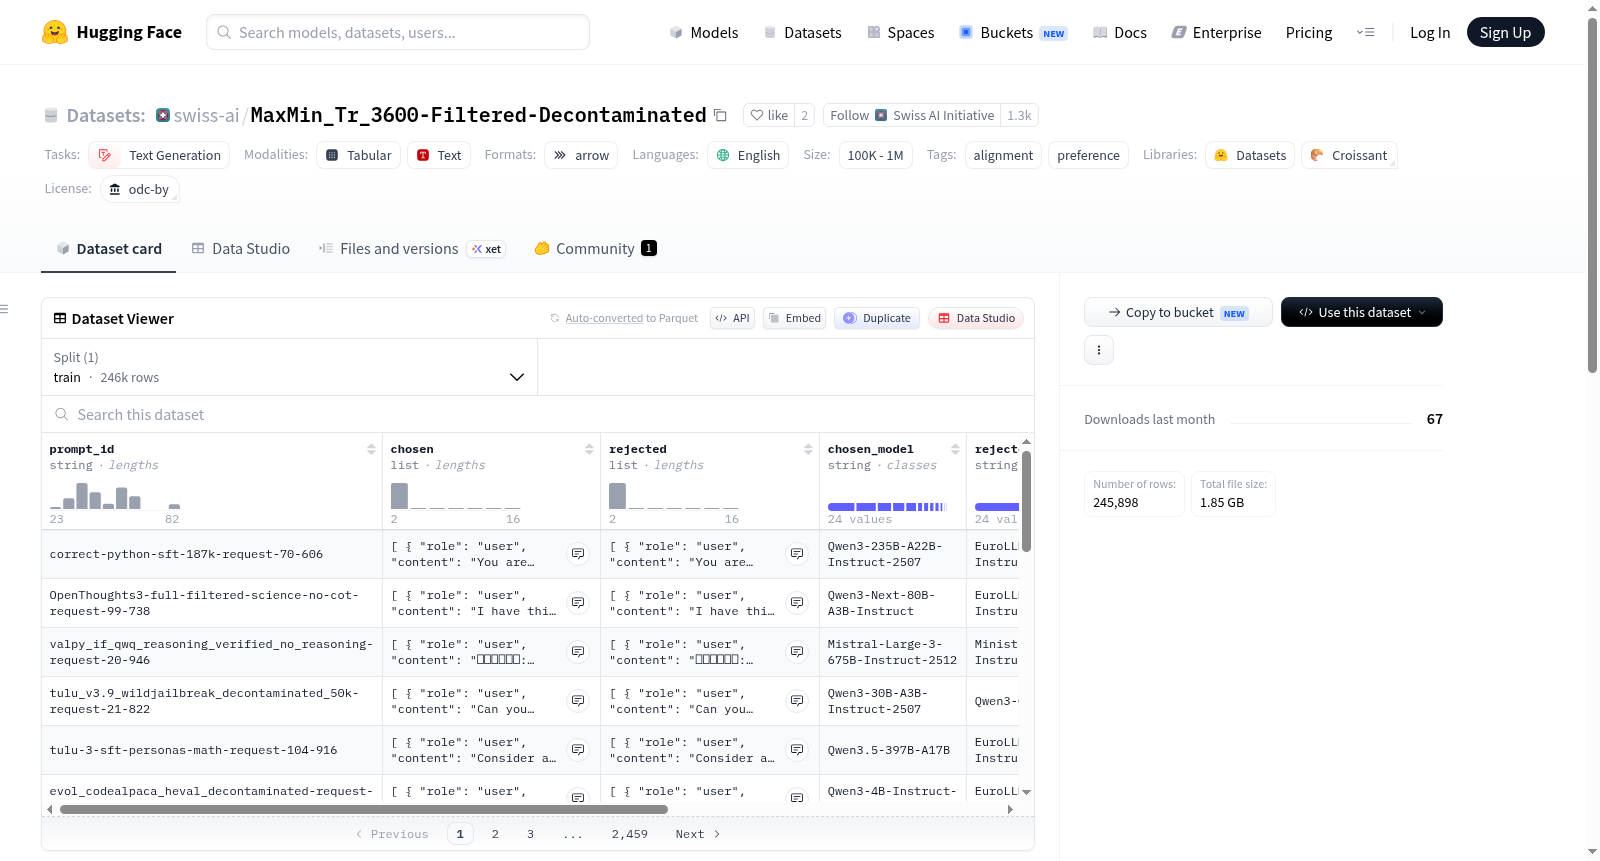
Apertus 1.5偏好数据集是用于Apertus v1.5对齐训练(在线DPO)的最终偏好数据集。该数据集源自Ai2的Olmo 3 Dolci-Instruct-DPO数据集,但仅使用了其中的提示(prompts);所有“chosen”和“rejected”响应均由数据集构建者生成。构建过程包括:提示取自Dolci-Instruct-DPO,响应通过swiss-ai/posttraining-data仓库和指定模型池生成,应用了去污染过滤(针对评估套件)和长度过滤(去除提示与生成完成超过3600个令牌的行)。经过过滤后,剩余245,898个提示。数据集基于ODC-BY许可证发布,适用于研究和教育用途,遵循Ai2的负责任使用指南。

This is the final preference dataset used for Apertus v1.5 alignment training (online DPO). It is derived from Ai2s Olmo 3 Dolci-Instruct-DPO dataset. In the online DPO setting, only the prompts are reused from Dolci-Instruct-DPO; all chosen and rejected responses in this dataset were generated by the creators. The dataset was built by taking prompts from Dolci-Instruct-DPO, generating responses using the swiss-ai/posttraining-data repository and a specified model pool, applying decontamination filtering against an evaluation suite, and removing rows where the prompt plus generated completions exceeded 3600 tokens. After decontamination and length filtering, 245,898 prompts remain. It is released under the ODC-BY license for research and educational use in accordance with Ai2s Responsible Use Guidelines.
提供机构:
swiss-ai
搜集汇总
数据集介绍
swiss-ai/MaxMin_Tr_3600-Filtered-Decontaminated 数据集图片
构建方式
本数据集源自Allen AI发布的Dolci-Instruct-DPO,仅复用其原始提示(prompts),所有偏好对中的chosen与rejected响应均由我们基于swiss-ai/posttraining-data工具链自主生成。生成过程中调用了一个精心策划的模型池,确保响应质量的多样性。随后,我们应用了严格的去污染过滤,剔除与内部评估基准集重叠的样本,再过滤掉提示与响应总长度超过3600个token的条目,最终保留245,898条高质量偏好数据。
特点
该数据集专为在线DPO对齐训练设计,具有鲜明的实用导向。其核心优势在于响应生成的自主性与可控性,避免了依赖第三方数据的偏差。通过长度与去污染双重过滤,数据集在保证训练效率的同时,显著降低了评估泄露风险。作为Apertus v1.5模型的最终对齐数据集,它在规模、纯净度与领域针对性上达到了精妙平衡。
使用方法
数据集采用标准text-generation格式,适用于基于HuggingFace Transformers的偏好对齐训练流程。使用时可直接加载提示字段,配合在线DPO或类似算法,以chosen与rejected响应作为优化信号。建议在训练前完成分词与截断(如3600 token限制),并遵循ODC-BY许可协议,仅限于研究或教育场景,同时需引用Apertus项目相关文献。
背景与挑战
背景概述
在大型语言模型(LLM)的后训练对齐阶段,偏好数据集的质量直接影响模型与人类意图的一致性。MaxMin_Tr_3600-Filtered-Decontaminated数据集(亦称Apertus 1.5 Preference Dataset)由瑞士人工智能研究团队创建,主要用于Apertus v1.5模型的在线直接偏好优化(DPO)训练。该数据集以Allen AI的Olmo 3 Dolci-Instruct-DPO为提示来源,通过自主生成“选择/拒绝”响应并经过严格的去污染与长度过滤构建而成。其核心研究问题在于如何在在线DPO框架下高效构造高质量偏好数据,以提升模型在奖励建模与多任务对齐中的表现。该数据集为开源社区提供了约24.6万条干净提示,推动了偏好学习领域中数据去污染与提示重用策略的发展。
当前挑战
该数据集面临的核心挑战包括:领域问题层面,如何从原始提示中生成区分度高的“选择/拒绝”响应以提升DPO训练效果,避免响应质量低下或对同一提示的偏好判断模糊,从而削弱对齐模型的判别能力;构建过程层面,需应对提示来源单一(仅来自Dolci-Instruct-DPO)可能导致的多样性不足,以及去污染过滤与长度过滤器(超过3600 tokens的条目被移除)带来的数据规模缩减与代表性偏差,确保剩余样本能覆盖关键偏好场景而不引入评估污染。
常用场景
经典使用场景
在大型语言模型的对齐训练中,偏好数据集扮演着不可或缺的角色。该数据集专为在线直接偏好优化(DPO)框架设计,其核心用途在于通过模型自身生成的偏好对来校准模型行为。具体而言,数据集复用Dolci-Instruct-DPO中的高质量指令作为提示,并由研究者使用多样化模型池生成chosen和rejected响应,构成完整的偏好学习样本。这一流程确保了训练数据与模型实际分布的一致性,从而有效提升在线DPO的收敛效果和泛化能力。研究者通常将其用于训练阶段中的偏好精调,使模型在遵循指令、生成符合人类偏好的文本方面实现显著改进。
衍生相关工作
该数据集衍生了若干重要的后续工作,其中最具代表性的是Apertus v1.5系列模型的完整对齐训练流程,研究者基于该数据集进行在线DPO训练,并系统比较了不同模型池响应生成策略对最终对齐效果的影响。此外,去污染与长度过滤的预处理管线被提炼为可复用的工具库,为其他偏好数据集的构建提供了标准化范式。部分工作进一步探索了在相同提示集上使用不同温度采样或拒绝采样策略生成偏好对,衍生出一系列关于采样多样性对DPO训练影响的实证研究。这些衍生工作共同丰富了语言模型偏好对齐的理论与实践,形成了从数据构建到模型训练再到评估验证的完整闭环。
数据集最近研究
最新研究方向
在大型语言模型偏好对齐领域,MaxMin_Tr_3600-Filtered-Decontaminated数据集作为Apertus v1.5在线DPO训练的核心偏好数据集,代表了从现有高质量指令数据集(如Ai2的Dolci-Instruct-DPO)中仅复用提示、由研究者自主生成胜负响应的前沿方法论。该数据集通过严格去污与长度过滤,确保评估基准无泄漏,并针对3600 token限制优化了长序列对齐效果。其构建过程反映了当前热点:利用模型池进行多样化响应生成,并强调数据质量管控对对齐训练的关键影响,为提升语言模型的价值一致性提供了可复现的实践范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

