遇见数据集

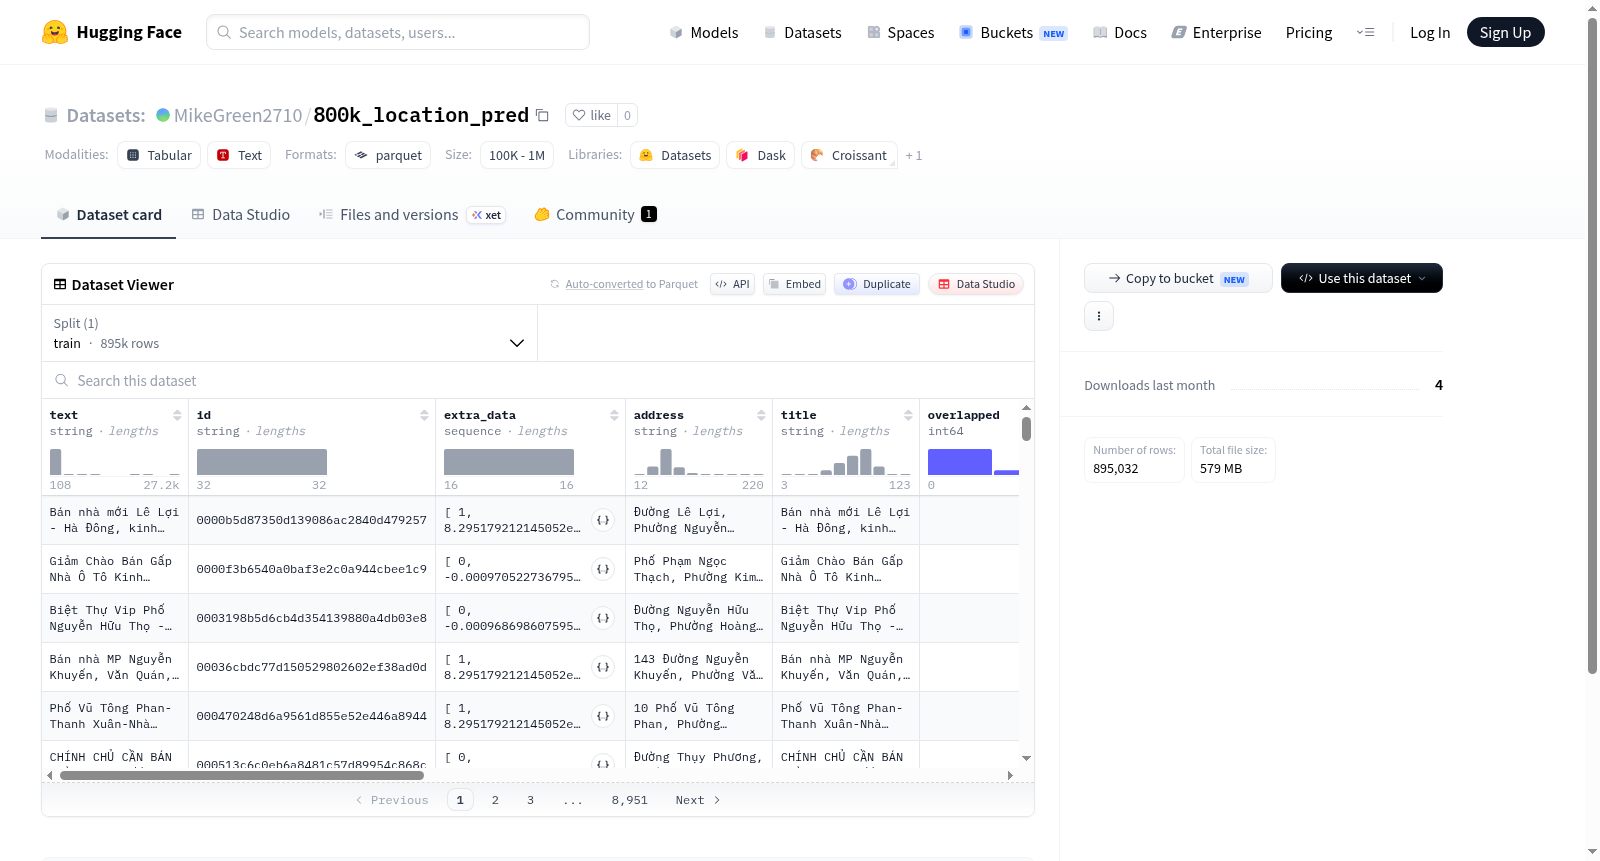
MikeGreen2710/800k_location_pred

收藏
Hugging Face2024-05-24 更新2024-06-12 收录
官方服务:

资源简介:

--- dataset_info: features: - name: text dtype: string - name: id dtype: string - name: extra_data sequence: float64 - name: address dtype: string - name: title dtype: string - name: overlapped dtype: int64 - name: label dtype: int64 - name: city dtype: string - name: district dtype: string - name: ward dtype: string - name: street dtype: string - name: price_std dtype: float64 - name: house_front_std dtype: float64 - name: road_wide_std dtype: float64 - name: car_area_std dtype: float64 - name: number_of_floors_std dtype: float64 splits: - name: train num_bytes: 1257689308 num_examples: 895032 download_size: 578750554 dataset_size: 1257689308 configs: - config_name: default data_files: - split: train path: data/train-* ---

数据集信息: 特征列: - 字段名:text,数据类型:字符串 - 字段名:id,数据类型:字符串 - 字段名:extra_data,数据类型:64位双精度浮点数序列 - 字段名:address,数据类型:字符串 - 字段名:title,数据类型:字符串 - 字段名:overlapped,数据类型:64位整数 - 字段名:label,数据类型:64位整数 - 字段名:city,数据类型:字符串 - 字段名:district,数据类型:字符串 - 字段名:ward,数据类型:字符串 - 字段名:street,数据类型:字符串 - 字段名:price_std,数据类型:64位双精度浮点数 - 字段名:house_front_std,数据类型:64位双精度浮点数 - 字段名:road_wide_std,数据类型:64位双精度浮点数 - 字段名:car_area_std,数据类型:64位双精度浮点数 - 字段名:number_of_floors_std,数据类型:64位双精度浮点数 数据划分: - 划分名称:train,占用字节数:1257689308,样本数量:895032 下载大小:578750554,数据集总大小:1257689308 配置项: - 配置名称:default,数据文件: - 对应划分:train,文件路径:data/train-*

提供机构:
MikeGreen2710
原始信息汇总

数据集概述

数据集特征

  • text:字符串类型
  • id:字符串类型
  • extra_data:序列类型,浮点数64位
  • address:字符串类型
  • title:字符串类型
  • overlapped:整数64位
  • label:整数64位
  • city:字符串类型
  • district:字符串类型
  • ward:字符串类型
  • street:字符串类型
  • price_std:浮点数64位
  • house_front_std:浮点数64位
  • road_wide_std:浮点数64位
  • car_area_std:浮点数64位
  • number_of_floors_std:浮点数64位

数据集分割

  • train:
    • 字节数:1257689308
    • 示例数:895032

数据集大小

  • 下载大小:578750554字节
  • 数据集大小:1257689308字节

配置

  • config_name:default
  • data_files:
    • split:train
    • path:data/train-*
搜集汇总
数据集介绍
MikeGreen2710/800k_location_pred 数据集图片
构建方式
在位置预测领域,高质量标注数据集的构建是模型性能提升的关键基石。MikeGreen2710/800k_location_pred数据集源自海量房地产文本数据,通过系统性的信息抽取与结构化处理而成。每条样本包含原始描述文本、唯一标识符、多维数值特征(如价格、房屋面宽、道路宽度、车位面积、楼层数等)以及细粒度地理信息(城市、区、街道等)。数据集的构建过程注重空间语义对齐,将非结构化的地址描述与标准化的行政区划层级进行映射,同时引入重叠标记(overlapped)以标识可能存在的地理位置歧义,从而确保训练数据的地理准确性与可靠性。
特点
该数据集最为突出的特点在于其规模庞大与信息维度丰富。训练集包含近90万条样本,为深度位置预测模型提供了充足的训练资源。每条样本不仅囊括了传统的文本地址描述,还整合了多个与房地产价值紧密相关的结构化数值属性,形成了文本与数值特征并存的复合数据结构。此外,地理标签体系覆盖了从城市到街道的多粒度层级,支持不同精度下的位置预测任务。数据集中还特别设计了重叠样本标记,这为研究地址消歧、空间实体链接等前沿问题提供了宝贵的实验素材。
使用方法
使用该数据集时,研究者可根据具体任务灵活提取所需字段。对于纯文本位置预测任务,可直接利用'text'字段作为输入,以'city'、'district'等地理标签作为预测目标。对于多模态位置预测场景,可将'text'字段与'price_std'等数值特征拼接,构建混合输入模型。数据集已预分为训练集,用户可通过HuggingFace Datasets库直接加载,并利用其内置的序列化格式高效读取。推荐在训练前对数值特征进行标准化或归一化处理,同时注意利用'overlapped'字段筛除或加权处理歧义样本,以提升模型的泛化能力。
背景与挑战
背景概述
在房地产与城市计算领域,精准的位置预测能力对于智能定价、区域规划及商业决策具有深远意义。MikeGreen2710/800k_location_pred数据集由研究者于2023年构建,旨在利用多模态特征实现房产地理位置的细粒度推断。该数据集汇集了约80万条训练样本,每条样本不仅包含文本描述、地址、标题等语义信息,还整合了价格、房屋朝向、道路宽度、车位面积、楼层数等结构化数值特征,形成了对房产属性的全面刻画。其核心研究问题在于,如何从异构数据中联合学习空间分布规律,以支持从城市、区、街道乃至更精细行政单元的层级化定位。该数据集的发布填补了大规模、多特征位置预测基准的空白,为地理空间智能与自然语言处理的交叉研究提供了重要资源,推动了城市信息学领域从粗粒度分类向细粒度回归与推理的演进。
当前挑战
该数据集所解决的领域问题聚焦于多源异构数据下的位置预测,其核心挑战在于:1)如何从非结构化文本(如广告描述)与结构化数值(如价格、面积)中提取协同的空间语义,以克服单一模态信息的模糊性;2)细粒度定位(如街道层级)面临样本分布不均衡与地理边界模糊的难题,需设计鲁棒的模型以应对噪声标签与重叠区域(overlapped字段)的干扰。在数据集构建过程中,挑战同样严峻:首先,原始数据的清洗与标准化(如price_std、house_front_std等字段)需兼顾计量单位一致性与异常值处理,确保特征有效性;其次,从多源爬取的数据中准确提取地址层级(city、district、ward、street)并消除冗余信息,依赖复杂的规则与人工校验;最后,大规模数据的存储与高效加载(如分片存储train-*文件)对计算资源与数据管道设计提出了较高要求。
常用场景
经典使用场景
在房地产与城市计算研究领域,MikeGreen2710/800k_location_pred数据集凭借其海量的房产挂牌数据与精细的空间层级标注,成为地理空间预测任务中的标杆资源。该数据集最经典的使用场景是构建基于文本与结构化特征的房产位置预测模型,研究者能够利用其中的地址、街道、行政区划等字段,结合价格、房屋面积、楼层数等多维属性,训练模型精准推断房产所属的城市、区县乃至街道级别。这一场景不仅验证了自然语言处理与地理信息系统的交叉可行性,还为后续的智能选址与空间感知推理研究奠定了数据基础。
衍生相关工作
围绕该数据集,学术界与工业界诞生了一系列经典衍生工作。研究者基于其丰富的结构化特征与文本信息,提出了融合图神经网络与预训练语言模型的空间位置推理框架,显著提升了细粒度位置预测的准确率。另有工作聚焦于跨城市迁移学习,利用该数据集的标注层级设计自适应地理编码算法,缓解了数据稀疏地区的模型泛化难题。这些衍生研究不仅深化了地理空间人工智能的理论体系,也为城市计算、智能交通与智慧地产等交叉领域提供了可复用的方法论范式。
数据集最近研究
最新研究方向
该数据集聚焦于房地产领域的细粒度地理位置预测与价值评估,其包含的文本描述、结构化地址信息及多维房产特征(如价格、户型、楼层、道路宽度等)为空间智能与城市计算提供了前沿研究基础。当前热点方向包括基于大语言模型的房产属性推断与地理语义理解,通过融合多源异构数据实现高精度位置匹配与区域价值建模。该数据集的发布推动了房地产数据分析从传统统计回归向深度学习与知识图谱的转型,尤其在智慧城市、房产推荐系统及经济地理学交叉研究中具有重要影响,为探索城市空间结构与人类活动模式提供了可靠的数据支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务