
nassimjp/alpaca-pashto-cleaned
收藏官方服务:
资源简介:
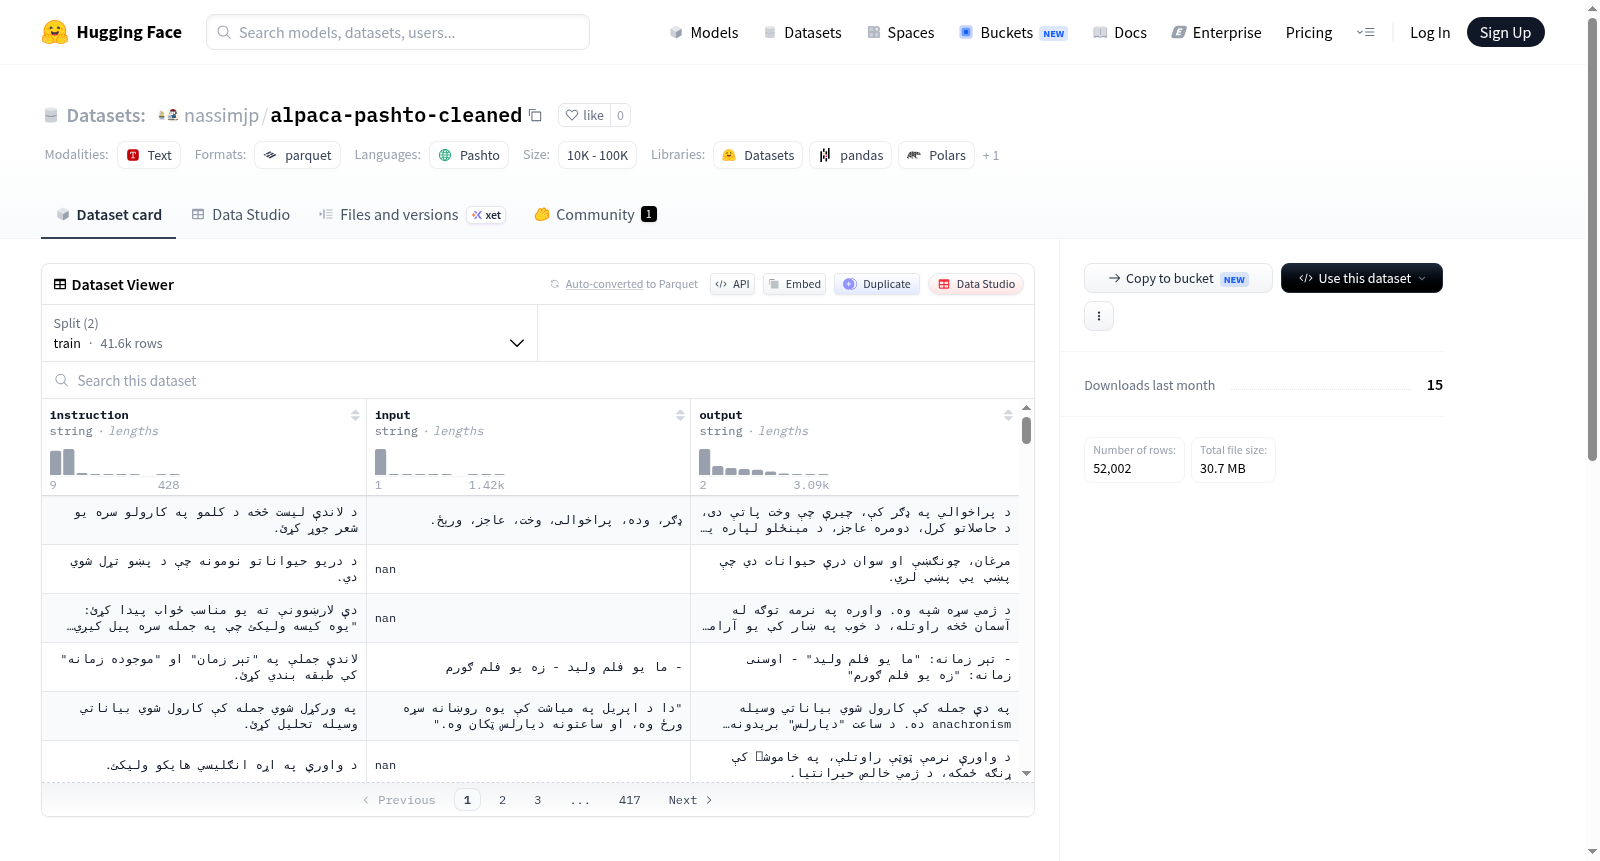
该数据集是Pashto alpaca-52k,基于原始Alpaca-52K数据集,通过Google Translate翻译成普什图语(语言代码:ps)生成。它旨在支持低资源语言的跨语言迁移研究,特别是用于TaCo论文中提出的翻译辅助思维链过程。数据集规模在10万到100万样本之间,适用于学术和研究目的,遵循CC BY-NC许可。
This dataset is Pashto alpaca-52k, derived from the original Alpaca-52K dataset and translated into Pashto (language code: ps) using Google Translate. It is designed to support cross-lingual transfer research for low-resource languages, particularly for the translation-assisted chain-of-thought processes in the TaCo paper. The dataset size ranges between 100K and 1M samples and is intended for academic and research purposes under the CC BY-NC license.
提供机构:
nassimjp搜集汇总
数据集介绍
构建方式
alpaca-pashto-cleaned数据集以斯坦福大学发布的Alpaca-52K英文指令数据集为源,借助谷歌翻译引擎将其完整转换为普什图语,从而构建出一个面向低资源语言的跨语言指令微调数据集。该过程旨在弥补普什图语在自然语言处理领域高质量标注数据的稀缺性,通过机器翻译实现大规模数据的低成本获取,为后续的模型训练与评估提供了基础。
使用方法
研究者可借助Hugging Face平台直接加载该数据集,用于普什图语大语言模型的指令微调与性能评估。在使用时,建议配合原始的英文Alpaca数据集进行对比分析,以探究翻译质量对模型跨语言泛化能力的影响。同时,需注意该数据集仅限学术研究用途,并遵守CC BY-NC许可协议及相关第三方服务条款。
背景与挑战
背景概述
在自然语言处理领域,指令微调数据集是提升大型语言模型(LLM)遵循指令能力的关键资源。然而,现有数据集主要集中于英语等高资源语言,普什图语等低资源语言面临数据稀缺的严峻挑战。为此,Bibek Upadhayay和Vahid Behzadan于2024年在ICLR的第五届低资源场景实用机器学习研讨会上提出了alpaca-pashto-cleaned数据集。该数据集源自斯坦福Alpaca-52K,通过Google Translate翻译为普什图语并清洗得到,旨在支持跨语言迁移学习研究。其核心研究问题在于验证翻译辅助的链式思维(Chain-of-Thought)过程能否增强LLM在低资源语言上的指令跟随能力。这一工作对推动低资源语言NLP研究、缩小语言技术鸿沟具有重要影响。
当前挑战
该数据集面临多重挑战。在领域问题层面,普什图语作为低资源语言,缺乏大规模高质量的指令微调数据,导致LLM在该语言上指令遵循能力极差,限制了多语言NLP模型的普惠性。在构建过程中,翻译质量是主要挑战:Google Translate对普什图语的翻译可能存在语义偏差或语法错误,需额外清洗;Alpaca-52K原始数据中部分指令依赖英语文化语境,直接翻译后可能失去可理解性;此外,数据集规模(约52K样本)虽适中,但来源单一,缺乏多样性,可能影响模型在真实场景下的泛化能力。
常用场景
经典使用场景
在自然语言处理与低资源语言研究的交汇处,alpaca-pashto-cleaned数据集扮演着桥梁般的角色。它源自经典的Alpaca-52K英文指令数据集,经由Google翻译转化为普什图语,并经人工清洗以提升质量。该数据集最经典的使用场景在于微调大型语言模型(LLMs),使其能够理解和生成普什图语的指令性输出。研究者利用此数据集在跨语言迁移学习框架下,探索如何以翻译辅助的方式将高资源语言(如英语)的指令遵循能力转移到低资源语言上,从而填补普什图语在对话AI与自然语言理解领域的数据空白。
解决学术问题
该数据集直击低资源语言在大型语言模型研究中面临的‘数据荒漠’困境。学术上,它解决了如何为缺乏大规模原生语料的语言(如普什图语)构建高效指令数据集的问题。通过翻译加清洗的策略,alpaca-pashto-cleaned验证了跨语言迁移在维持任务性能上的可行性,并揭示了翻译噪声对模型输出的影响。其意义在于为低资源语言的指令微调提供了可复现的基线,推动了多语言NLP领域的公平性研究,使得研究者能够量化评估不同语言间的语义对齐程度,从而促进更鲁棒的跨语言泛化理论发展。
实际应用
在实际应用层面,alpaca-pashto-cleaned数据集赋能了面向普什图语社区的智能服务开发。例如,基于此数据集微调的对话模型可用于阿富汗地区的人道主义援助信息查询系统,自动回答关于医疗、教育或安全指南的普什图语问题。此外,它还能增强翻译引擎对普什图语指令的理解能力,改善本地化客服机器人的交互体验。在新闻摘要和法律文档解读等场景中,该数据集训练的模型能够将复杂的英文指令转化为朗朗上口的普什图语解释,从而打破语言壁垒,让低资源语言用户也能享受大模型带来的便捷。
数据集最近研究
最新研究方向
围绕低资源语言普什图语的跨语言迁移学习,该数据集通过翻译Alpaca-52K构建,支撑了TaCo论文中提出的翻译辅助思维链方法,旨在增强大语言模型在低资源场景下的指令跟随与推理能力,契合当前多语言AI伦理与公平性的热点,对推动少数语言数字化与全球包容性AI发展具有重要研究价值。
以上内容由遇见数据集搜集并总结生成


