
遇见数据集

ghananlpcommunity/voxcpm-ghana-latents

收藏
Hugging Face2026-06-28 更新2026-07-22 收录
官方服务:

资源简介:

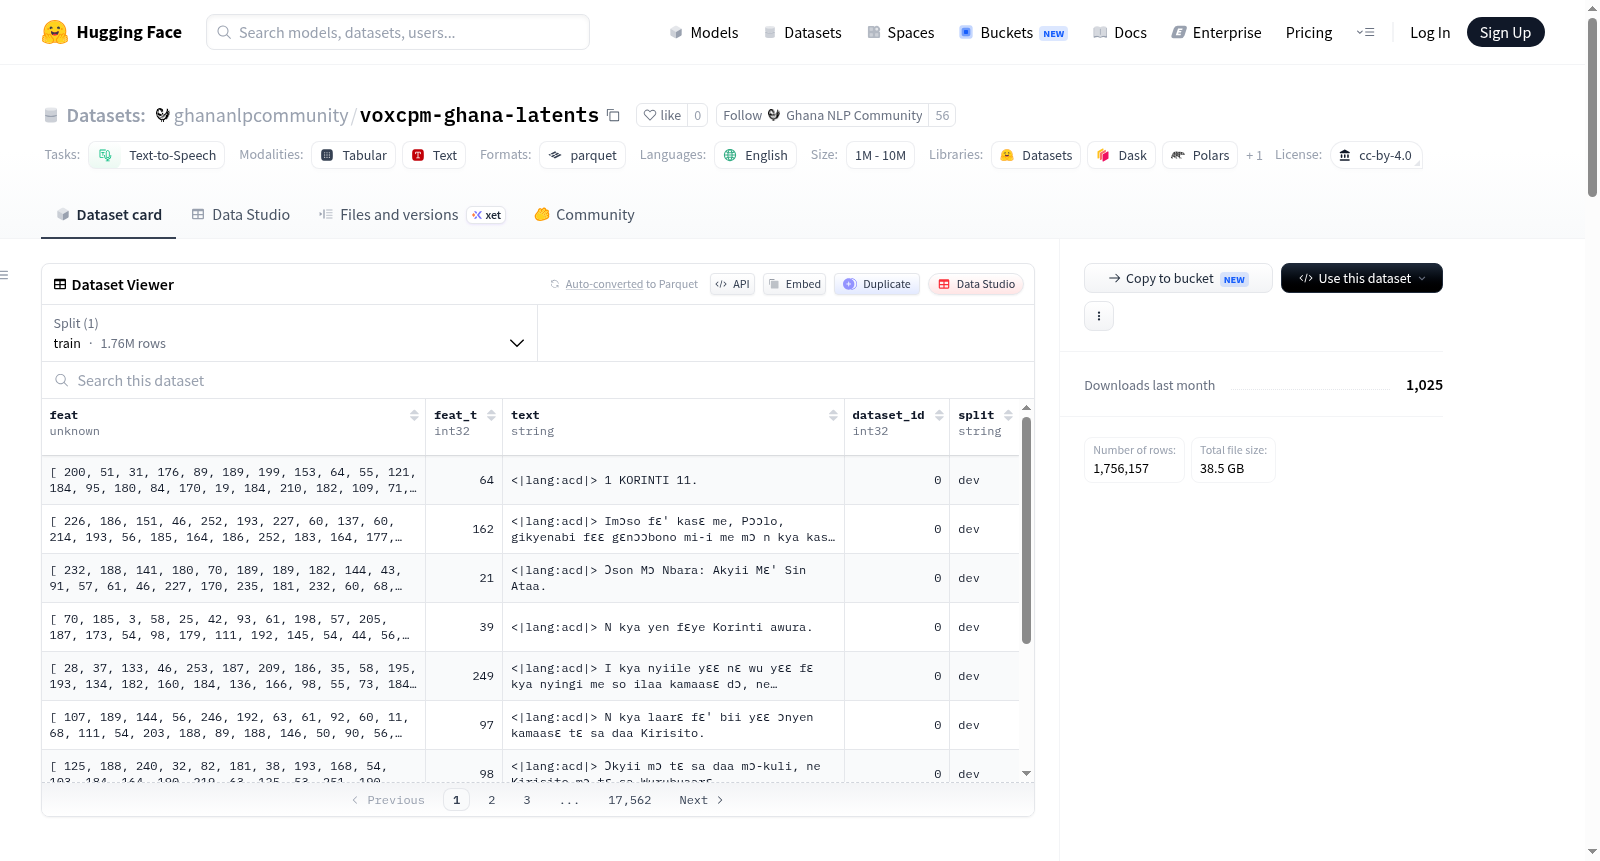
VoxCPM Ghana — Precomputed AudioVAE Latents 是一个用于文本转语音任务的数据集,专门用于微调模型 ghananlpcommunity/voxcpm-ghana。它包含预计算的 VoxCPM-0.5B AudioVAE 潜在表示(16 kHz),覆盖 42 种加纳语言(包括 Twi 的两种变体:twi-asante 和 twi-akuapem)以及过滤的加纳英语。数据集中每个剪辑都带有语言标签的转录文本,格式为 <|lang:CODE|>,其中 CODE 是 ISO-639-3 语言代码。数据集总计 1,756,157 个剪辑,约 3,400 小时音频,采样率为 16 kHz。AudioVAE 潜在表示的维度为 64,跳跃长度为 640(约每秒 25 帧)。数据以 parquet 分片格式存储,列包括:feat(二进制格式的 fp16 AudioVAE 潜在表示,形状为 [feat_t, 64])、feat_t(潜在帧数)、text(带语言标签前缀的转录文本)、dataset_id(每种语言的数字标识符)和 split(训练集 train 或开发集 dev)。数据来源于 ghananlpcommunity/ghana-speech 和 ghananlpcommunity/ghana-english-tts-filtered 数据集。该数据集可直接用于 VoxCPM 微调,无需在训练时进行音频解码或 VAE 编码。

VoxCPM Ghana — Precomputed AudioVAE Latents is the exact training-ready data used to fine-tune the model ghananlpcommunity/voxcpm-ghana. It consists of precomputed VoxCPM-0.5B AudioVAE latents (16 kHz) for 42 Ghanaian languages (including Twi split into twi-asante and twi-akuapem) and filtered Ghanaian English, with language-tagged transcripts. The dataset contains 1,756,157 clips, approximately 3,400 hours of audio at 16 kHz. The AudioVAE latents are 64-dimensional with a hop of 640 (approximately 25 frames per second). Data is stored in parquet shards with columns: feat (binary fp16 AudioVAE latent with shape [feat_t, 64]), feat_t (number of latent frames), text (transcript prefixed with the language tag <|lang:CODE|>), dataset_id (per-language numeric identifier), and split (train or dev, with balanced development clips). It is derived from the ghananlpcommunity/ghana-speech and ghananlpcommunity/ghana-english-tts-filtered datasets. This dataset serves as a drop-in replacement for VoxCPM fine-tuning, eliminating the need for audio decoding or VAE encoding during training.
提供机构:
ghananlpcommunity
搜集汇总
数据集介绍
ghananlpcommunity/voxcpm-ghana-latents 数据集图片
构建方式
该数据集基于加纳语音社区提供的原始音频语料库构建,源自Ghana Speech与Ghana English TTS Filtered两个公开数据集。研究者首先将涵盖42种加纳本土语言及经过筛选的加纳英语语音数据,通过OpenBMB团队开发的VoxCPM-0.5B模型的AudioVAE编码器进行预处理,将原始音频信号转换为16kHz采样率下的64维潜在特征序列,每帧间隔约25个特征点。编码得到的潜在特征以二进制形式存储,每个特征序列保留原始时间维度信息,并与其对应的语言标签转录文本配对。所有数据以Parquet分片格式归档,每个分片按语言代码命名,确保了大规模训练数据的高效加载与随机访问。
特点
该数据集的核心特色在于其训练即用型设计,存储了约175万条、总时长超过3400小时的预计算潜在特征,彻底免除了训练时实时音频解码与VAE编码的计算开销。数据集的转录文本均带有明确的语言标签前缀,模型可识别包括Twi方言细分(Asante与Akuapem)在内的43个语言变体。特征维度统一为64维,帧率恒定在每秒25帧,为多语言语音合成模型的迁移学习提供了高度规整的输入空间。此外,每个语言均包含约40条开发集样本,便于跨语言性能评估,而数据集的CC-BY-4.0许可协议保障了学术与商业用途的自由。
使用方法
使用该数据集时,开发者可直接通过读取Parquet文件中的feat与text列获取训练数据。潜在特征需通过np.frombuffer函数解析为fp16格式并重塑为[feat_t, 64]的张量,随后作为VoxCPM模型的直接输入。转录文本已嵌入<|lang:CODE|>格式的语言标签,无需额外处理即可被无分词器的VoxCPM模型解析。数据集已预设train与dev两种切分模式,其中开发集按语言平衡采样,适用于跨语言微调任务的损失监控。训练时建议采用多进程数据加载器并行读取Parquet分片,并利用feat_t列动态屏蔽变长序列的无效帧,以适配不同时长音频样本的批处理需求。
背景与挑战
背景概述
VoxCPM Ghana Latents数据集由加纳NLP社区构建,旨在推动低资源语言语音合成技术的发展。该数据集发布于2024年,围绕多语言文本到语音生成这一核心问题,提供了涵盖42种加纳本土语言的预计算AudioVAE潜在表示。通过将原始音频压缩为64维、帧率约25fps的潜在特征,数据集显著降低了模型微调的计算门槛。作为VoxCPM-0.5B模型加纳语言微调的关键数据源,它促进了非洲语言在语音技术领域的平等参与,为相关研究树立了重要基准。
当前挑战
该数据集面临的核心挑战在于解决低资源语言语音合成的领域困境:多数加纳语言缺乏大规模标注语音数据,传统TTS模型难以泛化至这些语种。构建过程中需应对多语言音系差异、文本标注一致性以及音频质量筛选等问题,特别是Twi语种因方言差异需拆分为阿散蒂和阿夸佩姆两种变体。此外,从原始语音数据到潜在特征的编解码过程可能引入信息损失,影响合成语音的自然度和保真度,这对潜在空间表征的鲁棒性提出了较高要求。
常用场景
经典使用场景
VoxCPM Ghana — Precomputed AudioVAE Latents 数据集的核心价值在于为多语言语音合成任务提供了一种高效的训练前处理范式。该数据集包含了预计算的 VoxCPM-0.5B 模型所需的 AudioVAE 潜在表示,覆盖加纳 42 种本土语言及经过筛选的加纳英语,共计超过 175 万个音频片段,时长约 3400 小时。研究者无需在训练过程中进行音频解码或 VAE 编码,可直接加载 64 维、帧率约 25 fps 的潜在特征,大幅降低了计算开销。其经典使用场景是作为 VoxCPM 模型的微调输入,尤其在处理低资源语言时,能够通过语言标签引导模型学习多语言间的声学与韵律共性,从而在统一框架下实现高质量、多说话人的跨语言语音合成。
实际应用
在现实落地层面,该数据集为加纳及西非地区的语音技术产业化铺平了道路。基于预计算潜在表示的特性,开发者可直接将模型部署于边缘设备或云端服务中,实现针对 42 种本土语言的语音合成应用,例如智能语音助手、无障碍阅读工具与教育领域的语音教材生成。语言标签机制使得系统能够灵活适配不同方言(如 Twi 方言的细分),满足地方广播、公共交通语音播报及文化传承中的个性化需求。此外,该数据集兼容 VoxCPM 的 tokenizer-free 架构,意味着其训练产物可无缝集成至更大规模的多语言对话系统中,显著降低模型微调与迭代的时间成本,为非洲多语种地区的数字包容性提供坚实的技术支撑。
衍生相关工作
该数据集的发布直接催生了一系列后续研究与实践。其源数据源于 Ghana Speech 与 Ghana English TTS Filtered 项目,而预计算潜在表示的方式启发了针对其他低资源语言(如斯瓦希里语、豪萨语)的类似数据构建工作。在模型层面,基于此数据集微调的 VoxCPM Ghana 模型成为多语言 TTS 领域的重要基线,促使学界进一步探索声学潜在表示与语言标签的交互机制,例如将语言标签嵌入 Transformer 解码器以增强韵律控制。此外,该数据集也推动了语音识别与合成联合训练的研究,因为相同的潜在特征空间可复用于 ASR 任务中的特征提取,为端到端的语音处理系统提供了跨任务共享的中间表示,拓展了语音基础模型在非洲语言场景下的应用边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

