sileod/mindgames
收藏资源简介:
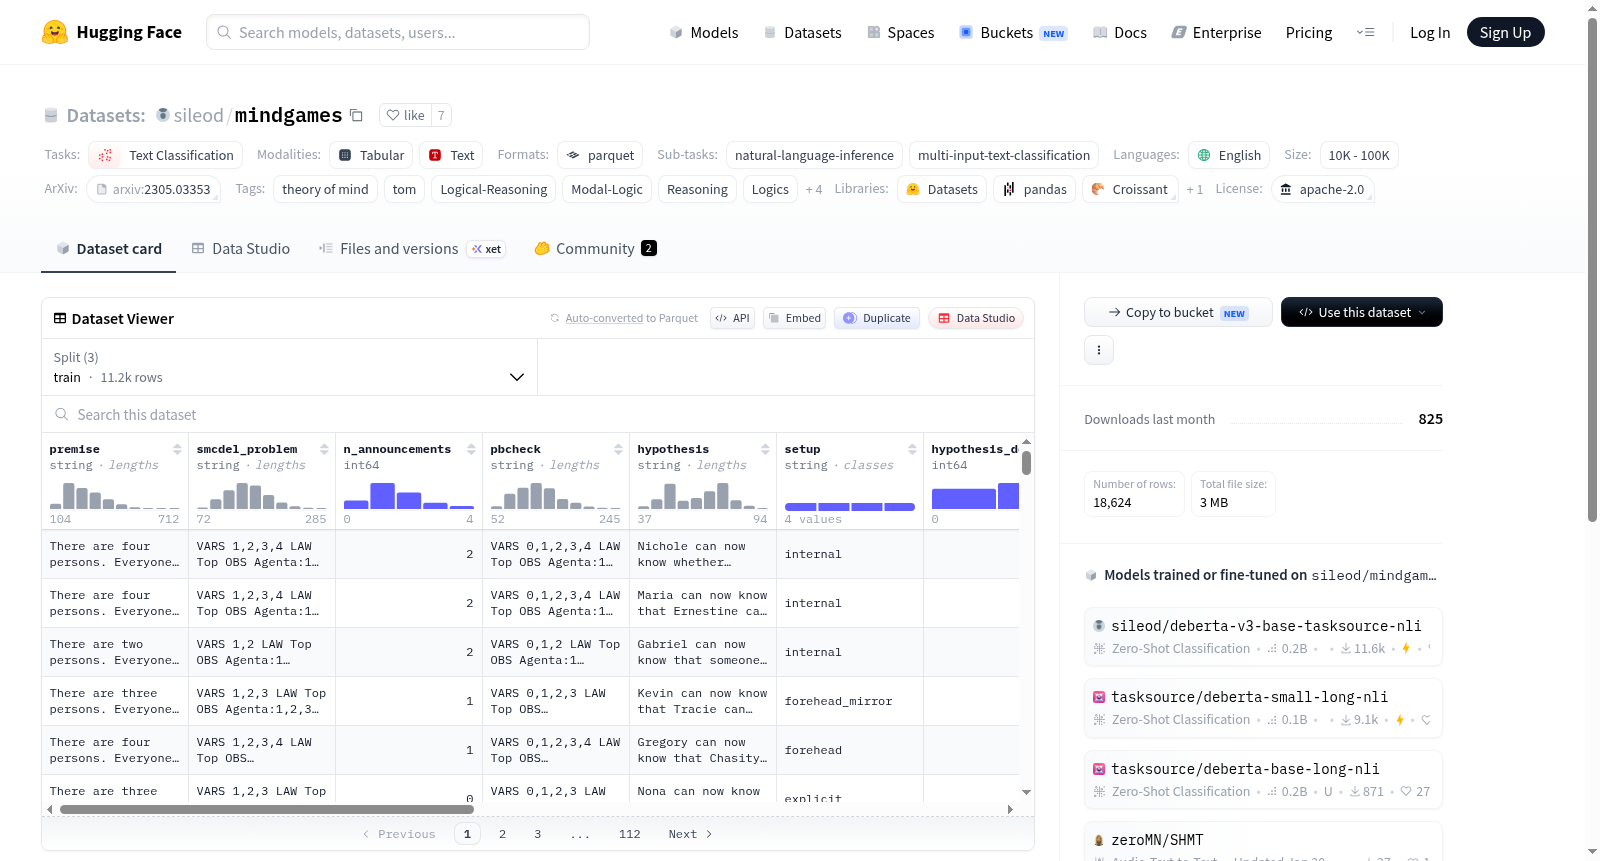
--- language: - en license: apache-2.0 multilinguality: - monolingual task_categories: - text-classification task_ids: - natural-language-inference - multi-input-text-classification tags: - theory of mind - tom - Logical-Reasoning - Modal-Logic - Reasoning - Logics - Logic - nli - model-checking - natural language inference dataset_info: features: - name: premise dtype: string - name: smcdel_problem dtype: string - name: n_announcements dtype: int64 - name: pbcheck dtype: string - name: hypothesis dtype: string - name: setup dtype: string - name: hypothesis_depth dtype: int64 - name: n_agents dtype: int64 - name: label dtype: string - name: names sequence: string - name: index dtype: int64 - name: s-l dtype: string - name: deberta_pred dtype: int64 - name: deberta_confidence dtype: float64 - name: difficulty dtype: float64 splits: - name: train num_bytes: 8702021 num_examples: 11174 - name: validation num_bytes: 2904084 num_examples: 3725 - name: test num_bytes: 2909341 num_examples: 3725 download_size: 2989857 dataset_size: 14515446 configs: - config_name: default data_files: - split: train path: data/train-* - split: validation path: data/validation-* - split: test path: data/test-* --- Mindgame dataset Code: https://github.com/sileod/llm-theory-of-mind Article (Accepted at EMNLP 2023 Findings): https://arxiv.org/abs/2305.03353 ``` @article{sileo2023mindgames, title={MindGames: Targeting Theory of Mind in Large Language Models with Dynamic Epistemic Modal Logic}, author={Sileo, Damien and Lernould, Antoine}, journal={arXiv preprint arXiv:2305.03353}, year={2023} } ```
语言: - 英语(en) 许可证:Apache-2.0 多语言属性: - 单语言 任务类别: - 文本分类 任务子类型: - 自然语言推理(natural-language-inference) - 多输入文本分类 标签: - 心理理论(theory of mind,ToM) - ToM - 逻辑推理(Logical-Reasoning) - 模态逻辑(Modal-Logic) - 推理(Reasoning) - 逻辑学(Logics) - 逻辑(Logic) - NLI(nli) - 模型检验(model-checking) - 自然语言推理(natural language inference) 数据集信息: 特征: - 名称:前提(premise),数据类型:字符串型 - 名称:smcdel_problem(smcdel问题),数据类型:字符串型 - 名称:n_announcements(公告数),数据类型:整型 - 名称:pbcheck,数据类型:字符串型 - 名称:hypothesis(假设),数据类型:字符串型 - 名称:setup(场景设定),数据类型:字符串型 - 名称:hypothesis_depth(假设深度),数据类型:整型 - 名称:n_agents(智能体数),数据类型:整型 - 名称:label(标签),数据类型:字符串型 - 名称:names(名称列表),数据类型:字符串序列型 - 名称:index(索引),数据类型:整型 - 名称:s-l,数据类型:字符串型 - 名称:deberta_pred(DeBERTa预测结果),数据类型:整型 - 名称:deberta_confidence(DeBERTa置信度),数据类型:浮点型 - 名称:difficulty(难度),数据类型:浮点型 数据集划分: - 名称:训练集(train),字节数:8702021,样本数:11174 - 名称:验证集(validation),字节数:2904084,样本数:3725 - 名称:测试集(test),字节数:2909341,样本数:3725 下载大小:2989857字节 数据集总大小:14515446字节 配置项: - 配置名称:默认(default),数据文件: - 训练集:对应路径data/train-* - 验证集:对应路径data/validation-* - 测试集:对应路径data/test-* 心理游戏(MindGames)数据集 代码仓库:https://github.com/sileod/llm-theory-of-mind 已被EMNLP 2023发现论文(Findings of EMNLP 2023)接收的学术论文:https://arxiv.org/abs/2305.03353 引用格式: @article{sileo2023mindgames, title={MindGames: Targeting Theory of Mind in Large Language Models with Dynamic Epistemic Modal Logic}, author={Sileo, Damien and Lernould, Antoine}, journal={arXiv preprint arXiv:2305.03353}, year={2023} }
数据集概述
基本信息
- 语言: 英语
- 许可证: Apache-2.0
- 多语言性: 单语
- 任务类别: 文本分类
- 任务ID:
- 自然语言推理
- 多输入文本分类
- 标签:
- 理论思维
- 逻辑推理
- 模态逻辑
- 推理
- 逻辑
- 自然语言推理
- 模型检查
数据集特征
- premise: 字符串
- smcdel_problem: 字符串
- n_announcements: 整数
- pbcheck: 字符串
- hypothesis: 字符串
- setup: 字符串
- hypothesis_depth: 整数
- n_agents: 整数
- label: 字符串
- names: 字符串序列
- index: 整数
- s-l: 字符串
- deberta_pred: 整数
- deberta_confidence: 浮点数
- difficulty: 浮点数
数据集分割
- 训练集:
- 字节数: 8702021
- 示例数: 11174
- 验证集:
- 字节数: 2904084
- 示例数: 3725
- 测试集:
- 字节数: 2909341
- 示例数: 3725
数据集大小
- 下载大小: 2989857
- 数据集大小: 14515446
配置
- 默认配置:
- 训练数据路径: data/train-*
- 验证数据路径: data/validation-*
- 测试数据路径: data/test-*