
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-8B_strategy_trust_t0.75_g10_run1
收藏数据链接:
官方服务:
资源简介:
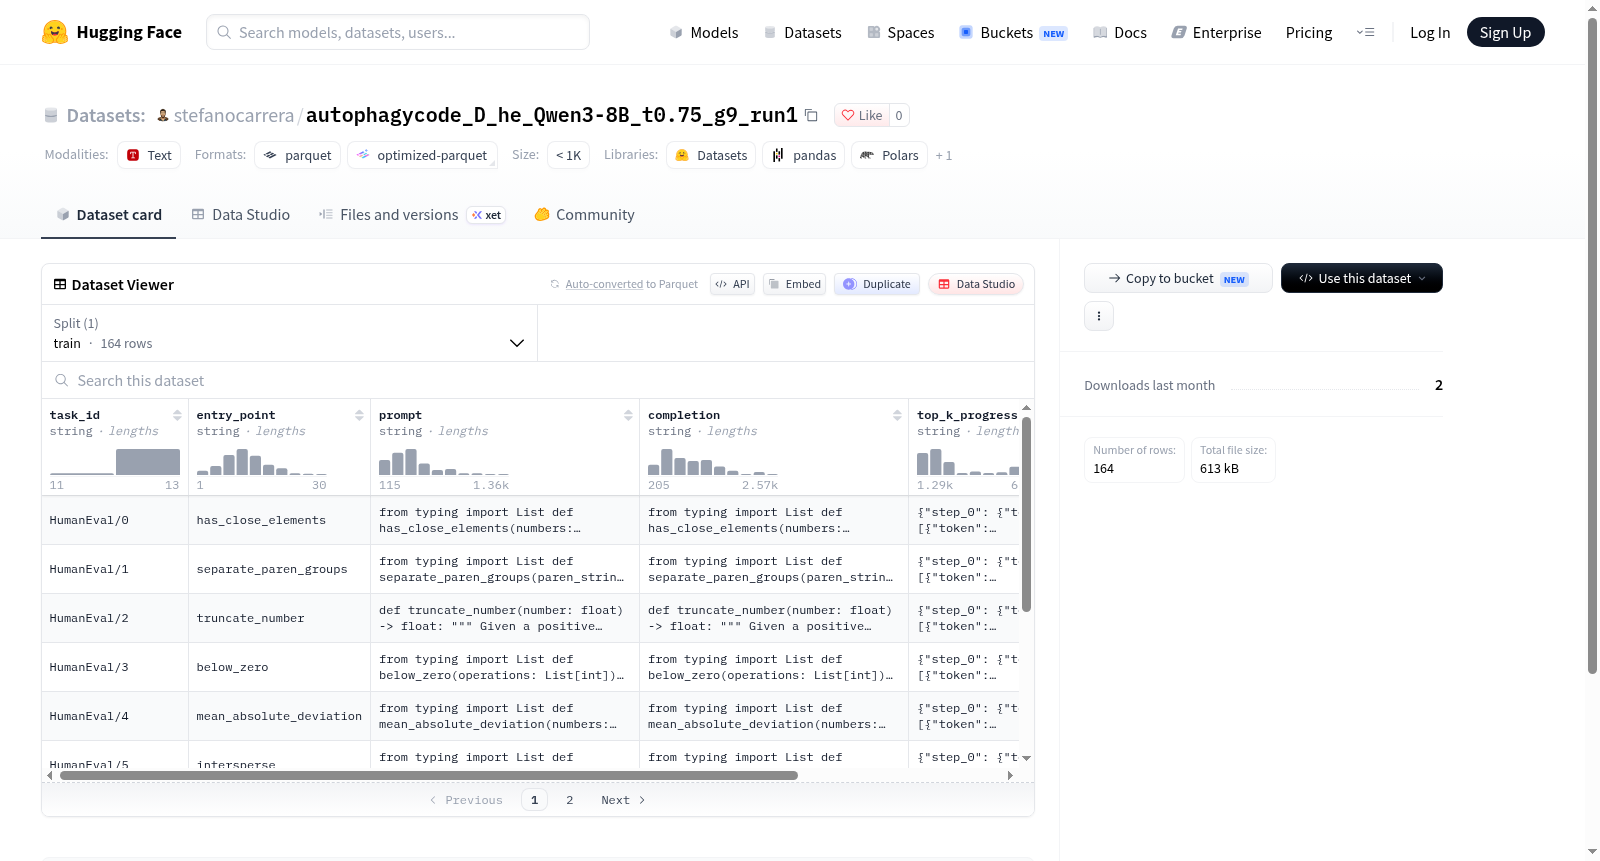
--- dataset_info: features: - name: task_id dtype: string - name: entry_point dtype: string - name: prompt dtype: string - name: completion dtype: string - name: top_k_progression dtype: string - name: test dtype: string splits: - name: train num_bytes: 5185199 num_examples: 164 download_size: 609762 dataset_size: 5185199 configs: - config_name: default data_files: - split: train path: data/train-* ---
This dataset contains 164 training examples, each with 6 string features: task_id, entry_point, prompt, completion, top_k_progression, and test, designed to support the analysis and processing of related tasks.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集立足于程序合成与自动化代码生成的研究背景,旨在为评估大语言模型在代码生成任务中的表现提供训练资源。其构建过程依托于Qwen3-8B模型,采用一种名为“trust”的策略,在温度系数设为0.75、分组数为10的条件下执行第一轮运行(run1),由此生成模型输出。数据集包含task_id、entry_point、prompt、completion、top_k_progression和test六个字段,涵盖164个训练样本,总大小约5.18MB,以parquet格式存储,便于高效加载与处理。
特点
该数据集的核心特征在于其生成过程具备明确的策略标识与超参数记录,使得数据可追溯且实验可复现。prompt与completion字段分别对应代码生成任务的输入描述与模型输出,top_k_progression字段可能记录了生成过程中候选答案的演化信息,test字段则提供测试用例以验证生成代码的功能正确性。数据集规模适中,专注于代码生成领域,适合用于分析模型在特定解码策略下的行为模式与输出质量。
使用方法
使用者可通过Hugging Face的datasets库直接加载该数据集,默认配置下自动获取train划分。加载后,可依据task_id与entry_point定位具体编程任务,利用prompt与completion进行监督微调或生成质量评估,借助test字段执行单元测试以验证代码正确性,top_k_progression则可用于分析生成多样性或解码路径。该数据集适用于代码生成模型的训练、评测及解码策略的对比研究。
背景与挑战
背景概述
该数据集聚焦于代码生成领域,旨在通过提示与补全的配对数据评估模型在编程任务上的表现。其名称中的策略标记暗示了数据生成过程融入了特定采样策略,可能涉及自回归生成中的温度参数与候选筛选机制。数据集包含任务标识、入口点、提示、补全、top-k演进轨迹及测试用例等字段,结构设计反映了对生成过程动态性与结果正确性的双重关注。该数据集或由关注代码大模型评估的研究者构建,试图在有限样本下揭示模型在代码合成任务中的行为模式,为后续代码智能研究提供细粒度分析基础。
当前挑战
所解决的领域问题——代码生成,面临语义正确性与执行效率的双重考验,模型需在多样化的编程语境中生成逻辑严密的代码片段。构建过程中,如何设计有效的提示与测试用例以覆盖真实编程场景,同时确保top-k演进轨迹能够准确反映模型决策路径,是主要难点。此外,受限于样本规模,数据集的泛化能力与统计显著性亦构成挑战,需在后续研究中通过扩展与验证加以完善。
常用场景
经典使用场景
在程序合成与自动化代码生成的学术探索中,该数据集通常被用于评估大语言模型在复杂编程任务上的推理与生成能力。其任务形式要求模型根据自然语言描述和入口点函数,生成满足测试用例的完整代码实现,并通过top_k_progression字段记录解码过程中候选代码的通过率变化。这一设计使得研究者能够细致观察模型在逐步生成代码时的搜索效率与正确性演化,成为衡量模型代码理解与逻辑构建能力的经典基准。
解决学术问题
该数据集主要回应了代码生成研究中模型输出多样性难以量化、搜索策略效果缺乏细粒度评估的问题。通过提供每个任务的多个候选生成序列及其通过测试的比例,它使研究者能够分析不同解码策略(如温度采样、核采样)对代码正确率的影响,并探讨模型在困难任务上的失败模式。其意义在于推动了代码生成评估从单一准确率向过程性、可解释性指标的转变,为改进训练与推理算法提供了实证依据。
衍生相关工作
基于该数据集的结构与任务设计,后续研究衍生出若干经典工作,例如针对代码生成中搜索策略的对比分析、基于执行反馈的强化学习微调方法,以及利用top_k_progression信息进行生成过程可视化的可解释性研究。这些工作进一步拓展了数据集在代码大模型评估与优化中的应用边界,并启发了更多关注生成过程而非仅关注最终结果的基准构建。
以上内容由遇见数据集搜集并总结生成


