
smartgmin/enter1
收藏官方服务:
资源简介:
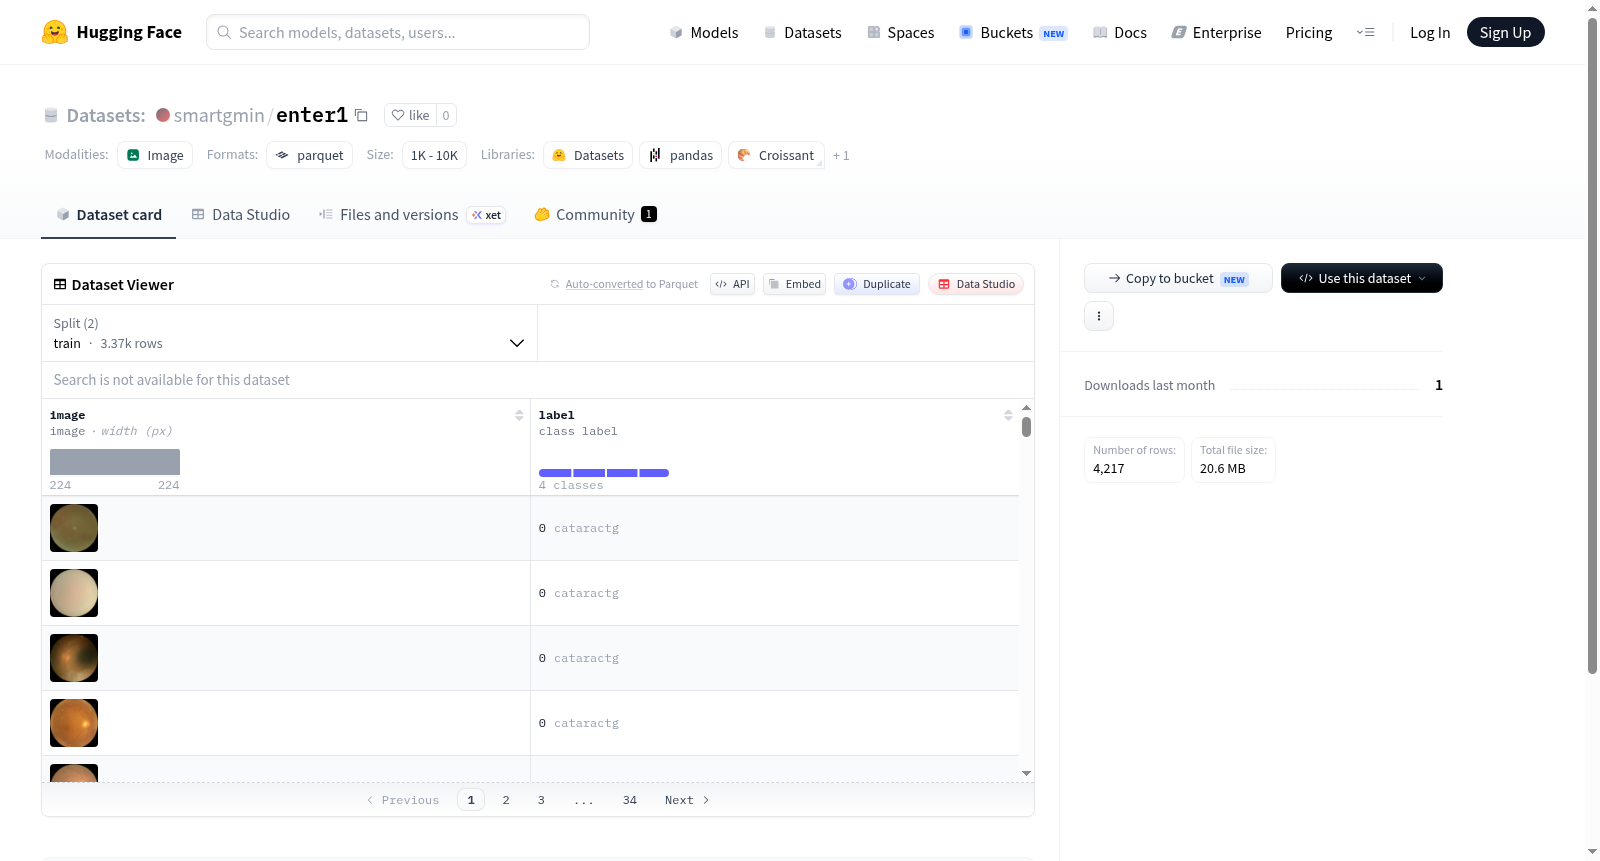
该数据集包含图像和标签两个主要特征。图像特征的数据类型为image,标签特征的数据类型为class_label,具体包括四种类别:白内障、糖尿病视网膜病变、青光眼和正常。数据集分为训练集和测试集,训练集包含3372个样本,测试集包含845个样本。数据集的总下载大小为20551256字节,总数据集大小为19676845.351999998字节。
The dataset contains two main features: image and label. The image feature is of type image, and the label feature is of type class_label, specifically including four categories: cataractg, diabetic_retinopathy, glaucoma, and normal. The dataset is divided into a training set and a test set, with the training set containing 3372 samples and the test set containing 845 samples. The total download size of the dataset is 20551256 bytes, and the total dataset size is 19676845.351999998 bytes.
提供机构:
smartgmin原始信息汇总
数据集概述
特征
- image: 图像数据
- label: 分类标签
- 类别名称:
- 0: cataractg
- 1: diabetic_retinopathy
- 2: glaucoma
- 3: normal
- 类别名称:
数据集划分
- train:
- 样本数量: 3372
- 数据大小: 15375081.352 字节
- test:
- 样本数量: 845
- 数据大小: 4301764.0 字节
数据集大小
- 下载大小: 20551256 字节
- 数据集总大小: 19676845.351999998 字节
配置
- default:
- 数据文件路径:
- train: data/train-*
- test: data/test-*
- 数据文件路径:
搜集汇总
数据集介绍
构建方式
在眼科医学影像分析领域,高质量标注数据集是推动智能诊断模型发展的关键基石。smartgmin/enter1数据集专为眼部疾病分类任务而构建,其数据来源涵盖了白内障、糖尿病视网膜病变、青光眼及正常眼底图像四大类别。该数据集采用经典的训练-测试划分策略,其中训练集包含3372个样本,测试集包含845个样本,确保了模型训练与评估的独立性。所有图像均以统一的image格式存储,并配以由class_label定义的精确标签,为监督学习提供了标准化的输入输出对。
特点
该数据集最显著的特征在于其类别均衡性与医学专业性的结合。四类眼部疾病——白内障(cataractg)、糖尿病视网膜病变(diabetic_retinopathy)、青光眼(glaucoma)以及正常眼底(normal)——均被清晰标注,覆盖了临床常见的致盲性眼病。数据集的规模虽适中,但训练集与测试集的比例约为4:1,既保证了模型有足够的样本学习特征,又为性能评估保留了独立的数据空间。此外,所有图像均为原始医学影像,保留了诊断所需的纹理与结构细节,适用于深度学习模型的迁移学习与微调。
使用方法
使用该数据集时,研究者可通过HuggingFace的datasets库直接加载,指定config_name为'default'即可自动获取训练与测试分片。图像数据以image类型加载,便于与PyTorch或TensorFlow等框架无缝集成。标签字段为整数编码,映射至cataractg、diabetic_retinopathy、glaucoma、normal四类,可直接用于多分类损失函数的计算。为提升模型泛化能力,建议在训练前对图像进行归一化、随机裁剪与水平翻转等预处理操作。测试集则用于最终评估,可计算准确率、召回率及F1分数等指标,以全面衡量模型在眼部疾病诊断任务上的表现。
背景与挑战
背景概述
眼科疾病是全球范围内导致视力丧失的主要原因之一,其中白内障、糖尿病视网膜病变和青光眼等常见眼病若未及时诊治,可能造成不可逆的视力损害。smartgmin/enter1数据集由相关研究团队构建,旨在通过深度学习技术辅助眼科疾病的自动诊断。该数据集涵盖四种分类:白内障、糖尿病视网膜病变、青光眼以及正常眼底图像,共包含3372张训练样本和845张测试样本。数据集的创建聚焦于解决眼底图像多分类问题,为眼科疾病筛查提供了标准化的数据基础,对推动医学影像分析在临床诊断中的应用具有重要价值。
当前挑战
当前数据集面临的核心挑战在于多类别眼病分类的精准性与鲁棒性。首先,不同眼科疾病在眼底图像中的表现可能存在相似特征,如糖尿病视网膜病变与青光眼早期病变的视觉重叠,增加了模型区分的难度。其次,数据集规模相对有限(仅4217张图像),可能无法充分覆盖不同病程阶段、光照条件及设备差异下的图像变异,导致模型泛化能力不足。此外,构建过程中需确保标注的准确性,避免因医师主观差异引入标签噪声,同时平衡各类别样本数量以缓解类别不平衡问题,这些均为实际部署中的关键障碍。
常用场景
经典使用场景
在眼科医学影像分析领域,enter1数据集凭借其涵盖白内障、糖尿病视网膜病变、青光眼及正常眼底四大类别的精细标注,成为构建深度学习分类模型的经典基准资源。研究者常利用其3372张训练图像与845张测试图像,训练卷积神经网络或视觉Transformer架构,以实现对多种常见致盲性眼病的自动化筛查与鉴别诊断。该数据集通过提供标准化的图像尺寸与标签格式,为跨研究机构的算法性能对比提供了可靠平台,尤其适用于多分类任务中类别不平衡问题的探索与优化。
衍生相关工作
enter1数据集衍生了一系列经典工作,包括基于注意力机制的细粒度分类网络(如引入通道-空间双注意力模块以增强对微血管病变的敏感性),以及结合生成对抗网络进行数据增强以缓解类别不平衡的研究。此外,部分工作将其与OCT图像数据集联合使用,探索多模态融合诊断策略,或利用知识蒸馏技术压缩模型以适配移动端部署。这些衍生研究不仅拓展了数据集的应用边界,也为眼科AI领域的标准化评估树立了参照。
数据集最近研究
最新研究方向
在眼科人工智能诊断领域,smartgmin/enter1数据集聚焦于四种常见致盲性眼病——白内障、糖尿病视网膜病变、青光眼及正常眼底图像的分类研究。该数据集包含3372张训练样本和845张测试样本,为深度学习模型在眼底疾病多分类任务中提供了标准化基准。当前前沿方向集中于利用Vision Transformer与卷积神经网络融合架构提升细粒度病变识别精度,同时探索跨模态预训练策略以缓解标注数据稀缺问题。伴随全球老龄化加剧及糖尿病患病率攀升,此类数据集驱动的自动化筛查系统正成为基层医疗资源下沉的关键技术支撑,其研究意义在于推动眼科影像AI从实验室走向真实临床部署,实现低成本、高效率的疾病早期预警。
以上内容由遇见数据集搜集并总结生成


