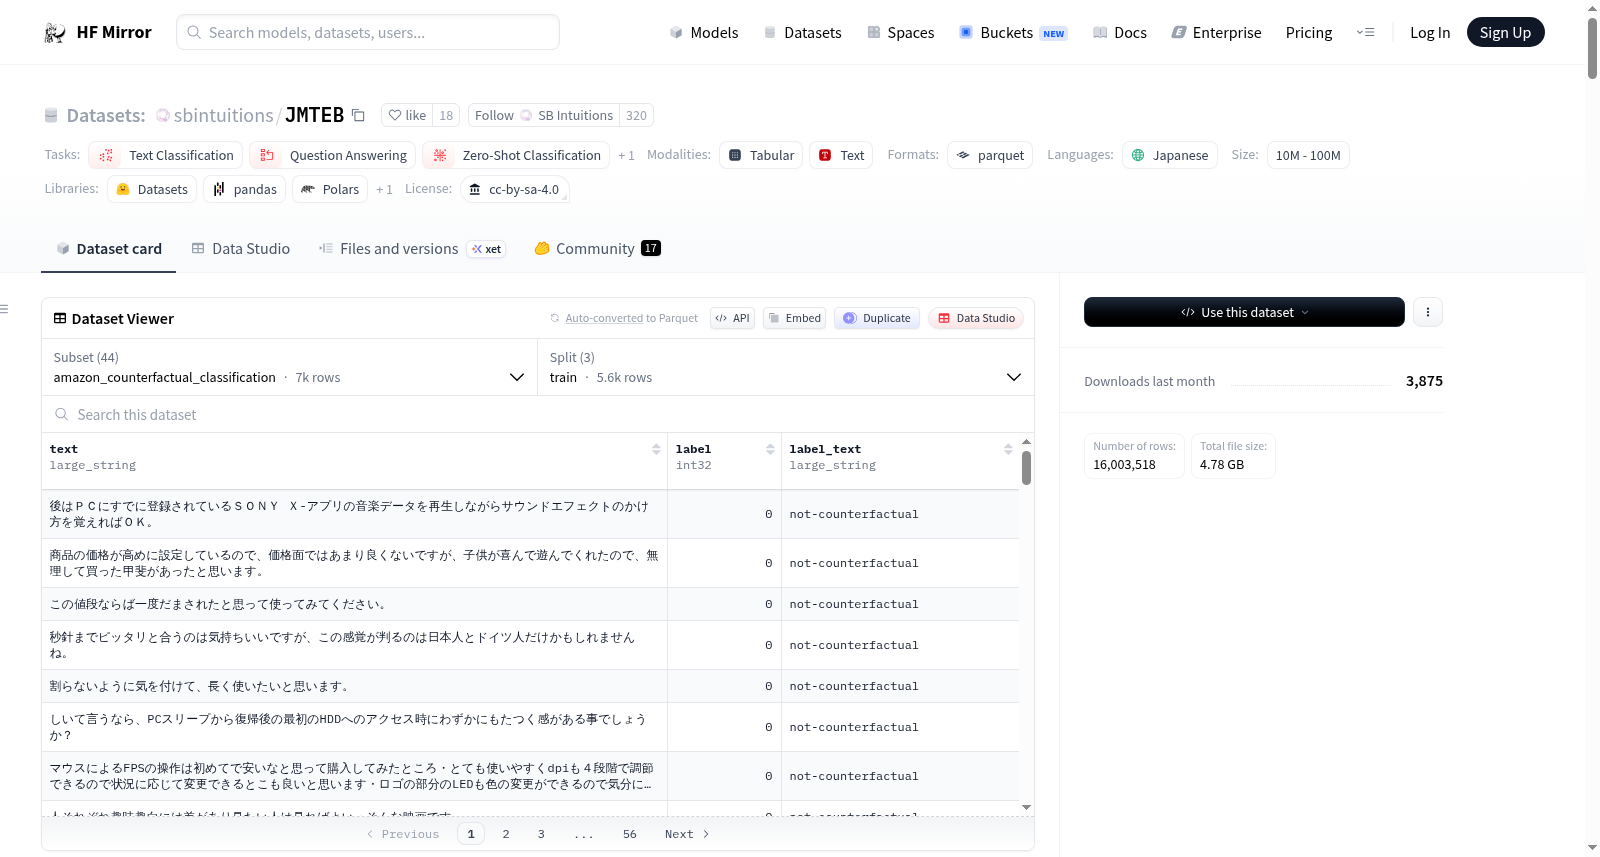
sbintuitions/JMTEB
收藏资源简介:
JMTEB(日语大规模文本嵌入基准)是一个用于评估日语文本嵌入模型的基准测试。它包含6个任务,涉及16个数据集。这些任务包括聚类、分类、语义文本相似性(STS)、配对分类、检索和重排序。每个任务都有相应的数据集,例如Livedoor News用于聚类任务,AmazonReviewClassification用于分类任务等。数据集旨在为日语嵌入模型提供多样化和可扩展的评估基准,从而促进更强大的模型的出现。
JMTEB (Japanese Massive Text Embedding Benchmark) is a benchmark for evaluating Japanese text embedding models. It consists of 6 tasks, involving 16 datasets in total. These tasks include Clustering, Classification, Semantic Textual Similarity (STS), PairClassification, Retrieval, and Reranking. Each task has corresponding datasets, such as Livedoor News for Clustering, AmazonReviewClassification for Classification, etc. The benchmark aims to provide a diverse and extensible evaluation framework for Japanese embedding models, facilitating the emergence of more powerful models.
数据集概述
数据集名称
- JMTEB: Japanese Massive Text Embedding Benchmark
数据集描述
- JMTEB 是一个用于评估日语文本嵌入模型的基准,包含6个任务,目前涉及16个数据集。
数据集任务
- 任务类别:
- 文本分类
- 问答
- 零样本分类
- 句子相似性
数据集语言
- 语言:日语(ja)
数据集大小
- 大小类别:100M<n<1B
数据集内容
- 任务与数据集概览:
- 分类任务:包括AmazonCounterfactualClassification、AmazonReviewClassification、MassiveIntentClassification、MassiveScenarioClassification等。
- 聚类任务:包括Livedoor-News、MewsC-16-ja等。
- STS任务:包括JSTS、JSICK等。
- PairClassification任务:包括PAWS-X-ja等。
- 检索任务:包括JAQKET、Mr.TyDi-ja、NLP Journal title-abs等。
- 重排序任务:包括Esci等。
数据集使用
- 加载数据集: python from datasets import load_dataset dataset = load_dataset("sbintuitions/JMTEB", name="<dataset_name>", split="<split>")
数据集许可证
- 许可证:CC-BY-SA-4.0
数据集贡献
- 贡献:鼓励感兴趣的人士贡献于此基准。