
遇见数据集

ServiceNow/Dr-CiK

收藏
Hugging Face2026-06-30 更新2026-07-22 收录
官方服务:

资源简介:

Dr-CiK是一个用于评估智能体能力的基准测试数据集,专注于时间序列预测任务。其核心目标是测试智能体是否能够从包含噪声的文档语料库中检索与预测相关的上下文信息,过滤掉干扰文档,将检索到的上下文提炼为可用于预测的证据,并基于这些证据生成预测。该数据集模拟了现实世界的时间序列预测场景,其中预测不仅依赖于历史观测数据,还需要从异构、嘈杂的信息源中主动发现外部上下文。与现有通常假设支持性上下文已提供的基准测试不同,Dr-CiK的每个任务都将一个时间序列与一个包含支持性文档和干扰文档的语料库配对,要求智能体自行寻找并使用正确的证据。数据集包含279个任务、10,342个文档(其中3,367个支持性文档,6,975个干扰文档),并分为公开开发集(199个合成任务)和隐藏测试集(80个人工编写任务)。每个任务涉及一个4跳推理链,干扰文档分为五种子类型:混淆型、噪声型、时间序列误导型、配置文件不匹配型和时序错误型。

Dr-CiK is a benchmark for evaluating whether agents can retrieve forecasting-relevant context from a noisy document corpus, filter out distractors, distill the retrieved context into forecast-useful evidence, and produce forecasts grounded in that evidence. It addresses real-world time-series forecasting scenarios where forecasting depends not only on historical observations but also on external context that must be actively discovered from heterogeneous, noisy information sources. Unlike existing context-aided forecasting benchmarks that typically assume supporting context is already provided, Dr-CiK removes that assumption: each task pairs a time series with a corpus of supporting and distractor documents, and the agent must find and use the right evidence on its own. The dataset includes 279 tasks, 10,342 documents (3,367 supporting, 6,975 distractor), split into a public dev set (199 synthetic tasks) and a hidden test set (80 human-authored tasks). Each task is built around a 4-hop reasoning chain, with distractor documents categorized into five subtypes: confounder, noisy, timeseries, profile, and temporal.
提供机构:
ServiceNow
搜集汇总
数据集介绍
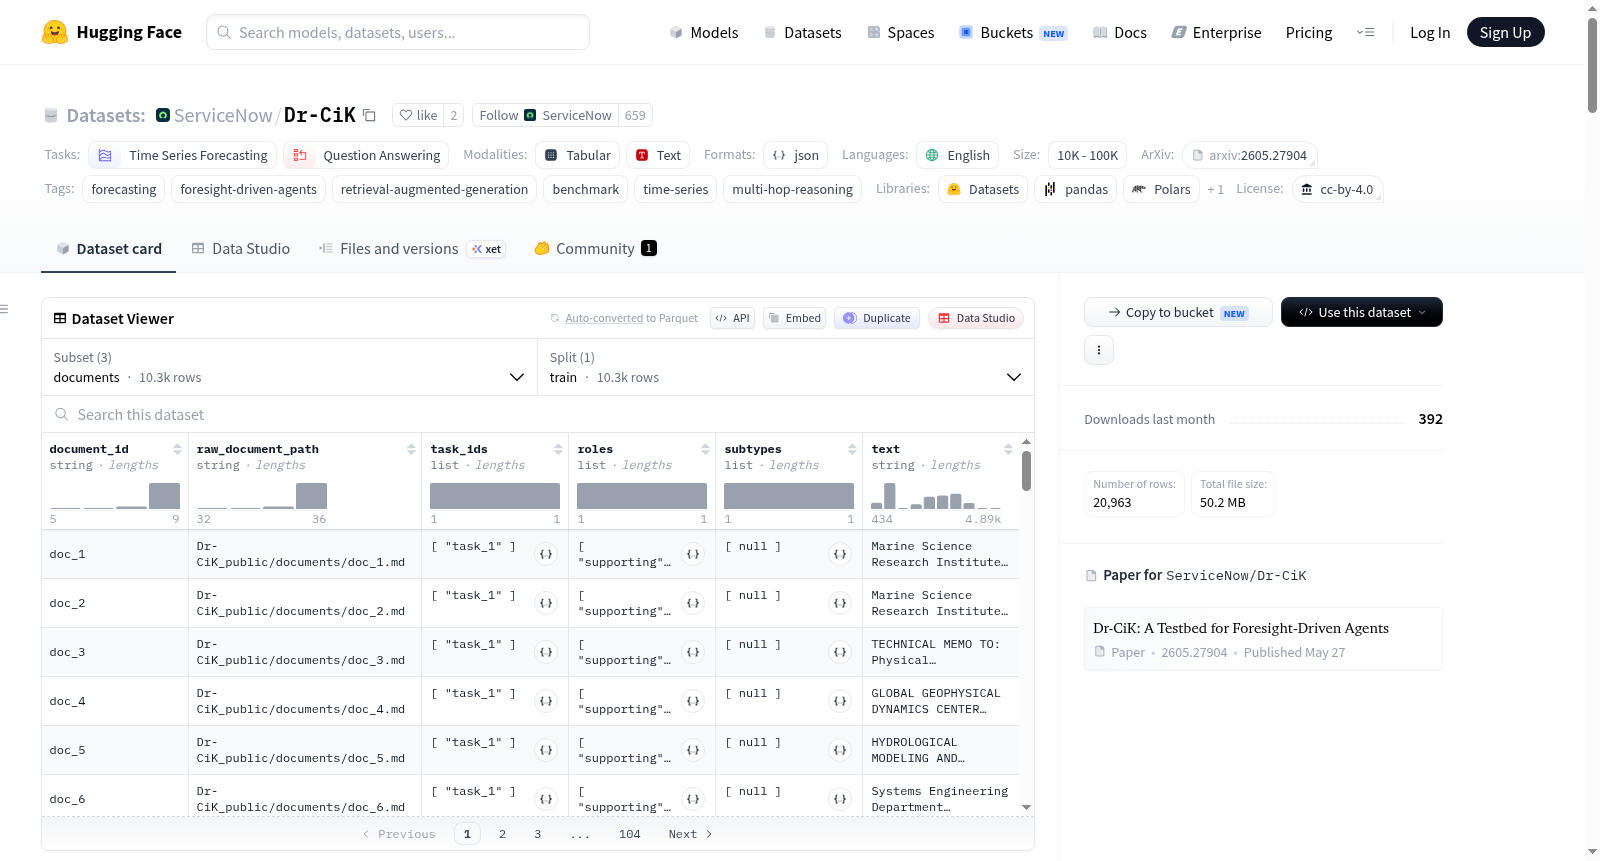
ServiceNow/Dr-CiK 数据集图片
构建方式
Dr-CiK由ServiceNow Research团队构建,旨在评估具备前瞻性驱动能力的智能体在复杂文档环境中进行时间序列预测的表现。该数据集以4跳推理链为核心,每个任务提供一段历史时间序列、目标实体元数据以及一个混合了支持性文档与干扰文档的语料库。其中,干扰文档细分为混淆因子、噪声、时间序列误述、实体属性不匹配和时序偏移五大子类型,每种类型包含1395篇,以系统性地测试智能体的抗干扰能力。199个任务源自CiK与GIFT-CTX基准,另外80个任务由人类专家撰写,从而确保了数据集的广度与真实性。
使用方法
研究者可通过Hugging Face的datasets库便捷加载Dr-CiK的三种配置:tasks提供任务级数据,documents包含所有文章的完整文本,task_documents则记录了任务与文档的关联关系。使用时,智能体需自主检索并过滤语料库中的干扰项,从中提炼出有助于预测的证据,最终输出未来时间序列的预测值。对于隐藏测试集,模型可正常运行但答案被保留,需提交至官方排行榜进行评测。数据集还提供了原始打包文件与重建脚本,支持用户按需定制数据格式,适配多种实验框架。
背景与挑战
背景概述
Dr-CiK数据集由ServiceNow Research团队于2026年创建,旨在解决现实世界时间序列预测中对外部上下文主动发现能力的评估缺失。传统上下文辅助预测基准通常预设支持性上下文已提供,而Dr-CiK通过引入嘈杂文档语料库,要求智能体自主检索、过滤、凝练证据并基于此进行预测。该数据集包含279个任务和超过10,000篇文档,覆盖合成与人工撰写的场景,为前驱驱动型智能体的研究提供了标准化测试平台,对提升大语言模型在复杂信息环境下的多跳推理与预测能力具有重要影响。
当前挑战
当前挑战集中于两大方面:领域问题层面,时间序列预测常需从多种异构信息源中主动发现关键上下文,但现有基准无法评估智能体在噪音环境中自主检索与拒斥干扰的能力;构建过程中,数据集需精心设计五类干扰文档(混淆因素、噪声、时间序列误导、画像错配、时间窗口错误),并确保每任务包含4跳推理链,同时维持合成任务与人工任务的平衡。此外,测试集标签的隐藏机制增加了评估的复杂性。
常用场景
经典使用场景
Dr-CiK作为一项面向前瞻性智能体的测试基准,最经典的使用场景在于评估具备深度研究能力的时序预测系统。该基准要求智能体从海量、异构且充满干扰的文档语料库中主动检索与预测任务密切相关的上下文,同时剔除大量精心设计的干扰文档。每个任务均围绕一条复杂的四跳推理链构建,智能体不仅需要准确提取支撑性证据,还必须将分散于多篇文档中的关键信息进行蒸馏整合,最终生成基于证据的稳健预测。这一设置精准还原了真实世界中预测必须依赖主动信息发现而非被动接收的复杂情境。
解决学术问题
该数据集从根本上解决了现有上下文辅助预测基准中假设支持信息已被预先提供的局限,将研究焦点从仅关注预测精度拓展至端到端的信息检索、证据蒸馏与抗干扰决策能力。它首次系统性地提出了包含混淆、噪声、时间序列误导、实体错配与时间窗口偏移五类干扰文档的分类学,为衡量智能体在面对复杂信息环境时的鲁棒性提供了标准化测试平台。通过揭示当前模型在深度融合多源异构证据与抵御精心设计干扰方面的显著不足,Dr-CiK推动了将检索增强生成、多跳推理与时序预测相融合的研究范式,对发展真正具备主动认知能力的预测智能体具有里程碑式的学术意义。
实际应用
在实际应用层面,Dr-CiK所模拟的场景与企业金融趋势分析、供应链风险预警、宏观经济指标预判等高度契合。例如,在金融领域,分析师需要从海量的财报、新闻、政策文件中提取影响特定公司股价的关键信息,同时辨别噪音和市场谣言。该数据集的评估框架可直接用于构建新一代智能金融助手,使其具备自主搜集证据、过滤虚假信息并给出有据可依的市场预测的能力。在医疗健康领域,这种面向预测的深度研究能力也可应用于疫情传播态势研判,从繁杂的流行病学报告、政府公告和社交媒介信息中提炼关键暴露因素,辅助公共卫生决策。
数据集最近研究
最新研究方向
Dr-CiK数据集聚焦于时间序列预测的前瞻性智能体评估,开创性地将检索增强生成与多跳推理结合,模拟真实世界中从嘈杂文档语料库自主发现并提炼预测证据的复杂过程。该基准的突破性在于设计了五类干扰项(混淆因子、噪声内容、误导性时间序列、错误实体描述、时序错位信息),要求模型兼具深度检索与抗干扰能力。当前前沿研究围绕该数据集展开的焦点包括:开发能同时处理历史观测与外部异构信息的预训练语言模型框架,探索大语言模型在金融、供应链等动态场景中的深度研究能力,以及构建可解释的推理链证据追踪机制。Dr-CiK的发布标志着时间序列预测从纯统计方法向智能体驱动的因果推理范式转变,为评估AI系统在信息迷雾环境中做出负责任预测提供了标准化测试床。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

