
遇见数据集

lmarena-ai/Arena-T2I-Hard

收藏
Hugging Face2026-07-02 更新2026-07-22 收录
官方服务:

资源简介:

Arena-T2I-Hard是一个包含310个提示的压力测试基准,用于评估文本到图像模型的忠实度(即提示跟随能力)。数据来源于真实且困难的用户请求,这些请求通常包含长文本、多实体、属性、空间关系、计数和风格约束。每个提示都被预先分解为依赖感知的有向无环图(DAG)的是/否问题,当评估图像时,如果父问题失败,则其子问题的得分将被清零。该基准在DPG-Bench和DSG等基准饱和时仍能保持区分性。数据集包括约13.9k个问题,其中约9.6k个为忠实度问题,约4.4k个为美学问题。

Arena-T2I-Hard is a 310-prompt stress benchmark for evaluating faithfulness (prompt-following) of text-to-image models, drawn from real, hard arena user requests — long, multi-entity prompts with attributes, spatial relations, counts, and stylistic constraints. Each prompt ships pre-decomposed into a dependency-aware DAG of yes/no questions; when scoring an image, failing a parent question zeroes out its descendants. The benchmark stays discriminative where DPG-Bench and DSG saturate. Across the 310 prompts there are ~13.9k questions (~9.6k faithfulness, ~4.4k aesthetics).
提供机构:
lmarena-ai
搜集汇总
数据集介绍
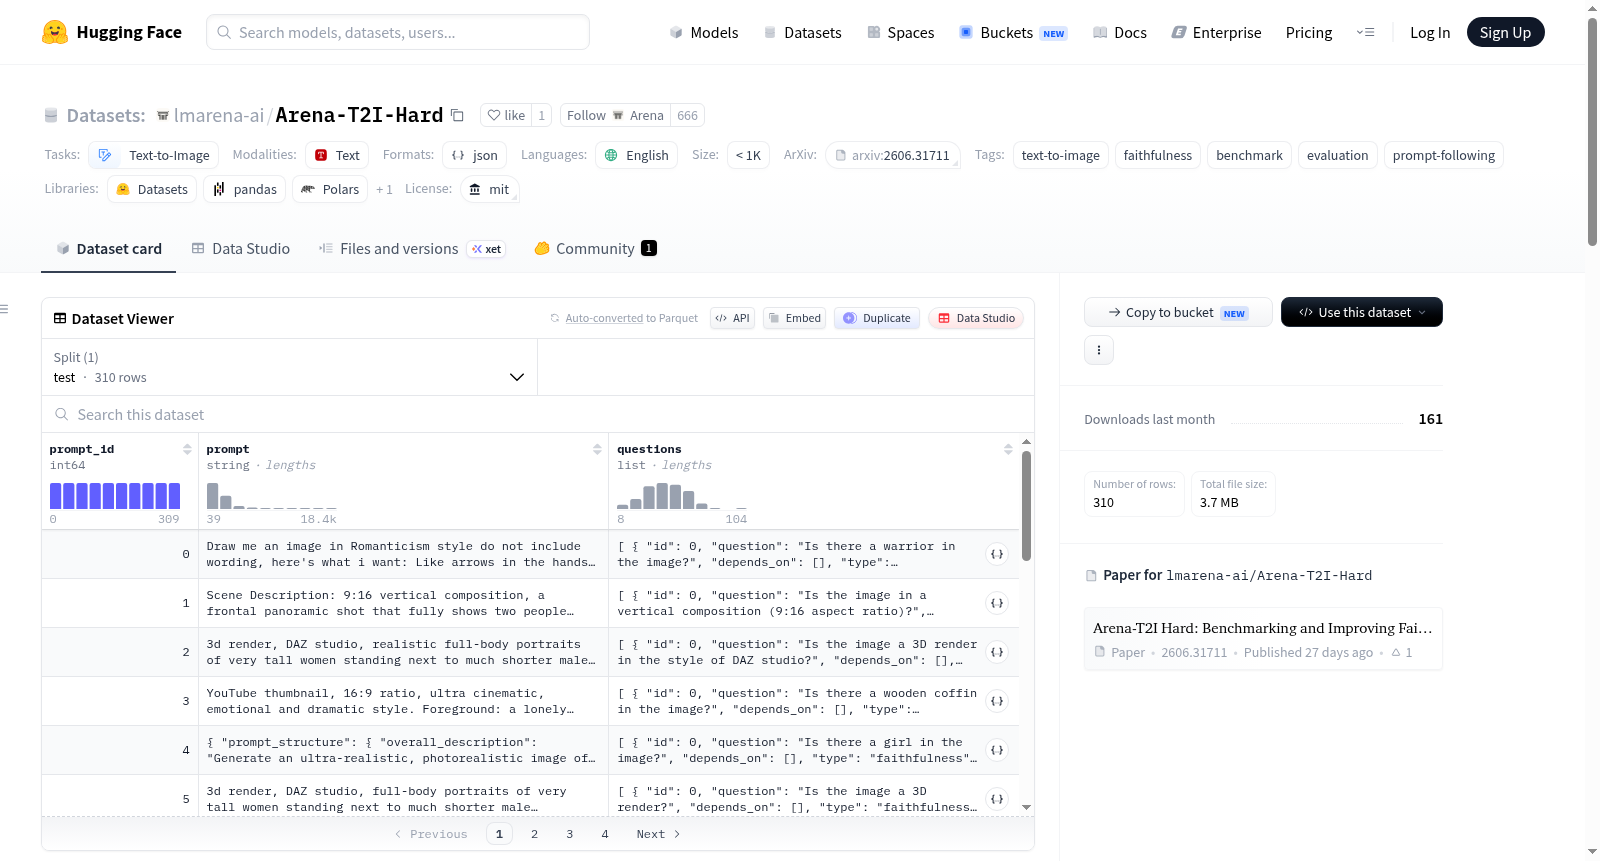
lmarena-ai/Arena-T2I-Hard 数据集图片
构建方式
Arena-T2I-Hard是一个专注于评估文本到图像模型忠实度的压力测试基准,其构建过程基于从真实竞技场用户请求中筛选出的310条高难度提示。这些提示以长文本、多实体为特征,涵盖属性、空间关系、计数和风格约束等复杂要素。每个提示被预先解构为一张依赖感知的有向无环图(DAG),图中包含一系列是非问题,问题间存在层级依赖关系——若父问题失败,其所有子问题的得分将被归零,从而确保评估的逻辑严密性。
使用方法
使用Arena-T2I-Hard进行模型评估时,研究者可通过HuggingFace Datasets库加载测试集,并获取每条提示及其对应的依赖式问题列表。具体操作中,需先利用模型为这310条提示生成图像,随后运行官方提供的评估代码,该代码会依据DAG结构对生成图像进行逐项检查并计算忠实度得分。数据集的原始JSON文件也可通过HuggingFace Hub直接下载,便于灵活集成至自定义评估流程。
背景与挑战
背景概述
文本到图像生成领域近年来取得了显著进展,但模型对复杂指令的忠实遵循能力(faithfulness)仍是评估中的核心挑战。为应对这一问题,Arena-T2I-Hard数据集由Yuanhao Ban、Tong Xie等研究人员于2026年提出,源自真实用户对图像生成竞技场(Arena)中的困难请求。该数据集包含310条精心设计的提示,每条提示均为长句且涉及多实体、属性、空间关系、数量及风格约束等复杂要素。研究团队引入了依赖感知的有向无环图(DAG)结构,将每个提示分解为若干是非问题,并依据依赖关系进行评分,从而实现对模型提示遵循能力的精细化评估。该数据集旨在填补现有评测基准(如DPG-Bench、DSG)在高难度场景下的饱和度问题,推动文本到图像生成模型忠实度研究的发展。
当前挑战
该数据集所解决的领域问题核心在于文本到图像模型面对复杂多约束指令时的忠实度不足。现有评测基准在高难度提示下已趋于饱和,难以有效区分不同模型的真实能力差距。构建过程中面临的主要挑战包括:如何从海量用户请求中筛选出既具挑战性又真实反映模型缺陷的提示;如何设计合理的依赖感知问题结构,使得大规模自动化评测既准确又高效;以及如何确保问题类型(忠实度与美学)的平衡,从而避免评测偏倚。此外,依赖关系的定义与父子问题间的评分机制需要精细设计,以真实反映模型在逐步满足提示要求过程中的能力边界。
常用场景
经典使用场景
Arena-T2I-Hard是一个专为评估文本到图像生成模型忠实度而设计的压力测试基准,包含310条来自真实用户请求的复杂提示。每条提示均预分解为依赖感知的有向无环图式是非题,用于系统性地检验模型对多实体、属性关系、空间布局、数量约束及风格限制等复杂指令的跟随能力。该基准最经典的使用场景是对现有文本到图像模型在忠实度维度上进行细粒度评测,尤其适用于那些在DPG-Bench和DSG等传统基准上已趋于饱和的高性能模型,通过更具挑战性的提示设计拉开模型间的性能差距。
解决学术问题
该数据集有效解决了学术界长期存在的文本到图像模型忠实度量化难题,尤其是在处理包含多重约束和层级依赖关系的复杂提示时,传统单一指标往往难以区分模型的真实跟随能力。通过引入依赖感知的评分机制,Arena-T2I-Hard能够精准诊断模型在属性绑定、计数准确性和空间关系等子任务上的具体缺陷。其意义在于为忠实度研究提供了具有高区分度的标准化评测平台,推动了从简单语义匹配向结构化指令理解的学术转向,并促使研究者重新审视和优化提示跟随中的因果依赖建模问题。
实际应用
在实际应用中,Arena-T2I-Hard主要用于评测和筛选适用于高精度创意场景的文本到图像生成模型,例如广告设计、影视分镜、游戏概念图生成等领域,这些场景对指令的精确执行要求苛刻。开发团队可利用该基准对模型进行迭代优化,识别并改进其在多实体布局、属性一致性等方面的薄弱环节。此外,该数据集也可作为自动化质量保证工具,服务于内容生成平台,为终端用户提供更忠实于原始创意的图像产出,减少因模型误解指令而产生的反复修改成本。
数据集最近研究
最新研究方向
随着文本到图像生成技术的迅猛发展,模型对复杂长文本提示的忠实遵循能力成为评估其性能的关键瓶颈。Arena-T2I-Hard基准数据集应运而生,它从真实用户的高难度请求中精选310个提示,覆盖多实体、属性、空间关系及数量约束等复杂场景,并创新性地引入依赖感知的有向无环图(DAG)问题分解机制,将忠实度评估转化为层级化的是非问答任务。这一设计有效解决了DPG-Bench和DSG等现有基准在高难度提示上的饱和效应,为模型在忠实度维度的精细化评测提供了更具区分度的工具。该数据集的发布不仅推动了文本到图像模型在复杂指令遵循能力上的深入研究,也为未来多模态生成系统的鲁棒性评估树立了新的标杆。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

