multidomain-kazakh-dataset
收藏资源简介:
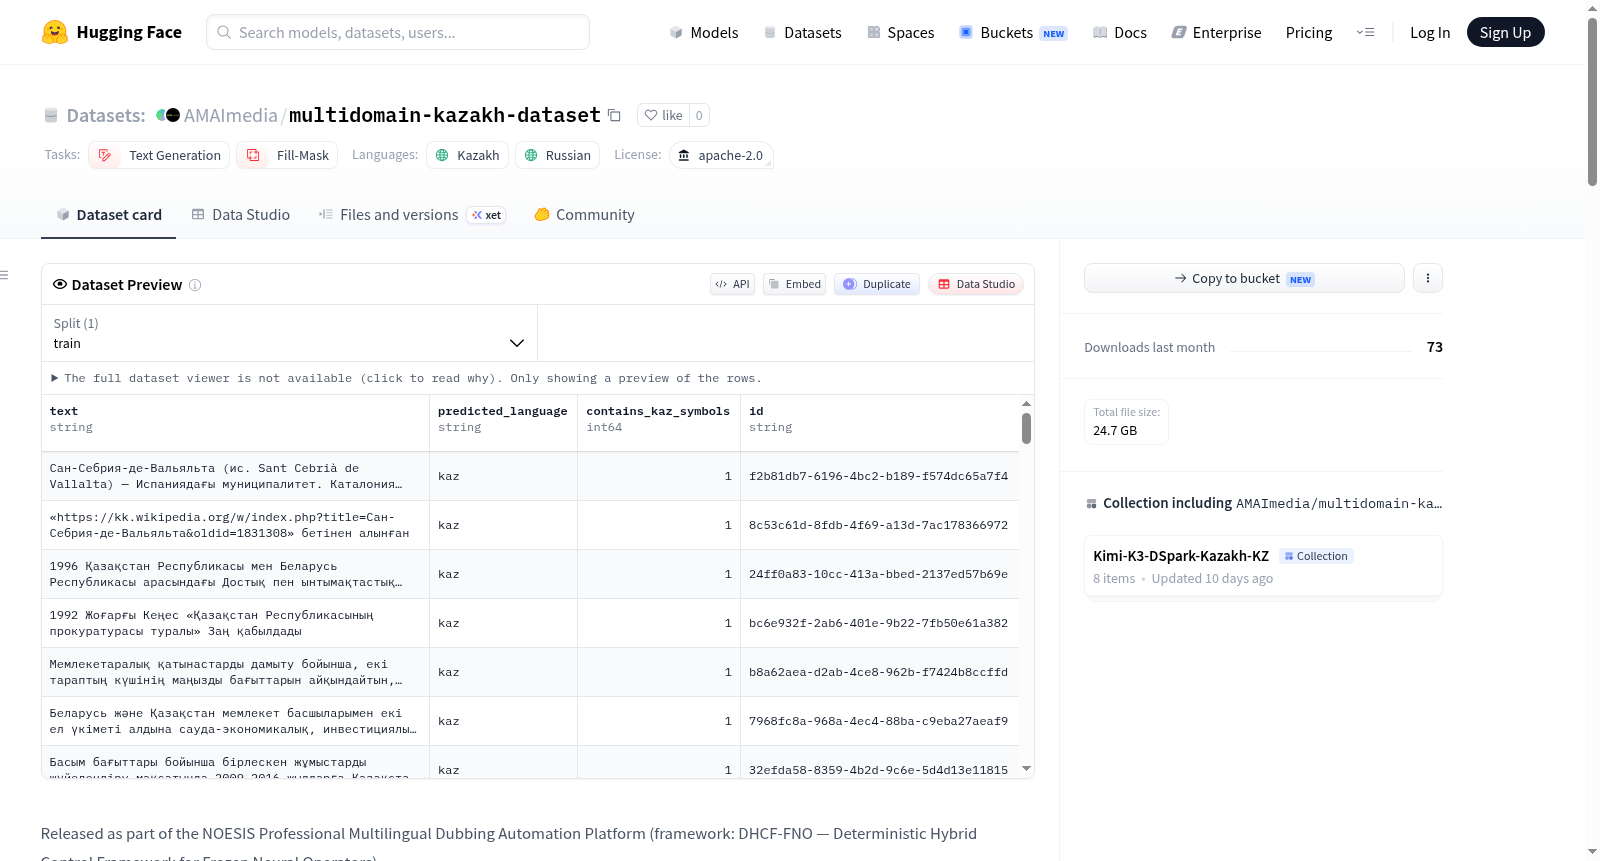
MDBKD(多领域双语哈萨克语数据集)是一个包含约 24,883,808 个独特文本的哈萨克语数据集,涵盖多个领域。该数据集主要用于因果语言建模和掩码语言建模任务。数据实例包含文本内容、预测语言标签、是否包含哈萨克语符号标志以及唯一标识符。数据集由五个子集组成:cc100-monolingual-crawled-data(维基百科文章)、kazakhBooks(书籍)、leipzig(文章/新闻)、oscar(CommonCrawl)和kazakhNews(新闻)。总文本数约 2488 万,总 token 数约 20.9 亿,唯一 token 数约 1780 万,完整数据集大小为 25GB。数据集不包含额外标注,未进行匿名化处理,可能包含个人姓名。该数据集旨在整理哈萨克语开源数据集,用于进一步研究和商业用途。许可证为 Apache-2.0。
MDBKD (Multi-domain Bilingual Kazakh Dataset) is a Kazakh dataset containing approximately 24,883,808 unique texts, covering multiple domains. It is mainly used for causal language modeling and masked language modeling tasks. Data instances include text content, predicted language label, whether it contains Kazakh script flag, and unique identifier. The dataset consists of five subsets: cc100-monolingual-crawled-data (Wikipedia articles), kazakhBooks (books), leipzig (articles/news), oscar (CommonCrawl) and kazakhNews (news). The total number of texts is about 24.88 million, total tokens about 2.09 billion, unique tokens about 17.8 million, and the full dataset size is 25GB. The dataset does not include additional annotations, has not been anonymized, and may contain personal names. It aims to compile Kazakh open-source datasets for further research and commercial use. The license is Apache-2.0.
MDBKD | Multi-Domain Bilingual Kazakh Dataset
数据集概述
MDBKD是一个多领域双语哈萨克语数据集,包含24,883,808条独特文本,覆盖多个领域。该数据集作为NOESIS专业多语言配音自动化平台的一部分发布,采用Apache-2.0许可证。
数据规模与统计
- 总文本数:24,883,808条
- 总词元数:2,091,564,186个
- 唯一词元数:17,802,998个
- 数据集大小:25GB
数据划分
数据集包含5个划分,统计如下:
| 数据划分 | 领域 | 文本数量 | 词元数量 | 唯一词元数 | 文本中位词元数 |
|---|---|---|---|---|---|
| cc100-monolingual-crawled-data | Wikipedia文章 | 19,635,580 | 441,623,321 | 6,217,337 | 12 |
| kazakhBooks | 书籍 | 8,423 | 351,433,586 | 7,245,720 | 40,264 |
| leipzig | 文章/新闻 | 1,706,485 | 26,494,864 | 1,109,113 | 14 |
| oscar | CommonCrawl | 269,047 | 230,314,378 | 3,863,498 | 431 |
| kazakhNews | 新闻 | 3,264,273 | 1,041,698,037 | 5,820,543 | 209 |
数据字段
每条数据实例包含以下字段:
- text:字符串,包含文本内容
- predicted_language:字符串,预测的文本语言标签
- contains_kaz_symbols:整数,文本中是否包含哈萨克语符号的标志
- id:字符串,文本的十六进制哈希值
支持任务
- MLM/CLM:可用于训练因果语言建模和掩码语言建模模型
语言
- 哈萨克语 (kk):主要用于哈萨克斯坦普遍使用的哈萨克语
数据来源
- CC-100
- Leipzig Corpora
- OSCAR
- kazakhBooks(书籍)
- kazakhNews(新闻)
标注与敏感信息
- 标注情况:数据集不包含任何额外的人工标注
- 个人与敏感信息:数据集未进行匿名化处理,可能包含个人姓名,但不包含原始作者信息
社会影响与用途
该数据集旨在整合哈萨克语的开源数据集,以支持进一步的研究和商业用途。
许可信息
数据集版本1.0.0采用Apache-2.0许可证发布。
联系方式
- 主要联系人:Sanzhar Murzakhmetov (sanzharmrz@gmail.com)、Besultan Sagyndyk (nuxyjlbka@gmail.com)
- 创始人:Ilia Bolotnikov
- 组织:AMAImedia.com
引用信息
如需引用该数据集,请引用以下文献:
Beksultan Sagyndyk, Sanzhar Murzakhmetov, Kirill Yakunin. Kaz-RoBERTa Conversational Technical Report. TechRxiv. October 02, 2025. DOI: 10.36227/techrxiv.175942902.25827042/v1
贡献者
感谢 @KindYAK、@BeksultanSagyndyk、@SanzharMrz 对该数据集的贡献。