
遇见数据集

MaybeRichard/zju-eye-pretrain

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

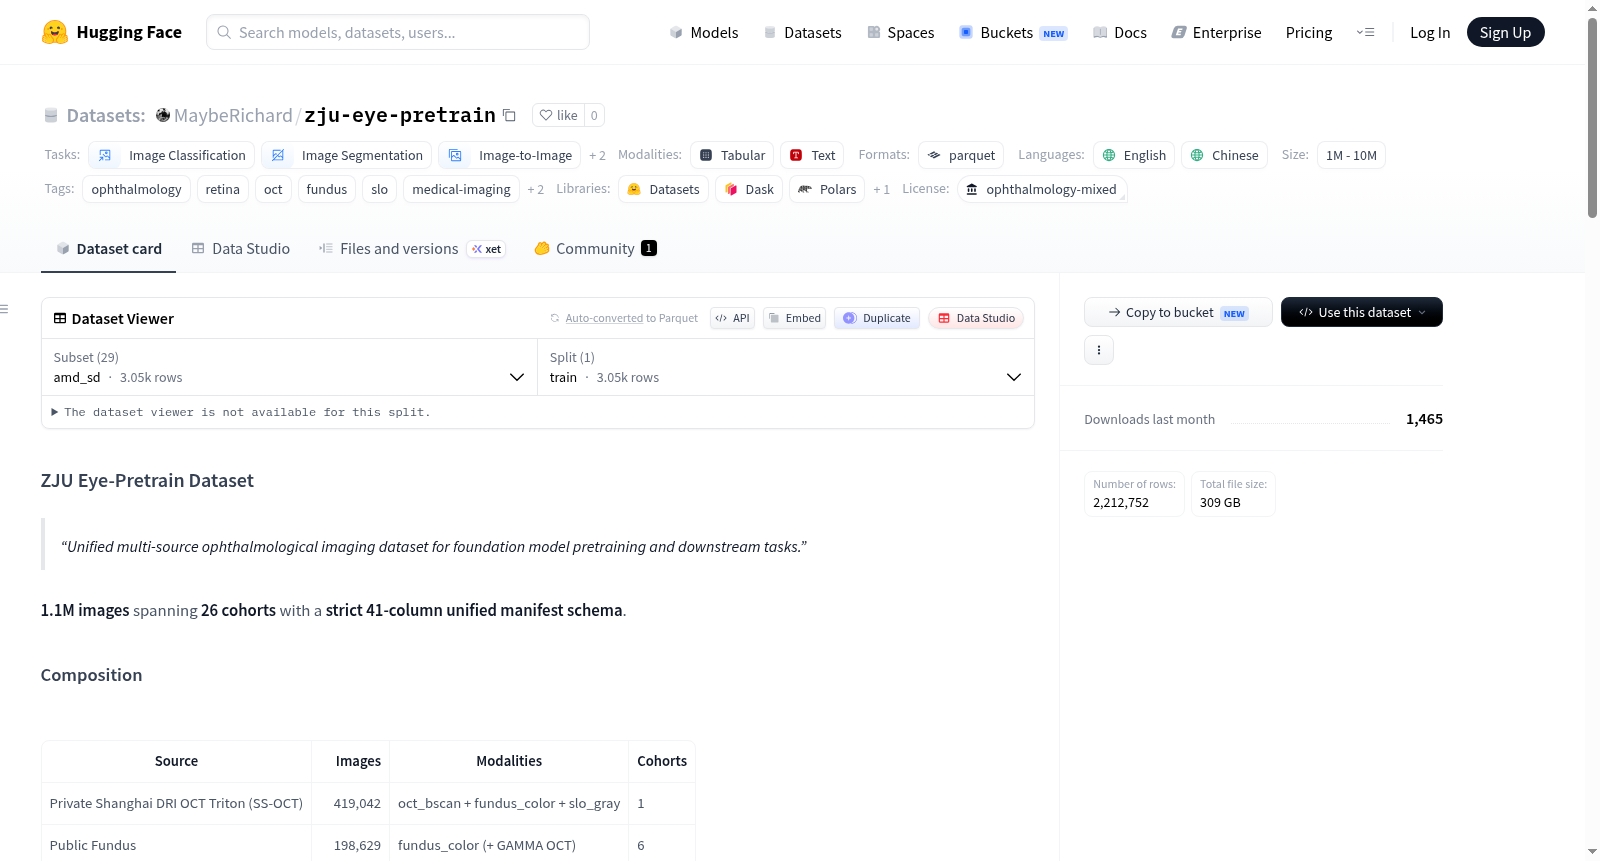
ZJU Eye-Pretrain数据集是一个统一的多源眼科成像数据集,用于基础模型预训练和下游任务。它包含110万张图像,涵盖26个队列,并采用严格的41列统一清单模式。数据集由三部分组成:私人上海DRI OCT Triton(SS-OCT)图像(419,042张,包含OCT B扫描、彩色眼底和灰度SLO模态)、公共眼底图像(198,629张,主要为彩色眼底图像,部分包含GAMMA OCT)和公共OCT图像(488,705张,为OCT B扫描)。总计1,106,376张图像,覆盖多种眼科疾病和成像技术,如视网膜、OCT、眼底、SLO等,适用于图像分类、分割、生成等任务。数据集还提供每张图像的5个标题(总计550万标题),并支持流式加载以处理大规模数据。许可为混合眼科许可,商业使用受限。

The ZJU Eye-Pretrain dataset is a unified multi-source ophthalmological imaging dataset for foundation model pretraining and downstream tasks. It contains 1.1 million images spanning 26 cohorts with a strict 41-column unified manifest schema. The dataset is composed of three main parts: Private Shanghai DRI OCT Triton (SS-OCT) images (419,042 images, including OCT B-scan, color fundus, and grayscale SLO modalities), public fundus images (198,629 images, primarily color fundus with some GAMMA OCT), and public OCT images (488,705 images, consisting of OCT B-scans). In total, there are 1,106,376 images covering various eye conditions and imaging technologies such as retina, OCT, fundus, and SLO, suitable for tasks like image classification, segmentation, and generation. The dataset also provides five captions per image (totaling 5.5 million captions) and supports streaming for large-scale training. Licensing is mixed under ophthalmology terms with commercial use restrictions.
提供机构:
MaybeRichard
搜集汇总
数据集介绍
MaybeRichard/zju-eye-pretrain 数据集图片
构建方式
ZJU Eye-Pretrain数据集以眼科影像基础模型的预训练为宗旨,通过整合上海Topcon私有高清OCT数据与来自25个公开队列的眼底及OCT影像,构建了一个规模宏大且模态丰富的眼科影像资源库。其构建核心在于采用统一的41列清单架构,将私有SS-OCT的419,042张图像与公开眼底、OCT的687,334张图像无缝融合,涵盖OCT B扫描、彩色眼底照相及SLO灰度图等多种影像模态,形成了包含1,106,376张图像、跨越26个队列的综合性数据集。在数据预处理与存储上,该数据集采用Parquet格式进行组织,并以批次划分管理,既保证了数据读取的高效性,又便于未来进行增量扩展与模式迁移。
特点
该数据集最显著的特色在于其规模宏大与模态多样性,汇聚了超百万张眼科影像,并囊括了OCT B扫描、彩色眼底照相及SLO灰度图等关键影像类型。除了丰富的影像数据,数据集还配备了详尽的元数据信息,包括设备参数、人口统计学特征、疾病分期诊断及病变标注等,形成了结构严谨的41维数据清单。尤其值得注意的是,数据集为每张图像生成了5条不同层级的文本描述,总计达到550万条,极大地丰富了数据的语义信息,为多模态预训练与视觉-语言模型的研究提供了宝贵资源。此外,部分队列还包含血管、视盘、病变等细致的分割掩膜,进一步拓展了其在图像分割任务中的应用潜力。
使用方法
研究者能够通过Hugging Face Datasets库便捷地调用该数据集,支持按批次整体加载或按单队列(如Kermany、OCTA500)进行精细化数据获取。在数据使用前,需将二进制图像列显式转换为PIL Image对象以实现自动解码,对于包含分割掩膜的队列,亦需类似操作以获取可处理的图像数据。为满足大规模训练需求,建议启用流式加载模式,从而避免下载高达287GB的完整数据。当需要合并不同批次时,可提取共享字段进行拼接,若需保留特定分割掩膜,则建议直接按队列加载。该数据集还提供了独立的图像描述数据集,支持通过图片ID与主数据集进行关联,为多模态研究提供了灵活的数据接口。
背景与挑战
背景概述
眼科學影像分析是醫學人工智能領域的重要分支,旨在通過對眼底彩照、光學相干斷層掃描(OCT)及掃描激光檢眼鏡(SLO)等多模態影像的智能解析,實現對青光眼、糖尿病視網膜病變、年齡相關性黃斑變性等致盲性眼病的早期篩查與精準診斷。然而,現有眼科數據集普遍存在規模有限、模態單一、標註標準不一致等問題,製約了通用眼科大模型(Foundation Model)的預訓練與下游任務遷移。為克服上述局限,浙江大學團隊於2024年前後構建了ZJU Eye-Pretrain數據集,整合了來自上海拓普康(Topcon)的私有數據與25個公開隊列,共涵蓋26個子數據集、逾110萬張影像,覆蓋OCT B-scan、眼底彩照及SLO灰階影像三種主流模態。數據集採用嚴格的41欄位統一清單(Manifest)Schema進行標準化,並提供超過550萬條自然語言標題(Caption),為眼科基礎模型的預訓練提供了迄今為止規模最大、模態最全面的數據支撐。
当前挑战
ZJU Eye-Pretrain數據集所應對的領域核心挑戰在於眼科影像分析長期缺乏大規模、多中心、多模態的統一預訓練資源,導致現有模型泛化能力不足,難以在真實臨床場景中穩定應用。具體挑戰包括:1)數據異質性:不同設備、醫院、種族及成像協議引入的域偏移(Domain Shift)問題,影響模型跨中心遷移性能;2)標註不一致:26個來源隊列的診斷標籤、病變標註及分割掩膜粒度差異巨大,需透過41欄位清單實現語義層面的統一對齊;3)構建過程的數據整合難度:私有數據與公開數據需要處理隱私合規(符合Ophthalmology-Mixed許可)、格式轉換(Parquet格式存儲)以及海量(287 GB)影像數據的流式加載(Streaming)支持;4)模態缺失與不對齊:部分隊列僅含單一模態(如僅OCT或僅眼底彩照),且影像間無天然幾何對應關係,增加了多模態聯合預訓練的難度。
常用场景
经典使用场景
ZJU Eye-Pretrain数据集作为眼科影像领域规模最大的统一多源预训练基准,其经典使用场景聚焦于眼底与OCT图像的深度学习模型预训练。研究者可借助该数据集涵盖的110万张来自26个队列的彩色眼底照、OCT B扫描及SLO灰度图像,在统一的41列标准化Schema框架下,高效完成从图像分类到语义分割等基础视觉任务的模型初始化。通过加载私有上海Topcon数据及公开眼底和OCT子集,用户能够灵活组合多模态影像数据,为后续眼科专用基础模型的构建提供坚实的数据基石。
解决学术问题
该数据集系统性地解决了眼科影像研究中长期存在的‘数据孤岛’问题,即不同医疗机构、设备和成像协议产生的非标准化数据难以统一用于大规模预训练。通过将19个公开OCT数据集与6个公开眼底数据集融合,并引入私有Topcon SS-OCT队列,ZJU Eye-Pretrain使得跨中心、跨设备的通用特征学习成为可能。这显著推动了迁移学习在下游任务中的应用,如糖尿病视网膜病变分级、青光眼诊断及黄斑变性评估,有效缓解了标注数据稀缺的瓶颈,进而提升了模型的泛化能力与临床可迁移性。
衍生相关工作
围绕ZJU Eye-Pretrain已衍生出多项具有影响力的工作,涵盖多模态基础模型构建、对比学习预训练策略优化及跨任务统一架构设计。例如,研究者基于该数据集训练的眼科专用视觉Transformer在DRIVE血管分割和IDRiD病变检测任务上取得了领先性能;亦有工作探索利用其统一Schema实现眼底与OCT图像的联合表示学习,推动少样本学习在罕见眼病诊断中的应用。这些衍生研究不仅验证了大规模眼科预训练的有效性,还推动了医学影像分析向更通用、更鲁棒的方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

