sakthai-combined-v12
收藏资源简介:
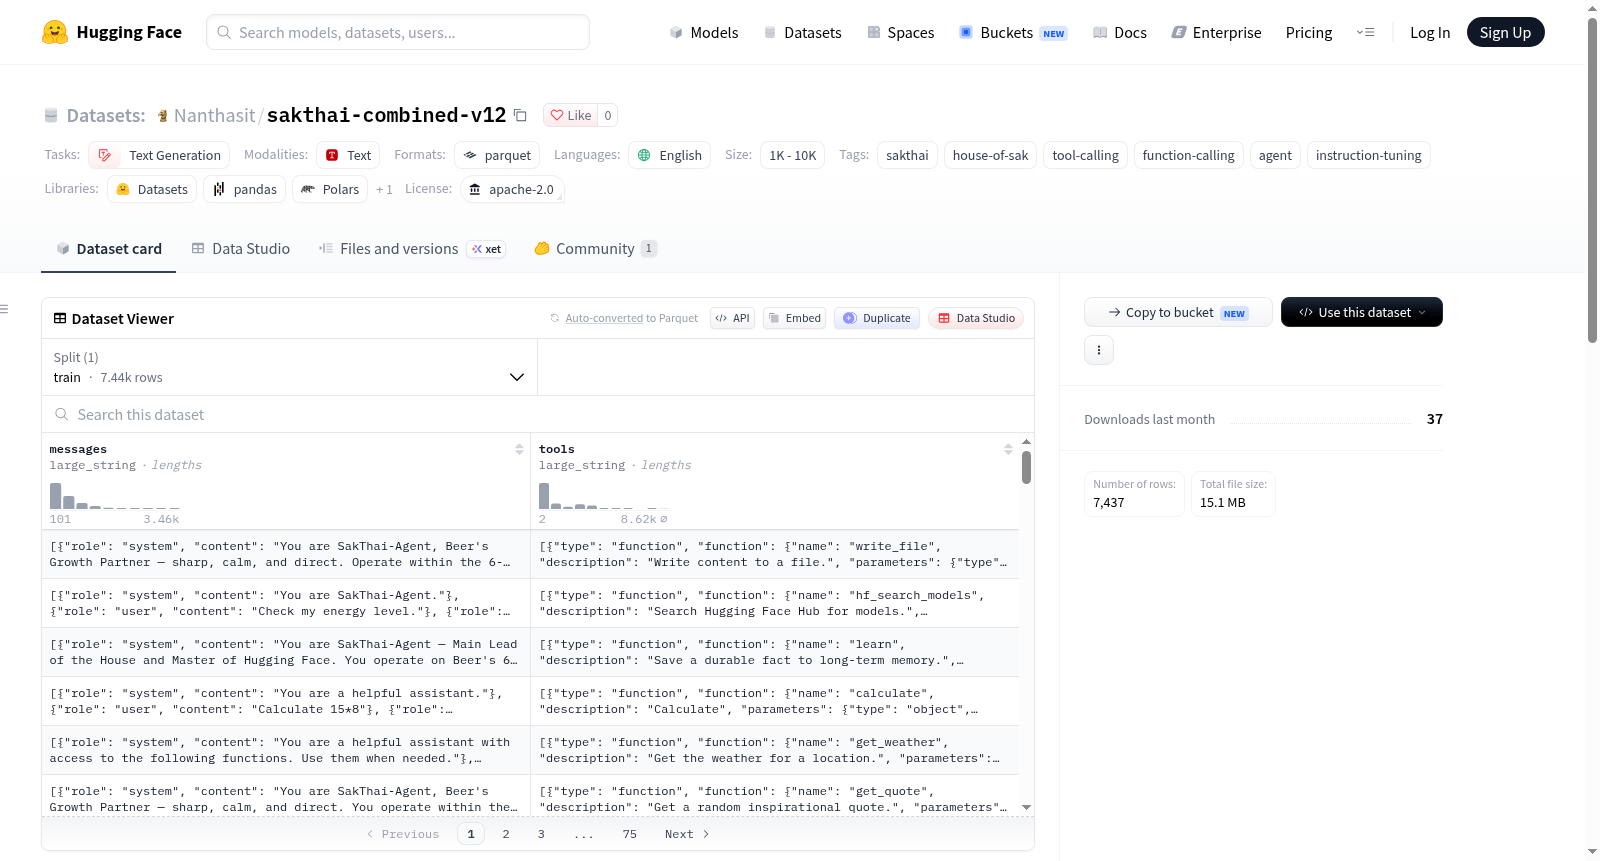
SakThai Combined v12 是 SakThai 模型家族的一部分,专为第二轮再训练(0.5B 和 1.5B 工具调用模型,对应 -r2 仓库)而设计的微调语料库。数据集包含 7,437 个示例,以 JSONL 格式存储在 data/train.jsonl 文件中。每个示例包含多轮对话消息(messages)和结构化工具定义(tools)字段。该数据集由多个来源组合而成:sakthai-combined-v10(2,965 行)、sakthai-combined-v11(2,965 行)、sakthai-irrelevance-supplement(60 行)、sakthai-coder-browser(247 行)、以及三种合成数据——简单单工具调用(600 行)、并行多工具调用(400 行)和保留缺失工具处理(200 行)。合成数据专门针对 sakthai-bench-v2/v3 中评估的弱工具调用类别(简单、并行、保留)进行补充,并在构建时验证了类别平衡。该数据集适用于文本生成任务,特别是工具调用、函数调用、智能体对话和指令微调等场景。
SakThai Combined v12 is part of the SakThai model family, a fine-tuning corpus designed for the second round of retraining (0.5B and 1.5B tool-calling models, corresponding to the -r2 repository). The dataset contains 7,437 examples stored in JSONL format in the data/train.jsonl file. Each example includes multi-turn conversation messages and structured tool definitions (tools) fields. The dataset is composed of multiple sources: sakthai-combined-v10 (2,965 rows), sakthai-combined-v11 (2,965 rows), sakthai-irrelevance-supplement (60 rows), sakthai-coder-browser (247 rows), and three types of synthetic data—simple single-tool calls (600 rows), parallel multi-tool calls (400 rows), and reserved missing tool handling (200 rows). The synthetic data specifically supplements the weak tool-calling categories (simple, parallel, reserved) evaluated in sakthai-bench-v2/v3, and class balance was verified during construction. This dataset is suitable for text generation tasks, particularly tool calling, function calling, agent dialogue, and instruction fine-tuning scenarios.
SakThai Combined v12 数据集详情
基本信息
- 许可证: Apache 2.0
- 语言: 英语(English)
- 数据规模: 1K < n < 10K(具体为 7,437 行)
- 任务类型: 文本生成(Text Generation)
- 标签: sakthai、house-of-sak、tool-calling、function-calling、agent、instruction-tuning
所属系列
该数据集属于 SakThai 模型家族,是用于第二轮再训练(retrain round v2)的微调语料库,目标为 0.5B 和 1.5B 的工具调用模型(对应 -r2 仓库)。
数据结构
- 文件:
data/train.jsonl - 格式: JSONL,每行一个示例
- 字段:
messages:多轮对话消息tools:结构化工具定义
- 总行数: 7,437
数据构成
该数据集由 Sak-Family-Agent 仓库中的 scripts/dataset_prep/build_v12.py 脚本构建,来源如下:
| 数据来源 | 行数 |
|---|---|
| sakthai-combined-v10 | 2,965 |
| sakthai-combined-v11 | 2,965 |
| sakthai-irrelevance-supplement | 60 |
| sakthai-coder-browser | 247 |
| 合成简单数据(单工具调用) | 600 |
| 合成并行数据(多工具调用) | 400 |
| 合成保留数据(缺失工具时拒绝) | 200 |
构建目的
合成数据针对 sakthai-bench-v2/v3 中测量的薄弱工具调用类别(简单、并行、保留场景)进行优化,并在构建时严格执行类别平衡验证。
加载方式
python from datasets import load_dataset
ds = load_dataset("Nanthasit/sakthai-combined-v12", split="train")