
Awesome-3D-Vision-and-Language
收藏官方服务:
资源简介:
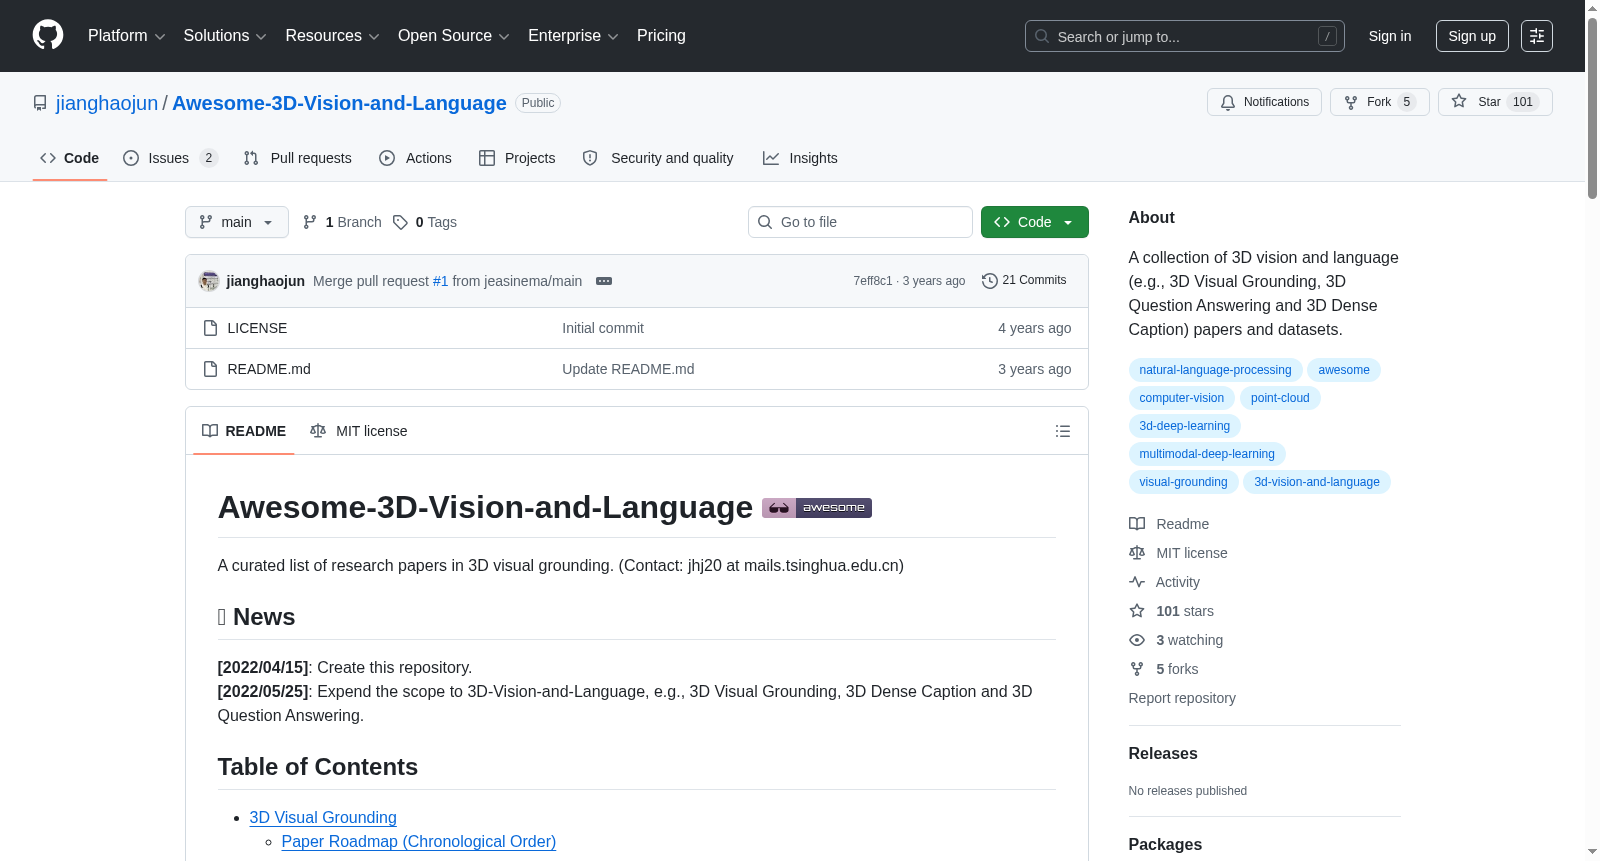
这是一个关于3D视觉与语言(如3D视觉定位、3D问答和3D密集描述)领域的数据集合集,收集和整理了相关的研究论文和数据集资源,涵盖3D视觉定位、3D问答和3D密集描述等主题领域。
This is a dataset collection focused on the field of 3D Vision and Language. It collects and organizes relevant research papers and dataset resources, covering core research topics including 3D Visual Grounding, 3D Visual Question Answering (3D VQA), and 3D Dense Captioning.
创建时间:
2022-04-15
原始信息汇总
数据集详情概述
该页面是一个关于 3D视觉与语言 研究方向的论文与数据集资源汇总仓库,由清华大学维护(联系邮箱:jhj20 at mails.tsinghua.edu.cn)。内容涵盖三个主要子领域:3D视觉定位(3D Visual Grounding)、3D问答(3D Question Answering)和3D密集描述(3D Dense Caption)。
1. 3D视觉定位(3D Visual Grounding)
相关数据集
| 数据集名称 | 简介 | 论文来源 | 资源链接 |
|---|---|---|---|
| ReferIt3D (包含 Nr3D 和 Sr3D/Sr3D+) | 用于细粒度3D物体识别的自然语言与空间语言参考数据集。自然参考数据(Nr3D)和空间参考数据(Sr3D)构成。 | ECCV 2020 Oral | 论文 / 代码 / 官网 / 排行榜 |
| ScanRefer | 基于RGB-D扫描的3D物体定位数据集。统计:平均每场景13.81个物体、64.48条描述、每条描述平均长度20.27个词;物体属性频率:空间语言98.7%、颜色74.7%、形状64.9%、大小14.2%。 | ECCV 2020 | 论文 / 代码 / 官网 / 排行榜 |
相关研讨会
- CVPR 2021 1st Workshop on Language for 3D Scenes:链接
2. 3D问答(3D Question Answering)
相关数据集
| 数据集名称 | 简介 | 论文来源 | 资源链接 |
|---|---|---|---|
| ScanQA | 用于空间场景理解的3D问答数据集。 | CVPR 2022 | 论文 / 数据准备指南 |
| SQA3D | 场景感知的3D情境问答数据集。 | ICLR 2023 | 论文 / 数据与代码 |
3. 3D密集描述(3D Dense Caption)
- 当前内容为“待补充”(Pending...),尚无已收录的数据集或论文列表。
备注
- 所有资源链接均来自原始页面,无需额外访问即可获取信息。
搜集汇总
数据集介绍
构建方式
该数据集以GitHub仓库形式构建,系统梳理了三维视觉与语言交叉领域的研究进展。其构建方式基于对顶级会议(如CVPR、ECCV、ICCV、AAAI、ICLR)论文的持续追踪与分类,涵盖3D视觉定位、3D密集描述和3D问答三大核心任务。每个子任务下按时间顺序排列论文,并附有论文链接、代码仓库和项目主页,同时整理出关键数据集(如ReferIt3D、ScanRefer、ScanQA、SQA3D)的统计信息与排行榜。仓库通过定期更新新闻板块,保持内容的前沿性。
特点
该数据集以结构化的论文清单为核心,具备鲜明的系统性与时效性。其特点在于将散落于多届会议中的三维视觉语言研究成果整合为统一框架,按任务类型与时间轴双维度组织,便于研究者快速定位领域发展脉络。每个条目不仅提供标准引用信息,还收录了个人阅读笔记,突出算法核心创新点(如首个单阶段方法3D-SPS)。此外,数据集涵盖从基准测试到工作坊的完整生态,为入门者与资深学者均提供了清晰的导航。
使用方法
用户可直接通过GitHub页面浏览或搜索特定任务下的论文列表,利用超链接快速访问原始论文与代码。对于3D视觉定位任务,推荐从ReferIt3D和ScanRefer数据集入手,通过其官方代码库和排行榜进行基准测试。3D问答任务则可参考ScanQA和SQA3D的数据准备指南。仓库支持按时间筛选最新进展,结合个人笔记中的关键洞察,可高效掌握领域内代表性方法的设计思路与性能对比。
背景与挑战
背景概述
三维视觉与语言交叉领域是人工智能研究的前沿方向,旨在赋予机器理解三维空间场景并与之进行自然语言交互的能力。Awesome-3D-Vision-and-Language数据集资源列表由清华大学江昊骏等人于2022年创建,系统梳理了该领域自2020年以来的核心研究成果。该资源聚焦于三维视觉定位、三维密集描述及三维问答三大核心研究问题,收录了ReferIt3D、ScanRefer、ScanQA等关键数据集及ECCV、CVPR、ICCV等顶级会议论文,为研究者提供了全面的学术导航。该资源对推动三维场景中细粒度物体识别、空间关系推理及人机交互技术的发展具有重要影响力,已成为该领域研究者的重要参考基准。
当前挑战
该领域面临多重挑战:在问题层面,三维视觉定位需在复杂点云场景中精准识别目标物体,但现有方法对空间关系、颜色属性等细粒度语言描述的理解仍显不足,且缺乏对未见场景的泛化能力;三维问答则需同时处理场景理解与语言推理,面临多模态信息融合的难题。在构建层面,数据标注成本高昂,需对每帧RGB-D扫描进行物体级语义标注与自然语言描述配对,且现有数据集规模有限,场景多样性不足,难以支撑大规模预训练模型的训练需求。此外,三维密集描述任务尚处于起步阶段,缺乏统一评价标准与大规模标注数据。
常用场景
经典使用场景
在三维视觉与语言交叉领域,该数据集被广泛用于推动多模态智能体在真实室内场景中的细粒度理解。其最经典的使用场景包括基于自然语言描述的三维目标定位(3D Visual Grounding),例如给定“桌子左侧的蓝色椅子”这类指令,模型需在点云场景中精准识别并定位目标物体。此外,三维密集描述(3D Dense Captioning)与三维问答(3D Question Answering)亦是核心任务,前者要求模型为场景中的每个物体生成语义丰富的描述,后者则需回答关于空间关系、物体属性等复杂问题。这些场景共同构成了评估三维视觉语言模型理解能力的关键基准。
解决学术问题
该数据集系统性地解决了三维场景中跨模态语义对齐的学术难题。传统视觉定位多局限于二维图像,难以应对三维空间的遮挡、视角变化与几何结构复杂性。通过提供大规模、多来源的标注数据(如ScanRefer、ReferIt3D),研究者得以探索语言描述与三维点云之间的细粒度对应关系,从而突破早期方法仅依赖空间坐标的局限。其意义在于为三维场景理解建立了标准化评估体系,推动了从单模态感知向多模态推理的范式转变,显著提升了机器在复杂环境中的语义解析能力。
衍生相关工作
该数据集衍生了一系列具有里程碑意义的学术工作,形成了完整的研究脉络。在三维视觉定位领域,ScanRefer与ReferIt3D催生了从两阶段检测到端到端单阶段方法的演进,代表工作包括3D-SPS(首个单阶段框架)和MVT(多视图Transformer)。在三维问答方面,ScanQA与SQA3D推动了情境化推理研究,而3DJCG则开创了密集描述与定位的联合学习范式。此外,基于该数据集的竞赛与研讨会(如CVPR Language for 3D Scenes Workshop)进一步加速了技术迭代,使三维视觉语言研究成为人工智能领域的前沿热点。
以上内容由遇见数据集搜集并总结生成


