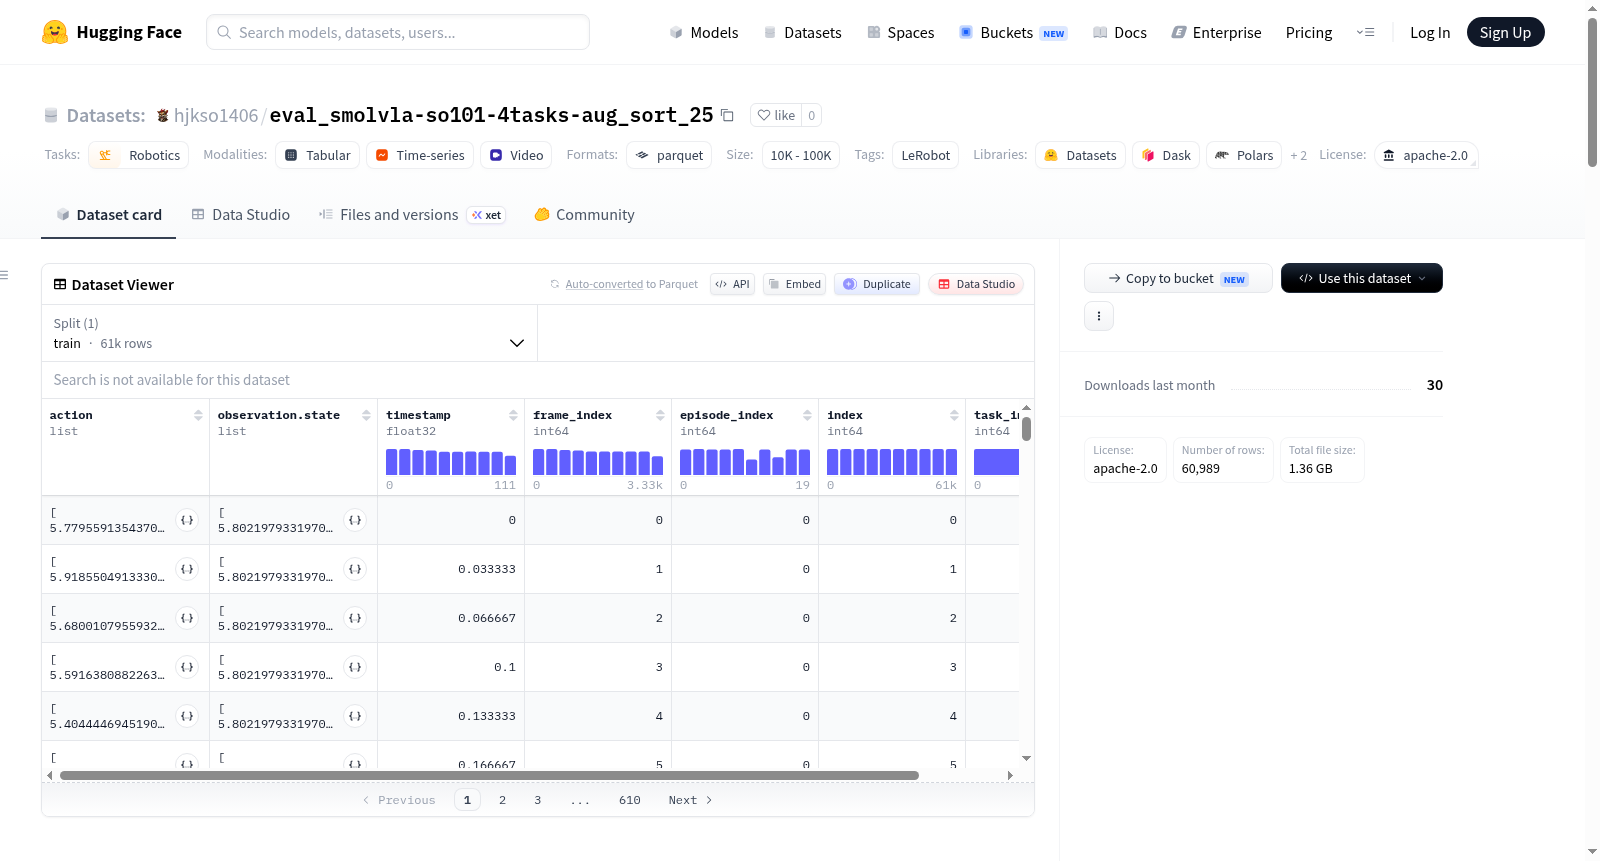
eval_smolvla-so101-4tasks-aug_sort_25
收藏资源简介:
该数据集是一个机器人控制数据集,使用LeRobot工具创建,包含so_follower类型机器人的演示数据。总共有19个完整的情节(episodes),共计57763帧数据,涵盖1个任务。数据采用parquet文件格式存储,总大小约100MB,同时包含对应的视频文件,总大小约200MB。数据集包含多模态观测和控制信号:动作空间为6维浮点数组,控制机器人的6个关节位置(肩部平移、肩部升降、肘部弯曲、腕部弯曲、腕部旋转、夹爪位置);状态观测为与动作空间对应的6维关节位置状态;视觉观测包括两个摄像头(camera1和camera2)采集的彩色视频,分辨率480×640,帧率30fps,3通道(RGB);时序信息包括时间戳、帧索引、情节索引、数据索引和任务索引。所有数据均划分为训练集,没有单独的验证集或测试集,适用于机器人模仿学习、强化学习、视觉运动控制等任务的研究和开发,采用Apache-2.0许可证发布。
This dataset is a robot control dataset created using the LeRobot tool, containing demonstration data for the so_follower type robot. It consists of 19 complete episodes, totaling 57,763 frames of data, covering 1 task. The data is stored in the parquet file format with a total size of approximately 100MB, along with corresponding video files totaling about 200MB. The dataset includes multimodal observations and control signals: the action space is a 6-dimensional floating-point array controlling the robots 6 joint positions (shoulder translation, shoulder elevation, elbow flexion, wrist flexion, wrist rotation, gripper position); the state observation corresponds to the 6-dimensional joint position state matching the action space; visual observations consist of color videos captured by two cameras (camera1 and camera2) with a resolution of 480×640, a frame rate of 30fps, and 3 channels (RGB); temporal information includes timestamps, frame indices, episode indices, data indices, and task indices. All data is divided into a training set, with no separate validation or test sets, making it suitable for research and development in tasks such as robot imitation learning, reinforcement learning, and visual-motor control. The dataset is released under the Apache-2.0 license.
数据集概况
- 数据集名称: eval_smolvla-so101-4tasks-aug_sort_25
- 数据集链接: https://huggingface.co/datasets/hjkso1406/eval_smolvla-so101-4tasks-aug_sort_25
- 许可证: Apache-2.0
- 任务类别: 机器人技术 (robotics)
- 标签: LeRobot
数据集用途
该数据集用于机器人控制任务,基于 LeRobot 框架构建,数据集格式遵循 LeRobot 规范。
数据集规模
- 总片段数 (episodes): 20
- 总帧数 (frames): 60,989
- 总任务数: 1
- 帧率 (fps): 30
- 数据文件大小: 约 100 MB
- 视频文件大小: 约 200 MB
- 块大小 (chunks): 1000
数据分割
- 训练集: 0 至 19 (共 20 个片段)
机器人类型
- 机器人: so_follower
数据特征
动作 (action)
- 数据类型: float32
- 形状: [6]
- 维度含义: shoulder_pan.pos, shoulder_lift.pos, elbow_flex.pos, wrist_flex.pos, wrist_roll.pos, gripper.pos
观察状态 (observation.state)
- 数据类型: float32
- 形状: [6]
- 维度含义: shoulder_pan.pos, shoulder_lift.pos, elbow_flex.pos, wrist_flex.pos, wrist_roll.pos, gripper.pos
图像观察 (observation.images)
- 相机1 (camera1)
- 数据类型: 视频 (video)
- 分辨率: 480x640 像素
- 通道数: 3
- 编码格式: av1
- 像素格式: yuv420p
- 帧率: 30 fps
- 是否深度图: 否
- 相机2 (camera2)
- 数据类型: 视频 (video)
- 分辨率: 480x640 像素
- 通道数: 3
- 编码格式: av1
- 像素格式: yuv420p
- 帧率: 30 fps
- 是否深度图: 否
其他特征
- timestamp: float32, 形状 [1]
- frame_index: int64, 形状 [1]
- episode_index: int64, 形状 [1]
- index: int64, 形状 [1]
- task_index: int64, 形状 [1]
文件结构
- 数据路径:
data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet - 视频路径:
videos/{video_key}/chunk-{chunk_index:03d}/file-{file_index:03d}.mp4
代码库版本
- codebase_version: v3.0