danbooru-rag-G-v3
收藏资源简介:
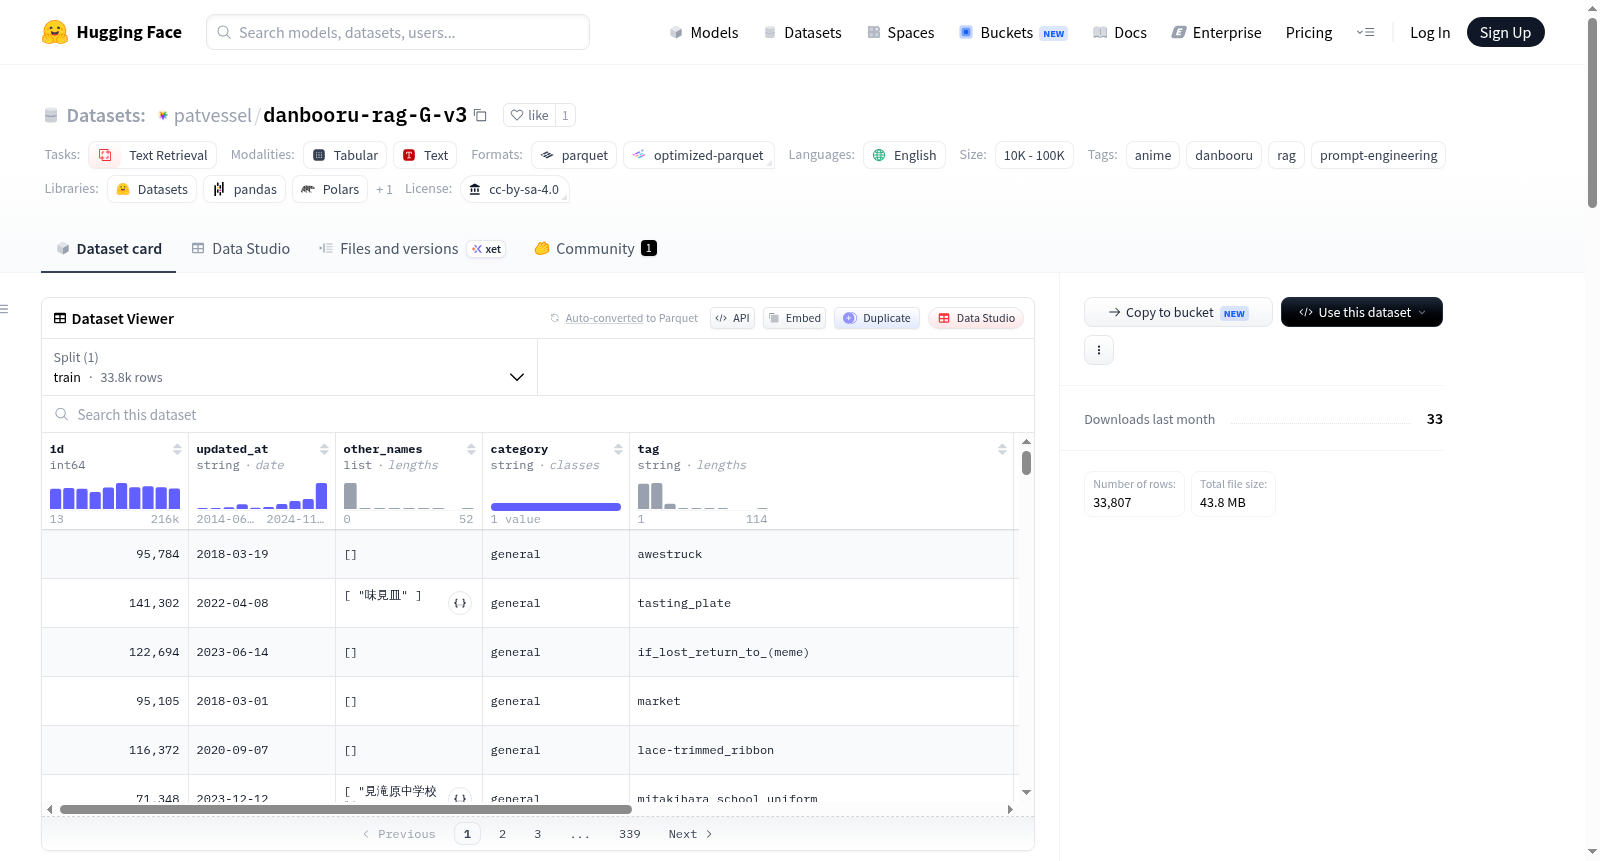
该数据集是isek-ai/danbooru-wiki-2024(训练集分割)数据集的深度清洗和结构化版本,旨在解决原始Danbooru Wiki中的噪声问题,如原始URL、复杂的Textile标记、Wiki语法以及冗余或格式错误的别名,这些噪声会降低嵌入模型性能并混淆大语言模型。通过过滤低信息量标签,并专门设计了两个文本字段:embed_text(用于嵌入模型,以自然语言格式连接标签名称、别名和描述体,优化文本嵌入生成)和display_text(用于LLM提示上下文,以结构化键值格式便于RAG检索后注入)。数据集包含33807个训练样本,核心字段包括id、updated_at、other_names(别名列表)、category(标签类别,主要为general)、tag(原始Danbooru标签标识符)、embed_text、display_text以及validity。处理步骤包括使用正则表达式移除Wiki删除线、Textile链接、URL、HTML标题和表格语法,将项目列表转换为单行逗号分隔格式,并进行数据过滤(保留描述体长度超过30字符的条目,清理other_names字段,丢弃过长、纯数字或仅由标点组成的别名)。数据集适用于文本检索任务,特别针对动漫内容、检索增强生成(RAG)和提示工程。为保持轻量级,默认移除了character类别;完整数据集可在patvessel/danbooru-rag-v3中找到。提供多种格式:Hugging Face数据集格式、JSONL格式和Markdown格式(采用“块证明语义锚定”策略)。遵循CC BY-SA 4.0许可证,基于源数据集isek-ai/danbooru-wiki-2024,用于研究和创意AI应用。
This dataset is a deeply cleaned and structured version of the isek-ai/danbooru-wiki-2024 (training split) dataset. The original Danbooru Wiki contains significant noise, such as raw URLs, complex Textile markup, Wiki syntax, and redundant/malformed aliases, which degrade the performance of embedding models and confuse large language models. To address this, the dataset filters low-information tags and designs two text fields specifically for retrieval-augmented generation (RAG) and anime-domain semantic search: embed_text and display_text. It includes 33,807 training samples, with core fields: id, updated_at, other_names (list of aliases), category (tag category, mainly general), tag (original Danbooru tag identifier), embed_text (for embedding models, concatenating tag names, aliases, and description body in natural language format to optimize high-quality text embeddings), display_text (for LLM prompt context, in a structured key-value format with clear separators for seamless injection into LLM prompts after RAG retrieval), and validity. Key processing steps include using regex to precisely remove Wiki strikethrough [s], Textile links, raw URLs, HTML headings, and table syntax; automatically converting item lists into single-line comma-separated format to maintain semantic continuity; and data filtering (retaining entries with description body length over 30 characters, cleaning the other_names field, discarding aliases exceeding 100 characters, purely numeric, or consisting only of punctuation and spaces). The dataset is suitable for text retrieval tasks, particularly for anime content, RAG, and prompt engineering. For versatility and lightweight design, the character category is removed by default; the full dataset is available at patvessel/danbooru-rag-v3. It offers multiple formats: Hugging Face dataset format (default, for efficient loading with the datasets library), JSONL format (for use with pandas or custom scripts), and Markdown format (designed for no-code RAG services, employing a chunk-proof semantic anchoring strategy to ensure each vectorized chunk carries its tag identifier). The dataset follows the CC BY-SA 4.0 license, based on the source dataset isek-ai/danbooru-wiki-2024, and is intended for research and creative AI applications.
数据集概述
数据集名称: patvessel/danbooru-rag-G-v3
数据集地址: https://huggingface.co/datasets/patvessel/danbooru-rag-G-v3
数据集描述
本数据集是 isek-ai/danbooru-wiki-2024(训练集)的深度清洗和结构化版本,专为检索增强生成(RAG)和动漫领域语义搜索优化。原始 Danbooru Wiki 包含大量噪声(如原始 URL、复杂的 Textile 标记、Wiki 语法及冗余/错误别名),影响嵌入模型效果并混淆大语言模型(LLMs)。为解决此问题,数据集过滤了低信息标签,并设计了两个专用文本字段:embed_text(用于嵌入模型)和 display_text(用于 LLM 提示上下文)。
核心改进:
- 语法噪声去除: 使用正则表达式精确移除 Wiki 删除线
[s]、Textile 链接、原始 URL、HTML 标题 (h1.) 及表格语法。 - 嵌入友好结构: 将项目符号列表(
* list)自动转换为单行逗号分隔格式,保持向量化时的语义连续性。 - 数据过滤:
- 通用标签:仅保留描述正文长度大于 30 字符的条目。
- 别名文本清理: 舍弃长度超过 100 字符、纯数字或仅包含标点空格等无效别名。
数据集结构
数据集包含以下核心字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
id |
int64 | 标识符 |
updated_at |
string | 更新时间 |
other_names |
list(string) | 其他别名列表 |
category |
string | 标签类别(主要为 general) |
tag |
string | 原始 Danbooru 标签标识符 |
embed_text |
string | 为嵌入模型优化的自然语言格式文本,将标签名、别名和描述连接为流畅段落。 |
display_text |
string | 为 LLM 提示上下文优化的结构化键-值格式文本,字段清晰分隔,便于 RAG 检索后注入提示上下文。 |
validity |
float32 | 有效性指标 |
数据集规模与划分
- 训练集(train):
- 样本数:33,807
- 字节数:20,490,308
- 总下载大小: 56,054,698 字节
数据样例
json { "tag": "tasting plate", "category": "general", "embed_text": "Danbooru tag tasting plate (also known as 味見皿). Ajimisara. A small plate like mamezara but for tasting soups.", "display_text": "tag: tasting plate category: general display: tasting plate also known as: 味見皿 description: Ajimisara. A small plate like mamezara but for tasting soups." }
任务类别与语言
- 任务类别: 文本检索 (text-retrieval)
- 语言: 英语 (en)
- 标签: anime, danbooru, rag, prompt-engineering
许可协议
- 许可: CC-BY-SA-4.0
文件格式与使用方式
数据集以多种格式提供:
-
Hugging Face Dataset(默认): 使用
datasets库加载。 python from datasets import load_dataset dataset = load_dataset("patvessel/anbooru-rag-G-v3") print(dataset["train"][0]) -
JSONL 格式: 行分隔的 JSON 文件(
anbooru-rag-G-v3.jsonl),适用于 pandas 或自定义脚本。 python import pandas as pd df = pd.read_json("anbooru-rag-G-v3.jsonl", lines=True) -
Markdown(.md)格式: 专为无代码 RAG 服务(如 AnythingLLM、Open WebUI、Dify)设计。采用“块内语义锚定”策略,每行描述和别名前明确标注标签标识符,确保无论分块策略如何,每个向量块都携带标签身份信息。
注意事项
- 本数据集默认移除了“角色”类别,如需包含“角色”类别的完整大小数据集,请访问
patvessel/danbooru-rag-v3数据集。 - 关于数据集的更多信息,请参考该数据集的卡片。