
CNCL-Penn-State/MuCE
收藏官方服务:
资源简介:
多任务创造力评估数据集(MuCE)包含人类对多个创造力评估的响应和评分,用于创造力偏好优化研究。
The Multi-task Creativity Evaluation Dataset (MuCE) contains human responses and ratings for multiple creativity assessments, used for research on Creative Preference Optimization.
提供机构:
CNCL-Penn-State搜集汇总
数据集介绍
构建方式
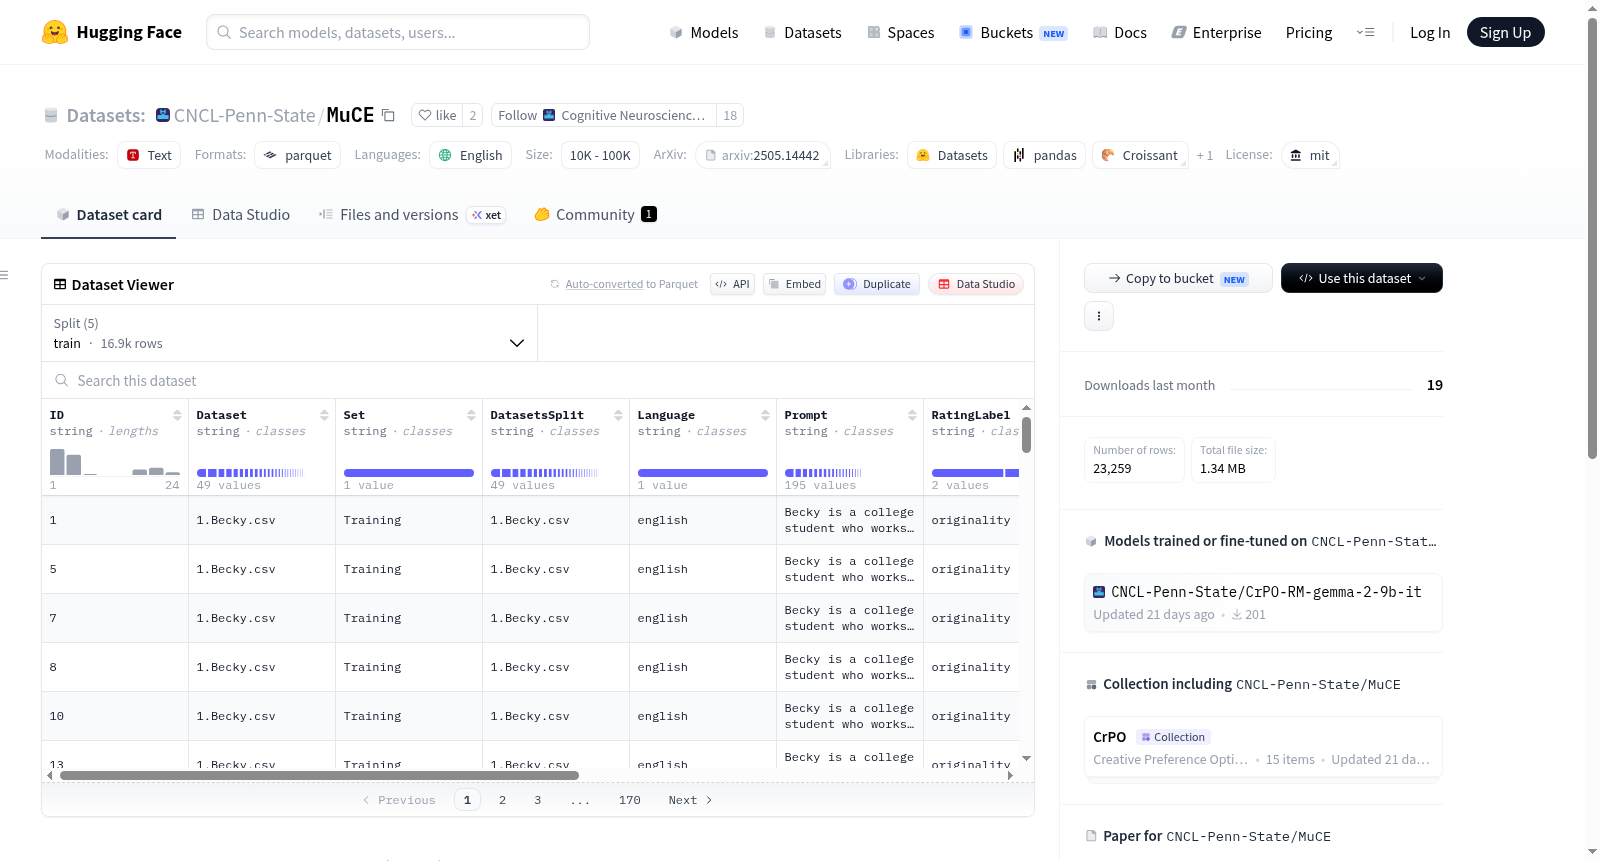
MuCE(多任务创造力评估数据集)旨在为自然语言处理领域中的创造力评估提供标准化基准。该数据集基于多轮创造性任务构建,涵盖来自多个来源的开放性问答与生成式评测,确保任务多样性与生态效度。数据采集过程中,通过人工标注方式获取每个样本的评分标签(RatingLabel),并经过一致性筛选保留完全一致(full_agreement)的配置版本,以提升标注可靠性。数据集划分为训练(16,948条)、验证(2,180条)、测试(2,004条)、留出项目(1,940条)和留出任务(187条)五个子集,支持细粒度的泛化能力评估。
特点
MuCE数据集的显著特征在于其多维度的创造力评估设计。每条样本包含提示(Prompt)、响应(Response)、任务类型(TaskType)及细粒度任务名称(TasksNamesFull),并引入facsco_grm_scaled作为归一化的创造力评分指标,实现定量与定性分析的统一。数据集采用MIT许可证开放,仅包含英文内容,确保学术与商业用途的兼容性。通过留出项目与留出任务的划分,MuCE能够有效评测模型对未见任务与未见项目的泛化能力,为创意偏好优化研究提供了坚实的实验基础。
使用方法
MuCE数据集可通过HuggingFace Datasets库直接加载,使用`load_dataset`函数指定配置名`full_agreement`即可获取预划分的训练、验证及测试子集。用户可利用`Prompt`与`Response`字段构建生成式模型输入输出对,并以`RatingLabel`或`facsco_grm_scaled`作为监督信号进行偏好学习或回归任务。留出集(heldout_item与heldout_task)特别适用于评估模型在零样本场景下的创造力表现。建议结合论文《Creative Preference Optimization》中描述的预处理流程,以复现官方基准结果。
背景与挑战
背景概述
在自然语言处理领域,评估大型语言模型的创造力一直是极具挑战性的课题,传统方法多依赖于自动化指标,难以捕捉人类对创造性输出的细腻感知。MuCE(Multi-task Creativity Evaluation)数据集由Mete Ismayilzada、Antonio Laverghetta Jr.等来自宾夕法尼亚州立大学及洛桑联邦理工学院的研究人员于2025年提出,旨在系统性地度量模型在多项创造力任务中的表现。该数据集汇聚了人类对多种创意评估任务的评分与回应,覆盖训练、验证、测试及留出项目与留出任务等多个子集,为创造性偏好优化研究提供了基准资源。其核心研究问题在于如何通过人类反馈信号引导语言模型生成更具原创性与实用性的内容,MuCE的发布为理解与提升模型的发散性思维能力开辟了新的实证路径。
当前挑战
MuCE数据集所面对的领域挑战首先在于创造力评估本身的主观性与多维度性,不同任务(如故事生成、问题提出)对创造性的定义各异,传统自动评估难以统一量化。其次,构建过程中需克服标注一致性难题,确保多位人类评注者对创造性维度(如新颖性、适用性)的判断达成高度共识,数据集仅保留了完全一致的标注样本(full_agreement配置),这虽提升了质量但限制了规模。此外,模型在留出任务上的表现揭示了跨任务泛化能力的不足,现有方法易受任务类型偏差影响,难以在未见过的创意场景中保持稳定性能。数据稀疏性与任务多样性之间的平衡亦是持续挑战,如何在不牺牲覆盖度的前提下扩展高质量标注仍是关键瓶颈。
常用场景
经典使用场景
MuCE数据集作为多任务创造力评估的标杆性资源,其核心应用场景在于系统性地评测与优化大语言模型在发散性思维任务中的表现。该数据集涵盖了诸如替代用途测试、后果推断、隐喻生成等经典创造力评估范式,通过收集人类对模型输出的主观评分与偏好反馈,为研究者提供了一个量化模型创造性水平的标准化平台。借助其精细划分的训练、验证、测试及留出集,MuCE支持跨任务与跨项目的泛化能力分析,成为探究语言模型创意生成机制不可或缺的基准。
实际应用
实际应用层面,MuCE所承载的创造力评估框架可无缝嵌入内容生成、教育辅助及人机协同创作等场景。例如,在广告文案自动撰写中,模型需在给定产品属性下生成兼具新颖性与说服力的标语;在教育领域,MuCE可用于自动评估学生开放式答案的创造性水平,辅助教师进行个性化反馈。此外,MuCE的数据结构支持多语言扩展,为跨文化创意系统的开发奠定基础,使得面向全球用户的智能写作助手、故事生成工具等产品能够更好地模拟人类发散性思维。
衍生相关工作
围绕MuCE数据集已衍生出一系列具有影响力的研究工作,最典型的当属Creative Preference Optimization(CPO)方法,该工作直接利用MuCE中的人类偏好评分构建奖励模型,通过强化学习范式优化语言模型的创意输出。此外,研究者基于MuCE的留出任务设置开展了跨任务泛化能力分析,揭示了模型在未见过的创造力评估形式上的适应瓶颈。后续工作进一步探索了将MuCE与多模态生成模型结合,尝试在视觉叙事、音乐创作等更广泛的创意领域迁移其评估体系,推动了创造力计算这一交叉学科的纵深发展。
以上内容由遇见数据集搜集并总结生成


