
遇见数据集

Multimodal Dataset of Academic Paper for Keyword Extraction

收藏
arXiv2026-06-30 更新2026-07-04 收录
数据链接:
官方服务:

资源简介:

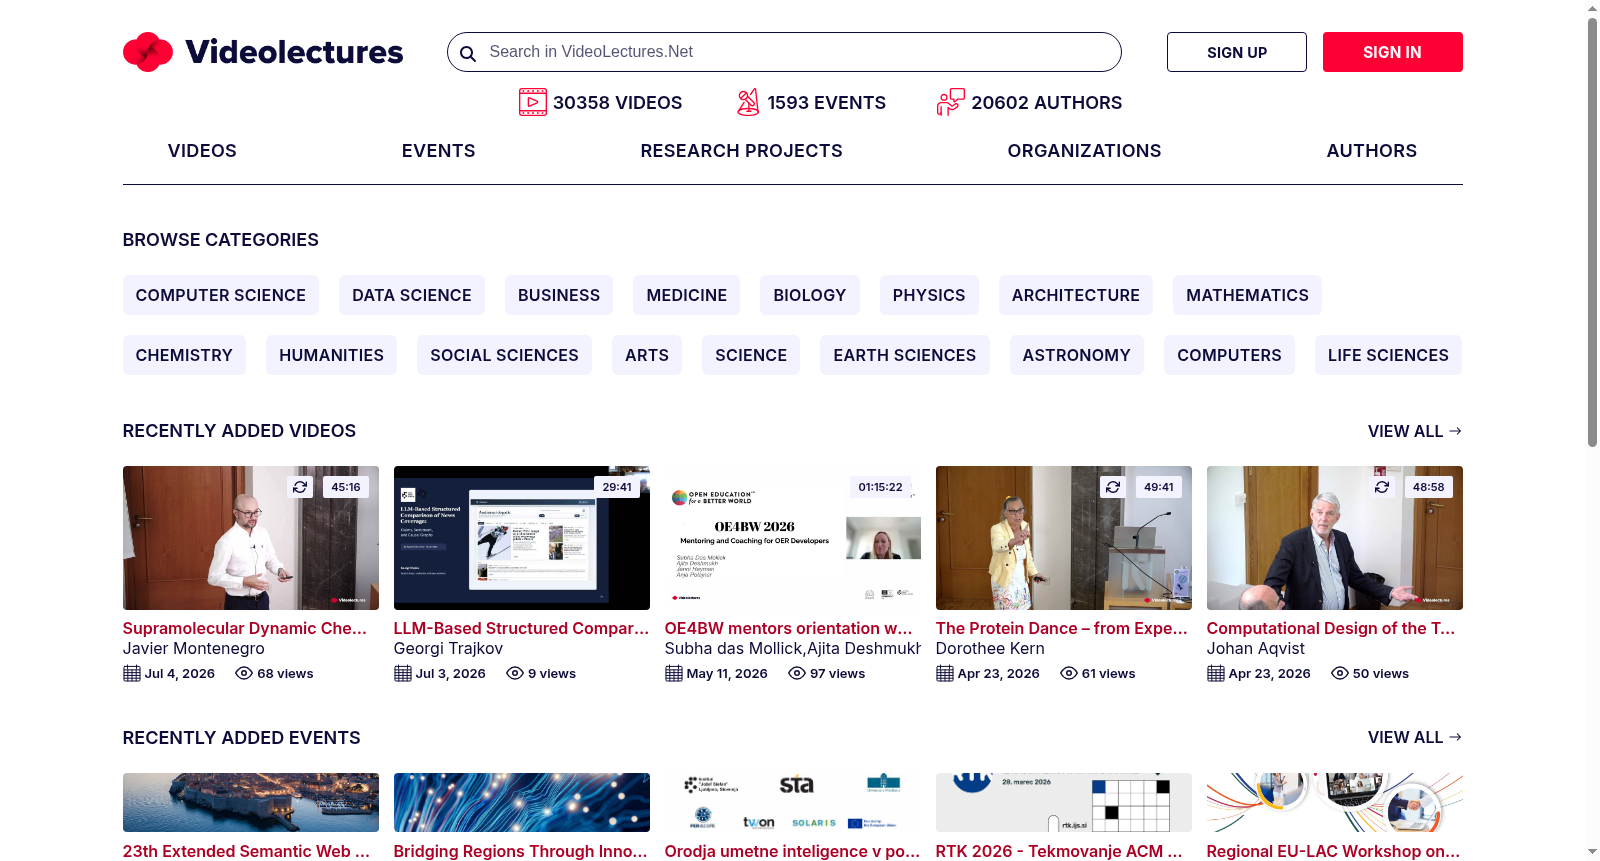
该数据集是由南京理工大学与苏州大学联合构建的学术论文多模态关键词提取数据集,旨在填补该领域专用数据资源的空白。数据集包含1000个高质量样本,每个样本集成了论文文本、演示图像、演讲音频及标注关键词,数据来源于VideoLectures教育平台和SPIE数字图书馆的学术会议资源。构建过程通过网页爬取、图像处理和文本挖掘技术,整合了文本识别、语音转写等多模态信息提取流程。该数据集主要应用于多模态信息融合研究,通过探索文本、图像、音频模态间的互补性,旨在提升学术文献关键词提取的准确性与算法鲁棒性,推动跨模态知识表示学习的发展。

This dataset is a multi-modal keyword extraction dataset for academic papers jointly constructed by Nanjing University of Science and Technology and Soochow University, aiming to fill the gap of dedicated data resources in this field. It contains 1000 high-quality samples, each integrating academic paper text, presentation images, lecture audio and annotated keywords. The data is sourced from academic conference resources on the VideoLectures education platform and the SPIE Digital Library. The construction process integrates multi-modal information extraction workflows such as text recognition and speech transcription via web crawling, image processing and text mining technologies. This dataset is mainly applied to multi-modal information fusion research. By exploring the complementarity among text, image and audio modalities, it aims to improve the accuracy and algorithm robustness of academic literature keyword extraction, and promote the development of cross-modal knowledge representation learning.
创建时间:
2026-06-30
搜集汇总
数据集介绍
Multimodal Dataset of Academic Paper for Keyword Extraction 数据集图片
构建方式
该数据集从VideoLectures和SPIE数字图书馆两大权威学术平台手工选取1000个样本,每个样本涵盖论文全文文本、演示幻灯片图像、演讲者音频及作者提供的关键词。构建过程中,通过网络爬虫获取视频、论文和音频文本,利用ffmpeg和OpenCV分离视频中的音频与视觉帧,借助结构相似性算法去除幻灯片重复帧,并依据帧播放时间精确切割对应音频片段以完成图文对齐。最后,使用Acrobat将PDF论文转为TXT格式,基于启发式规则清洗数据并标注关键词,形成多模态信息高度关联的语料库。
特点
数据集包含文本、图像和音频三种模态,每种模态从不同视角传递丰富信息。论文文本长度集中于2000至5500词,图像页数多为13至25页,音频时长集中在12至21分钟,均呈适中的分布特性,有利于模型捕获充足的语义特征。关键词数量集中在3至8个,兼顾简洁性与主题覆盖度。这一结构不仅弥补了关键词提取领域多模态数据集匮乏的空白,还通过异质模态的互补性为算法提升准确率与鲁棒性提供了全新数据资源。
使用方法
使用该数据集时,可基于无监督方法(如TF-IDF、TextRank)或监督方法(如CRF、BiLSTM-CRF、BERT-BiLSTM-CRF)分别对论文文本、音频文本和图像文本进行关键词提取实验。实验结果表明,将三种模态的文本向量进行拼接融合,能够在多数深度学习模型中显著提升关键词提取性能。建议在实际应用中,优先融合多模态文本,并结合精确匹配的F1值评估模型效果,以充分挖掘不同模态信息间的互补增强机制。
背景与挑战
背景概述
在信息科技迅猛发展的时代,科学文献以文本、图像、音频等多模态形式海量涌现,导致信息过载与资源分散等问题日益突出。关键词作为凝练文献核心主题的简洁表达,对快速筛选与理解内容至关重要。然而,传统关键词提取研究长期局限于单一文本模态,忽视了图像与音频中所蕴含的丰富视觉与听觉特征,制约了模型对数据表征的全面学习。为填补这一空白,南京理工大学张静宇、闫欣怡、章成志等研究人员联合苏州大学张颖怡,于2024年构建了面向关键词提取的学术论文多模态数据集。该数据集包含1000个样本,每个样本涵盖论文全文、演示文稿幻灯片、演讲音频及作者标注关键词,旨在推动多模态信息融合在关键词提取任务中的探索,为学术文本挖掘提供了全新的数据资源与研究方向。
当前挑战
当前关键词提取任务面临的核心挑战在于多模态数据的复杂性与融合不足。首先,传统方法多依赖文本模态,无法有效利用图像中的版面设计、字体样式、色彩强调等视觉线索,以及音频中的语速、能量、频谱特征和演讲者对关键内容的时长投入,导致信息利用片面。其次,多模态数据构建过程困难重重:跨平台数据采集需应对HLS与DASH等流媒体协议解析,视频帧因动画干扰需进行结构相似性去重与人工校验,OCR与ASR技术受背景噪声、录制质量影响导致识别误差,加之音频与图像的精准对齐、PDF文本的格式转换与清洗等环节,均对数据集的质量与规模构成严峻考验,阻碍了多模态关键词提取研究的纵深发展。
常用场景
经典使用场景
该数据集专为学术论文关键词提取任务而设计,涵盖了文本、图像和音频三种模态的信息,每一份样本均包含论文全文、演讲幻灯片、演讲者音频以及由作者标注的关键词。研究者可利用此数据集评估不同模态数据(如纯文本、图像OCR文本、语音转录文本)在关键词提取任务中的表现差异,并探索多模态信息融合对模型性能的提升作用。经典用法包括使用无监督方法(如TF-IDF、TextRank)和有监督模型(如CRF、BiLSTM-CRF、BERT-BiLSTM-CRF)进行对比实验,验证多模态文本拼接策略的有效性。该数据集为学术文本挖掘领域提供了一个标准化的多模态基准,填补了关键词提取任务缺乏多模态资源的空白。
解决学术问题
该数据集首要解决了传统关键词提取研究长期依赖单一文本模态、忽略视觉与听觉信息的问题,突破了信息融合不足导致模型表示能力受限的瓶颈。通过系统比较论文文本、图像文本与音频文本在关键词提取中的表现,揭示了不同模态信息在语义捕捉上的互补特性,尤其发现多模态文本拼接可显著提升深度学习模型的预测准确率。其次,该数据集为验证多模态融合方法(如CRF与BERT-BiLSTM-CRF)相较于纯文本基线模型的优越性提供了实证基础,推动了学术文本挖掘从单模态向多模态范式的演进。其构建质量与丰富注释为后续研究提供了可靠的数据支撑,促进了关键词提取算法在信息过载环境下的鲁棒性提升。
衍生相关工作
该数据集的构建直接催生了多模态关键词提取方法学的系列工作,例如基于OCR技术与ASR系统整合的图像与语音文本特征对齐研究,以及利用注意力机制融合跨模态语义的深度学习框架。后续工作进一步借鉴了视频理解领域的方法,如采用视频帧相似度去重与音频切片对齐策略,为多模态学术内容的结构化表示提供了新范式。此外,该数据集启发了将眼动追踪、脑电信号等认知特征融入关键词提取的跨学科研究,拓宽了信息科学与人机交互的交叉领域。在学术文本挖掘方向,该数据集推动了从浅层统计模型(如TF-IDF)到预训练语言模型(如BERT)在多模态场景下的适配与优化,为开放域关键词提取任务的演进奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

