
fosters/ernest_heminguei_stary_chalavek_i_mora_output
收藏官方服务:
资源简介:
这是一个由AudioSetPipeline发布的分片数据集导出,基于AudioSet数据集的管道处理输出。
This is a shard-based dataset export published by AudioSetPipeline, representing the pipeline output from the AudioSet dataset.
提供机构:
fosters搜集汇总
数据集介绍
构建方式
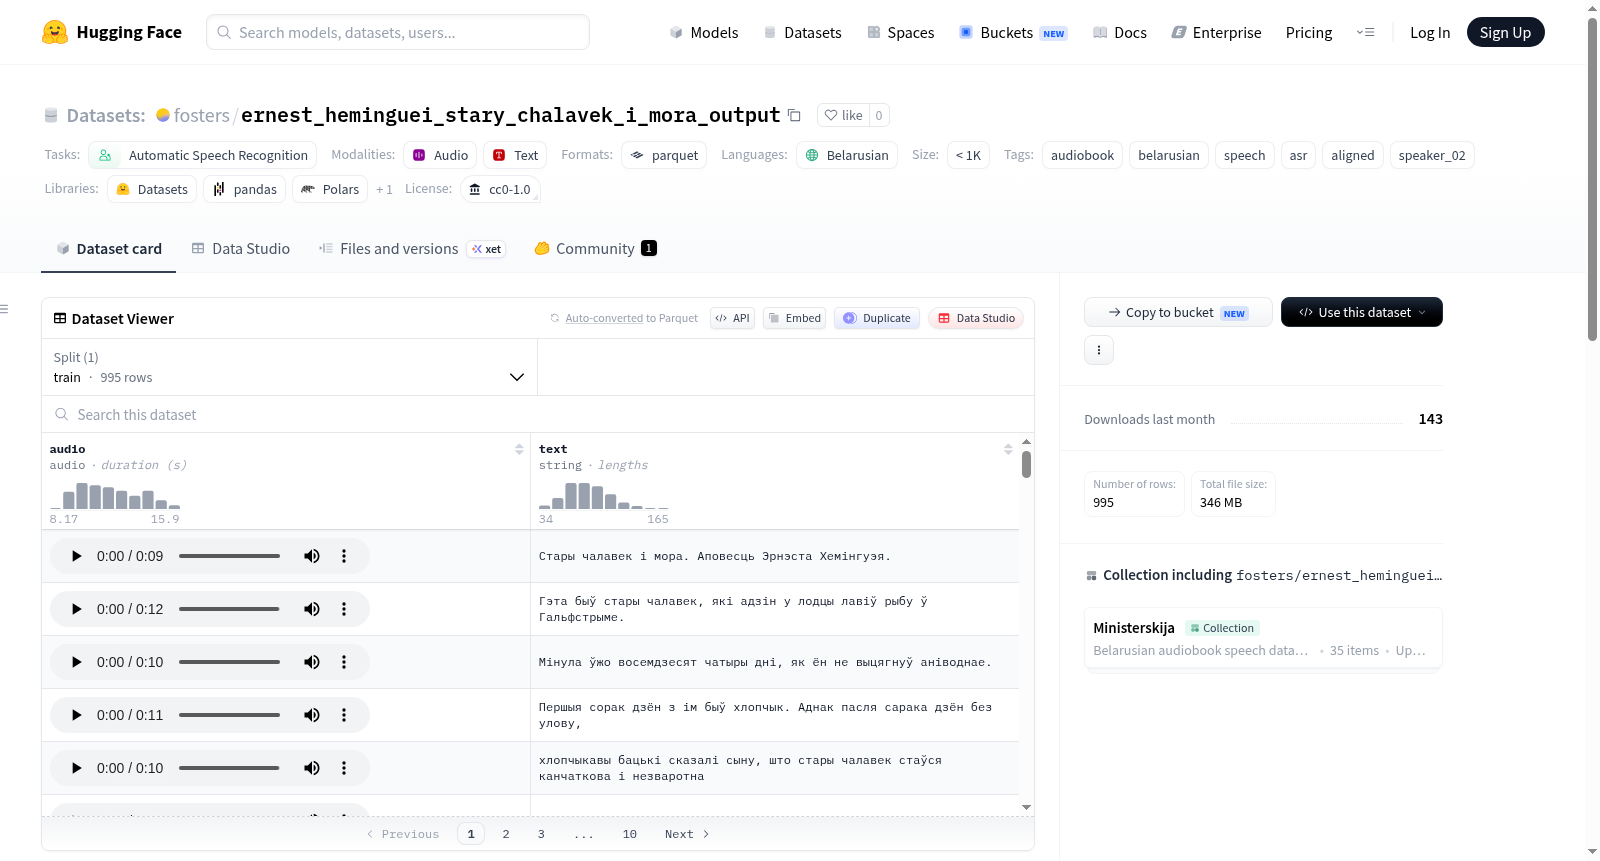
该数据集源自白俄罗斯语有声读物《Стары чалавек і мора》(老人与海),由Эрнэст Хемінгуэй所著。构建过程中,原始音频被切割为约15秒的短片段,随后利用Gemini模型与两套独立的自动语音识别(ASR)系统进行对齐处理,确保每一音频片段与其对应文本转录高度匹配。所有片段均经过置信度筛选,仅保留对齐置信度不低于0.95的高质量数据,最终形成包含995条已发布样本、总计约4小时30分钟音频的资源集合。
特点
该数据集以白俄罗斯语语音识别为核心,具有鲜明的语言与文化特色。其独特之处在于所有数据均源自同一朗读者(Speaker_02),且通过WavLM-Base+模型进行声纹相似度评估,平均相似度高达0.933,确保了语音风格的一致性。此外,数据集与另一白俄罗斯语音频书数据集(kuzma_chorny_poshuki_buduchyni_output)高度相似(相似度0.97),便于多作品联合训练或跨域迁移学习。
使用方法
数据集适用于白俄罗斯语自动语音识别(ASR)模型的训练与评估。每条记录包含音频文件(audio)、对应文本转录(text)及唯一片段标识符(chunk_uid),可直接用于监督学习任务。研究人员可基于其高置信度片段进行微调,或结合相似数据集扩展训练规模。由于数据采用CC0-1.0许可证,用户可自由使用、修改与发布,无需额外授权。
背景与挑战
背景概述
在低资源语言语音识别研究领域,白俄罗斯语因其语料稀缺而长期处于技术洼地。为此,研究者构建了《Стары чалавек і мора》白俄罗斯语音频书数据集,旨在填补该语言在自动语音识别(ASR)任务中的数据空白。该数据集由作者fosters团队于2024年创建,源自Ministerskija收藏系列,通过将欧内斯特·海明威的经典作品《老人与海》白俄罗斯语译本进行精细语音转录与对齐,形成了包含995条公开发布样本、总计4小时30分钟音频的高质量语料库。数据集的发布显著提升了白俄罗斯语ASR模型的训练基础,为低资源语言的语音技术发展提供了关键支撑,并推动了多语种语音研究社区的生态建设。
当前挑战
该数据集所面临的核心挑战在于白俄罗斯语作为低资源语言,其语音识别系统长期受限于数据稀疏与标注标准缺失。具体而言,领域挑战包括:如何在仅有少量公开音频数据的情况下,训练出具备良好泛化能力的端到端ASR模型,并克服白俄罗斯语独特的音韵与语调特征带来的识别困难。在数据集构建过程中,挑战体现为:音频需先分割为约15秒的片段,再使用基于Gemini的转录与两套独立ASR系统进行对齐,期间需确保置信度评分不低于0.95的高阈值,以避免低质量标注的引入;同时,说话人身份通过WavLM-Base+模型进行聚类验证,在平均相似度0.933的条件下,仍需精细区分同一朗读者与不同说话人之间的声学差异,进一步增加了数据清洗与对齐的复杂度。
常用场景
经典使用场景
该数据集源自白俄罗斯语经典文学作品《老人与海》的有声书,其核心用途在于为自动语音识别(ASR)系统提供高质量、细粒度的对齐语料。每条数据包含时长约15秒的音频片段及其对应的文字转录,经过Gemini模型与双独立ASR系统的联合校准,对齐置信度高达0.95以上。研究者常以此作为基准,评估和提升低资源语言(如白俄罗斯语)的语音识别性能,尤其关注长时音频的分割与精准对齐技术。
衍生相关工作
该数据集是Ministerskija语料库集合的一部分,其构建方法——即结合大型语言模型与ASR系统的对齐策略——启发了后续一系列低资源语言语音语料的创建。相关的经典工作包括:基于WavLM-Base+模型进行的说话人聚类分析(如识别出'repka_speaker_02'系列),以及利用该数据集验证跨说话人语音特征迁移的有效性。还衍生出对白俄罗斯语其他文学作品(如库兹马·乔尔内的《未来的探索》)进行类似处理的研究,形成了统一的白俄罗斯语音语料生产流水线。
数据集最近研究
最新研究方向
白俄罗斯语语音识别与有声书语料对齐技术的前沿探索。该数据集《Стары чалавек і мора》聚焦于低资源语言——白俄罗斯语的自动语音识别(ASR)领域,通过利用Gemini模型及双ASR系统对语音与文本进行高置信度(≥0.95)强制对齐,为白俄罗斯语的自然语言处理研究提供了稀缺的、标注精准的语音资源。其独特的说话人聚类(speaker_02)分析,基于WavLM模型进行声纹相似度验证,不仅推动了多说话人场景下的语料泛化研究,更在全球语言多样性保护的热点议题下,强化了濒危语言数字化存续的实践意义。这一进展为构建跨语种语音理解系统与低资源ASR基准测试树立了典范。
以上内容由遇见数据集搜集并总结生成


