
ardauzunoglu/dpo_rpo_smollm2_17b_grpo_0524_ckpt600_fasttext_eli5_c4_lowq_200m2b_subsample20m_grpo_prompt
收藏数据链接:
官方服务:
资源简介:
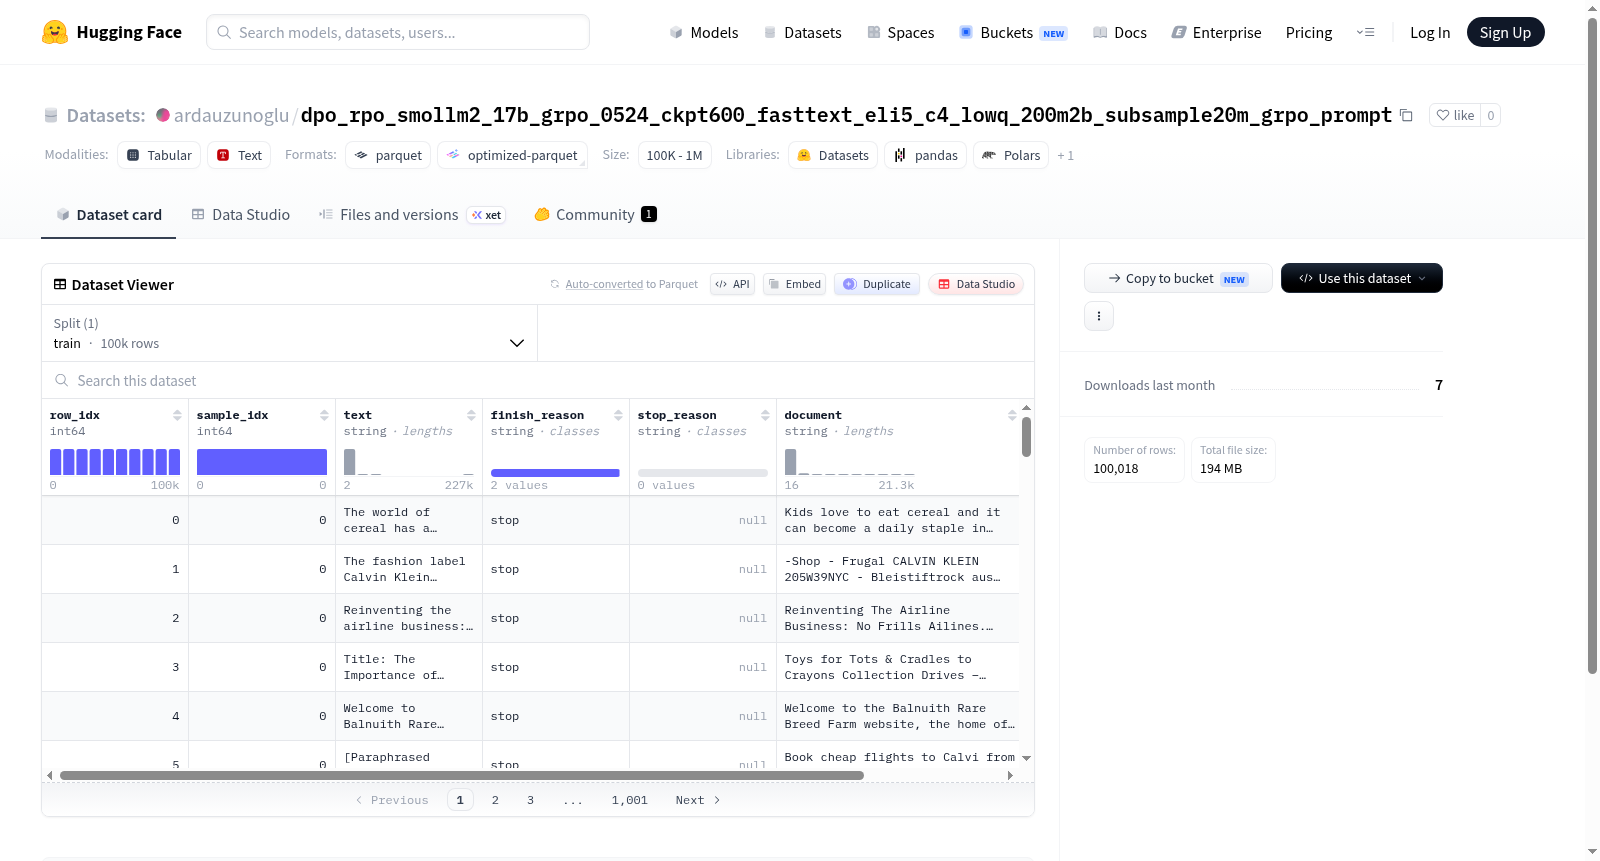
该数据集是一个文本生成相关数据集,包含100,018个训练样本,每个样本具有多个特征字段,如行索引、样本索引、文本内容、完成原因、停止原因、文档引用和提示词计数。数据集可能用于自然语言处理任务,特别是大型语言模型的生成过程分析或训练,涉及文本生成的控制因素(如停止条件)和元数据记录。文件总大小约为341MB,下载大小约为194MB。
This dataset is related to text generation, containing 100,018 training samples with multiple feature fields such as row index, sample index, text content, finish reason, stop reason, document reference, and prompt token count. It is likely used for natural language processing tasks, particularly for analyzing or training large language models, involving control factors in text generation (e.g., stop conditions) and metadata recording. The total file size is approximately 341MB, with a download size of about 194MB.
提供机构:
ardauzunoglu搜集汇总
数据集介绍
构建方式
该数据集源于对SmolLM2-1.7B模型进行GRPO(Group Relative Policy Optimization)强化学习训练过程中的检查点采样,具体选取了第600步的模型输出。通过整合FastText文本分类、ELI5问答数据、C4语料库中的低质量片段,以及200M至2B参数规模模型的子采样策略,最终从2000万条候选数据中筛选出约10万条高质量样本。数据构建融合了多种数据源,并采用GRPO提示模板进行格式化处理,确保每个样本包含原始文本、生成原因及停止原因等结构化字段。
使用方法
数据集采用HuggingFace Datasets库加载,默认配置为'train'分片,支持直接通过data_files参数指定路径,以parquet或arrow格式读取。用户可基于'text'字段进行语言模型微调或强化学习奖励建模,利用'document'字段追溯原始上下文。此外,'prompt_token_count'字段可用于分析不同长度提示对生成结果的影响,而'finish_reason'与'stop_reason'则适合用于训练终止条件预测或生成质量评估任务。建议在加载时启用流式模式以处理大规模迭代场景。
背景与挑战
背景概述
该数据集由HuggingFace团队于2024年5月创建,旨在服务于大规模语言模型的偏好对齐与强化学习训练,核心研究问题在于如何通过合成数据与奖励模型优化模型输出质量。数据集基于FastText嵌入筛选,结合ELI5与C4数据集中的低质量文本子集,并经过20M样本的二次抽样,最终形成约10万条训练样本。其设计紧密围绕DPO(直接偏好优化)与GRPO(基于组奖励的策略优化)算法,为小型语言模型(如SmolLM2-1.7B)的微调提供了高质量偏好数据。该数据集在偏好对齐与高效训练领域具有显著影响力,推动了从奖励模型构建到策略优化的端到端数据流水线发展。
当前挑战
该数据集面临的领域挑战在于如何从海量互联网文本中精准筛选出反映真实人类偏好的对话对,避免低质量或偏见数据对模型对齐效果的负面影响。构建过程中的具体挑战包括:其一,基于FastText嵌入的相似性检索可能引入语义扭曲,导致生成数据偏离原始分布;其二,ELI5与C4数据集存在噪声标注和领域偏向性,需设计复杂的后处理流程以过滤无关内容;其三,20M的二次抽样策略需平衡数据多样性与算力成本,确保在仅10万条样本下仍能覆盖关键意图场景,这对采样算法的鲁棒性提出了较高要求。
常用场景
经典使用场景
该数据集名为dpo_rpo_smollm2_17b_grpo_0524_ckpt600_fasttext_eli5_c4_lowq_200m2b_subsample20m_grpo_prompt,融合了DPO与RPO算法的训练数据,适用于大规模语言模型的偏好对齐任务。在经典使用场景中,研究者可利用其中的高质量、低困惑度文本样本,对基础模型进行有监督微调,以提升其在开放域问答和文本生成任务中的内容质量与相关性。数据集中的prompt和response组合,为评估和改进模型对人类偏好的遵循能力提供了标准化的训练素材,尤其适合在模型训练阶段引入直射偏好优化方法。
解决学术问题
该数据集有效解决了语言模型在偏好学习中的数据稀缺与分布偏移问题。通过从Eli5和C4等大规模语料中筛选低困惑度的子样本,并结合DPO和RPO算法构建偏好对,它克服了传统人工标注偏好数据的成本高昂和主观偏见。学术界借助此数据集,能够深入研究强化学习从人类反馈与直接偏好优化的一致性差异,探索如何在保持生成多样性的同时优化模型的安全性、真实性和用户满意度,推动了对齐方法从实验环境向实际部署的学术认知跃迁。
实际应用
在实际应用中,该数据集可用于构建更精准的智能问答系统、对话机器人和内容生成平台。例如,科技公司可基于此数据集微调大型语言模型,使其在回答开放域问题时更契合用户意图,减少无益或有害输出。此外,低困惑度子采样策略有助于降低模型在资源受限环境下的推理成本,适用于实时客服、教育辅导等对响应速度和内容质量有高要求的场景,显著提升人机交互的自然性与可信度。
数据集最近研究
最新研究方向
该数据集聚焦于利用直接偏好优化(DPO)与组相对策略优化(GRPO)对语言模型进行对齐微调,融合了FastText语义嵌入与低质量文本过滤策略,旨在提升小规模模型(SmolLM2-1.7B)在生成任务中的可靠性与可控性。当前前沿研究正围绕如何通过混合奖励信号与多样性采样(如ELI5、C4子集)缓解模型幻觉与重复生成,这一方向与近期热点——轻量级模型的高效对齐和部署紧密相关,为资源受限场景下的安全AI应用提供了新范式。
以上内容由遇见数据集搜集并总结生成


